
DeepSeek AI хранит чаты в 7 уровнях JSON: как извлечь 5 000+ сообщений за 10 минут
DeepSeek AI хранит историю чатов в формате JSON, и при объёме свыше 5 000 сообщений скопировать текст вручную невозможно, но открытая утилита позволяет извлечь всё за несколько минут.
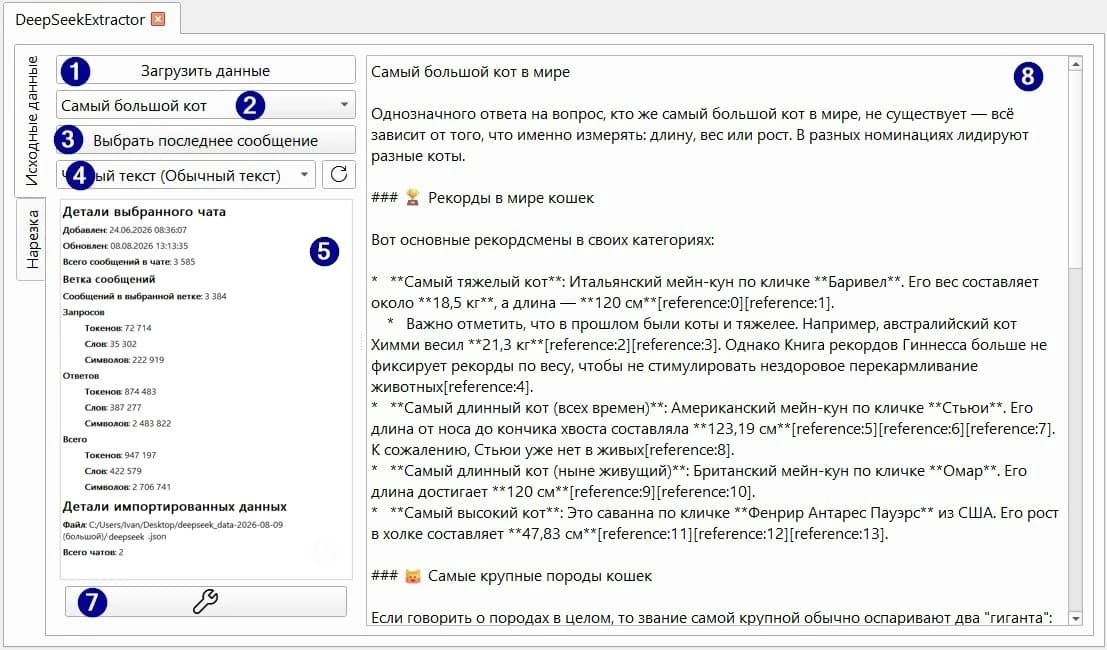
Штатный экспорт DeepSeek AI отдаёт один файл conversations.json, который при большой переписке весит десятки мегабайт и содержит свыше 56 000 вложенных узлов. Без понимания структуры и инструмента для парсинга эти данные бесполезны.
Стандартные визуализаторы JSON не справляются с такими объёмами. Например, расширение JSON Crack для VS Code отказывается работать с файлами, где больше 1 500 узлов. Автор утилиты, разработчик Балакирев, разобрал структуру бэкапа с нуля, потому что официальной документации по формату экспорта DeepSeek AI не существует. Ниже полный разбор: от скачивания архива до готового текста всех ваших диалогов.
Что понадобится?
- Аккаунт DeepSeek AI с историей чатов, которую нужно сохранить
- Текстовый редактор с подсветкой JSON, подойдёт VS Code (бесплатный) или любой аналог
- Python 3.x или другой язык, на котором напишете скрипт обработки (примеры ниже на псевдокоде, логика универсальна)
- 10 минут на скачивание и запуск, плюс время на обработку в зависимости от объёма переписки
Как устроен файл conversations.json?
Прежде чем извлекать текст, полезно понять, что внутри. Файл имеет семь уровней вложенности, но организован логично.
Уровень 1. Весь файл это массив чатов:
[<объект чата 1>, <объект чата 2>, ... <объект чата N>]
Уровень 2. Каждый чат содержит пять полей:
id— уникальный идентификатор чатаtitle— заголовок, присвоённый автоматически или изменённый вамиinserted_at— дата создания в формате ISO 8601 (международный стандарт записи даты и времени)updated_at— дата последнего обновленияmapping— объект со всеми сообщениями
Уровень 3. Объект mapping хранит сообщения не простым списком, а в виде дерева. Первый элемент называется root и указывает на начало чата. Остальные сообщения имеют числовые идентификаторы в виде строк. Нумерация не последовательная: после сообщения 100 может идти сообщение 125. Каждое сообщение хранит ссылку на родительский и дочерние элементы.
Уровень 4. Объект сообщения:
{
  "id": "1",
  "parent": "root",
  "children": [2, 3],
  "message": { ... }
}
Поле children содержит список дочерних сообщений в виде целых чисел, а parent и id записаны строками. Это важно учитывать при парсинге (автоматическом разборе структуры): типы данных разные.
Уровень 5. Детали сообщения включают:
model— какая модель обработала запрос:deepseek-chatилиdeepseek-reasoner(рассуждающая модель, которая показывает ход мысли)inserted_at— дата добавленияfragments— список фрагментов с контентом
Уровень 6. Фрагменты сообщения. Тип фрагмента определяется полем type:
REQUEST— ваш промпт (запрос к нейросети)RESPONSE— ответ моделиTHINK— «размышление» модели (отображается у рассуждающих моделей)SEARCHилиTOOL_SEARCH— результаты поиска в интернетеTOOL_OPEN— служебный тип, полезной информации не несёт
Текст хранится в поле content. Результаты поиска хранятся в поле results.
Уровень 7. Каждый результат поиска содержит url и title найденной страницы.
Пошаговая инструкция
-
Откройте настройки аккаунта DeepSeek AI и найдите функцию экспорта данных. Скачайте архив с историей переписки. Внутри будет файл
conversations.json. -
Откройте файл в текстовом редакторе и убедитесь, что он валидный (не повреждён). Если файл небольшой (до нескольких тысяч узлов), можно использовать расширение JSON Crack для VS Code для визуального просмотра. Для больших файлов этот шаг пропустите, визуализатор не потянет.
-
Напишите скрипт обработки. Логика работы:
для каждого чата в файле:
    вывести заголовок чата (поле "title")
    вывести дату создания (поле "inserted_at")

    для каждого сообщения в чате["mapping"]:
        пропустить "root" (это служебный узел)

        для каждого фрагмента в сообщении["message"]["fragments"]:
            если тип == "REQUEST":
                вывести "Пользователь: " + content
            если тип == "RESPONSE":
                вывести "DeepSeek: " + content
            если тип == "THINK":
                вывести "Размышление: " + content
            если тип == "SEARCH":
                вывести список найденных URL
-
Учтите древовидную структуру. Сообщения связаны через
parentиchildren. Если вам нужен линейный порядок диалога, стройте цепочку отrootвниз по первому дочернему элементу каждого узла. Если нужны все ветки (например, вы задавали альтернативные вопросы), обходите дерево рекурсивно. -
Сохраните результат в текстовый файл или Markdown. Готово: у вас полная история переписки в читаемом виде.
Вход: файл conversations.json весом 20 Мбайт, содержащий больше 5 000 сообщений и более 56 000 узлов.
Обработка: скрипт проходит по каждому чату, разворачивает дерево сообщений, извлекает поля content из фрагментов с типами REQUEST, RESPONSE и THINK.
Выход: текстовый файл, где каждый диалог озаглавлен, датирован и содержит полный текст всех запросов и ответов в хронологическом порядке. Результаты поиска (тип SEARCH) идут отдельным блоком со ссылками.
Не учитывают разные типы данных в children и parent. Поле parent записано строкой ("root", "1"), а children содержит целые числа ([2, 3]). Если сравнивать напрямую без приведения типов, цепочка сообщений порвётся.
Ожидают последовательную нумерацию. Сообщения нумеруются с пропусками: после 100 может идти 125. Не перебирайте по порядку от 1 до N, а читайте ключи из объекта mapping.
Забывают про ветвление. Чат DeepSeek AI имеет древовидную, а не линейную структуру. Одно сообщение может иметь несколько дочерних. Если вы берёте только первый дочерний элемент, часть переписки потеряется.
Пытаются открыть большой файл визуализатором. JSON Crack и аналогичные расширения обычно ограничены 1 500 узлами. Файл на 56 000 узлов нужно обрабатывать программно.
Не учитывают вложения. Разобранная структура не покрывает прикреплённые файлы. Если в чатах были документы или изображения, для их извлечения потребуется доработка скрипта.
Что делать с этим прямо сейчас?
Автору на Дзене. Если вы вели длинные диалоги с DeepSeek AI для подготовки материалов, исследования тем или генерации черновиков, теперь можно достать весь текст и переработать его в статьи. Не нужно листать бесконечный чат и копировать по кусочку.
Маркетологу. Экспортированные диалоги это готовая база промптов, которые сработали. Извлеките пары «запрос плюс ответ», соберите библиотеку рабочих промптов для команды.
Предпринимателю в РФ. DeepSeek AI доступен из России. Если у вас или у сотрудников накопились рабочие переписки с нейросетью (анализ рынка, подготовка документов, мозговые штурмы), экспорт и парсинг позволят сохранить эти данные вне платформы. Это вопрос и удобства, и контроля над информацией.
Подход автора ценен тем, что он задокументировал структуру, которую сам DeepSeek AI нигде публично не описывает. По моим наблюдениям, большинство нейросетевых платформ относятся к экспорту данных по остаточному принципу: функция есть, а документации нет. Разбор Балакирева фактически стал неофициальной спецификацией формата.
Честная оговорка: структура файла может измениться при любом обновлении платформы без предупреждения. Скрипт, написанный сегодня, завтра может сломаться. Кроме того, вложения (прикреплённые файлы) в разборе не рассмотрены, если вы активно отправляли документы в чат, часть данных останется неизвлечённой.
Я бы рекомендовал сделать экспорт прямо сейчас и сохранить как сырой JSON, так и обработанный текст. Даже если скрипт придётся обновить, исходный файл у вас уже будет.
Бесплатные промпты для авторов Дзена
Собрали рабочие промпты для написания статей, заголовков и планов контента. Работают с DeepSeek AI, YandexGPT и другими моделями.
Забрать промптыЭкспорт данных из нейросети это не техническая прихоть, а базовая гигиена для любого, кто использует ИИ в работе. Пока DeepSeek AI не предложит встроенный инструмент экспорта в читаемый формат, разбирайте JSON сами, теперь вы знаете, что внутри.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Сверхинтеллект ИИ: пять сценариев до 2040 года и место России в каждом из них
Материал перед нами не новость о событии, а авторский обзор сценариев развития сверхинтеллекта, собранный из нескольких источников разного времени. Архетип…
Claude Code AI как исполнитель: протокол, который превращает заброшенные проекты в рабочие
Claude Code превращает заброшенные проекты в рабочие: протокол для разработчика, который привык делать всё сам. Почему это важно Опыт показывает: проблема не в…
Разработка логотипа с помощью нейросети ни при чём: джун с ИИ против сеньора в битве за код
Разработка логотипа с помощью нейросети тут ни при чём: речь о коде, и ставки выше, чем кажутся. Канал «Вайбкодер» предложил эксперимент, который наконец…
Комментарии