
Иски издательств к OpenAI и Microsoft
Microsoft и OpenAI получили ещё два иска от изданий: The Seattle Times и Newsday обвинили компании в уничтожении журналистики ради обучающих данных (training data, тексты, на которых учат нейросеть), причём The Seattle Times до этого принимала гранты от обоих ответчиков.
Иски к OpenAI (openai lawsuits) множатся с 2023 года, и каждый новый расширяет доказательную базу для всей отрасли: аргументы из американских дел уже становятся шаблоном для споров об авторских правах в других юрисдикциях, включая Россию.
Волну судебных претензий к OpenAI и Microsoft начала The New York Times в 2023 году, обвинив обе компании в нарушении авторских прав. С тех пор к ней присоединились другие издания. Новый иск The Seattle Times и Newsday зафиксировал самый жёсткий на сегодня язык: истцы назвали генеративный ИИ «змеёй, пожирающей собственный хвост», которая способна «уничтожить сами организации», чей контент она потребляет. Об иске сообщило издание GeekWire.
| Что | Когда | Кто подал | Ответчики |
|---|---|---|---|
| Иск о нарушении авторских прав на журналистские материалы | Дата подачи не раскрыта, стало известно в июне 2025 | The Seattle Times и Newsday | OpenAI и Microsoft |
Почему иск The Seattle Times бьёт сильнее остальных?
The Seattle Times до подачи иска получала финансирование от обоих ответчиков. Microsoft и OpenAI спонсировали журналистские проекты и стипендиальные программы издания. Теперь то же издание обвиняет спонсоров в том, что их ИИ-продукты «пожирают авторский контент и возвращают миру копии и производные имитации оригинала».
Представитель Microsoft заявил GeekWire, что компания «удивлена иском», но «всегда готова сесть за стол и обсудить решения подобных споров». OpenAI публичных комментариев по этому иску не давала.
Главные аргументы истцов
- Журналистика под угрозой. Иск прямо заявляет: с появлением ИИ индустрия журналистики может быть «сломана безвозвратно».
- Генеративный ИИ назван потребителем, а не создателем. Истцы подчёркивают: ChatGPT и Copilot позиционируются как производители контента, но на деле они «ненасытные потребители», которые поглощают тексты людей ради коммерческих целей.
- Прецедент The New York Times. Иск 2023 года до сих пор рассматривается, и каждое новое дело расширяет линейку правовых аргументов против OpenAI и Microsoft (openai lawsuits).
Что это значит для российских авторов и издателей?
Прямого аналога этих исков в российской практике пока нет, но юридическая логика переносима. Вот что полезно знать каждой аудитории.
- Авторам Дзена. Ваши тексты тоже могут попадать в обучающие данные нейросетей. Аргумент из иска, что ИИ выдаёт «производные имитации оригинала», применим к любому автору, не только к крупным изданиям. Сохраняйте даты публикаций и скриншоты: это минимальная фиксация авторства.
- Маркетологам. Если вы используете ChatGPT или Copilot для генерации текстов, учитывайте риск: сгенерированный контент может воспроизводить фрагменты чужих материалов, и ответственность за публикацию лежит на вас.
- Предпринимателям в РФ и СНГ. Российское законодательство об авторском праве (часть IV ГК РФ) защищает оригинальные тексты без регистрации. Аргументы из американских исков, особенно про коммерческое использование чужого контента без лицензии, могут лечь в основу будущих российских дел. Следите за практикой.
Российские нейросети и авторское право
В России работают собственные генеративные модели: YandexGPT (Яндекс) и GigaChat (Сбер). Обе обучены, в том числе, на русскоязычных текстах. Публичных исков к ним от российских издательств пока не было. Но сам факт, что американские суды рассматривают десятки дел против OpenAI, создаёт правовую рамку, на которую российские правообладатели смогут ссылаться.
Каждый новый иск к OpenAI и Microsoft делает позицию авторов чуть крепче, даже если вы пишете не для The New York Times, а для канала на Дзене. Я слежу за этими делами с 2023 года, и вижу: суды пока не вынесли окончательных решений, поэтому говорить о победе рано. Но аргументы из исков уже сейчас стоит читать как инструкцию: что фиксировать (дату, платформу, текст), как формулировать претензию (коммерческое использование без лицензии) и на что ссылаться. Сделайте сегодня одно действие: проверьте, стоит ли на ваших публикациях явное указание на запрет использования для обучения ИИ. Это не гарантия, но это аргумент в будущем споре.
Частые вопросы
Могу ли я подать иск, если мой текст использовали для обучения нейросети?
Формально да, если вы автор оригинального текста, российское право защищает его автоматически. На практике главная сложность: доказать, что конкретная модель обучалась именно на вашем материале. Американские истцы решают эту задачу, показывая, что ИИ воспроизводит фрагменты их текстов. В России такой судебной практики пока нет.
Затронут ли эти иски доступ к ChatGPT?
Пока нет. Иски требуют компенсации и прекращения использования контента, но не блокировки сервисов. Даже если суд встанет на сторону истцов, это скорее приведёт к лицензионным соглашениям с издателями, чем к отключению ChatGPT.
Чем иск The Seattle Times отличается от иска The New York Times?
Главное отличие: The Seattle Times получала деньги от Microsoft и OpenAI на журналистские проекты, а теперь судится с ними. Это усиливает моральный аргумент, но юридически оба иска строятся на одной базе: нарушение авторских прав через использование контента в обучающих данных без разрешения.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
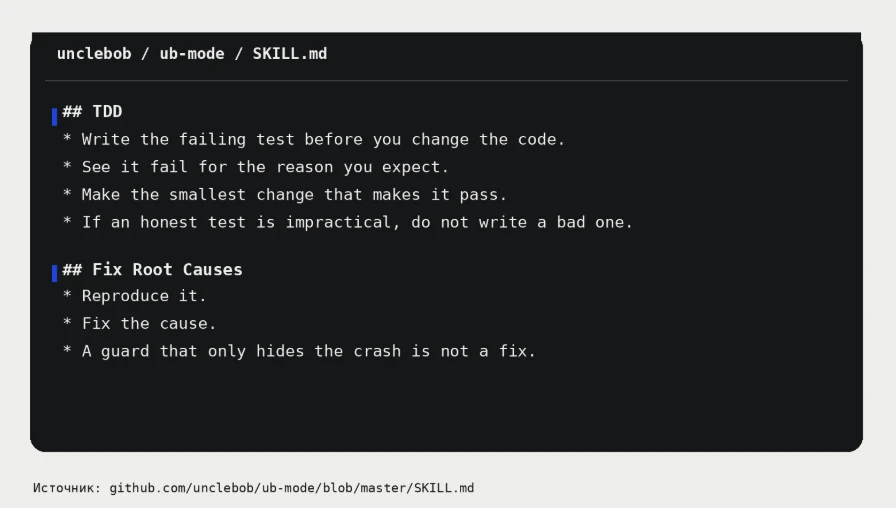
Дядя Боб уместил правила для ИИ-агента в 750 слов: «готово» без теста не принимается
Роберт Мартин, автор книги «Чистый код», на днях выложил в открытый доступ ub-mode, свод правил для нейросетей, которые сами пишут код, и теперь агент обязан…
Nvidia открыла бесплатную модель распознавания речи на 40 языков: хватит одного чипа
Nvidia выпустила бесплатную открытую модель Nemotron 3.5 Transcribe для распознавания речи до 40 языков в разгар волны голосовых релизов, когда Mistral,…
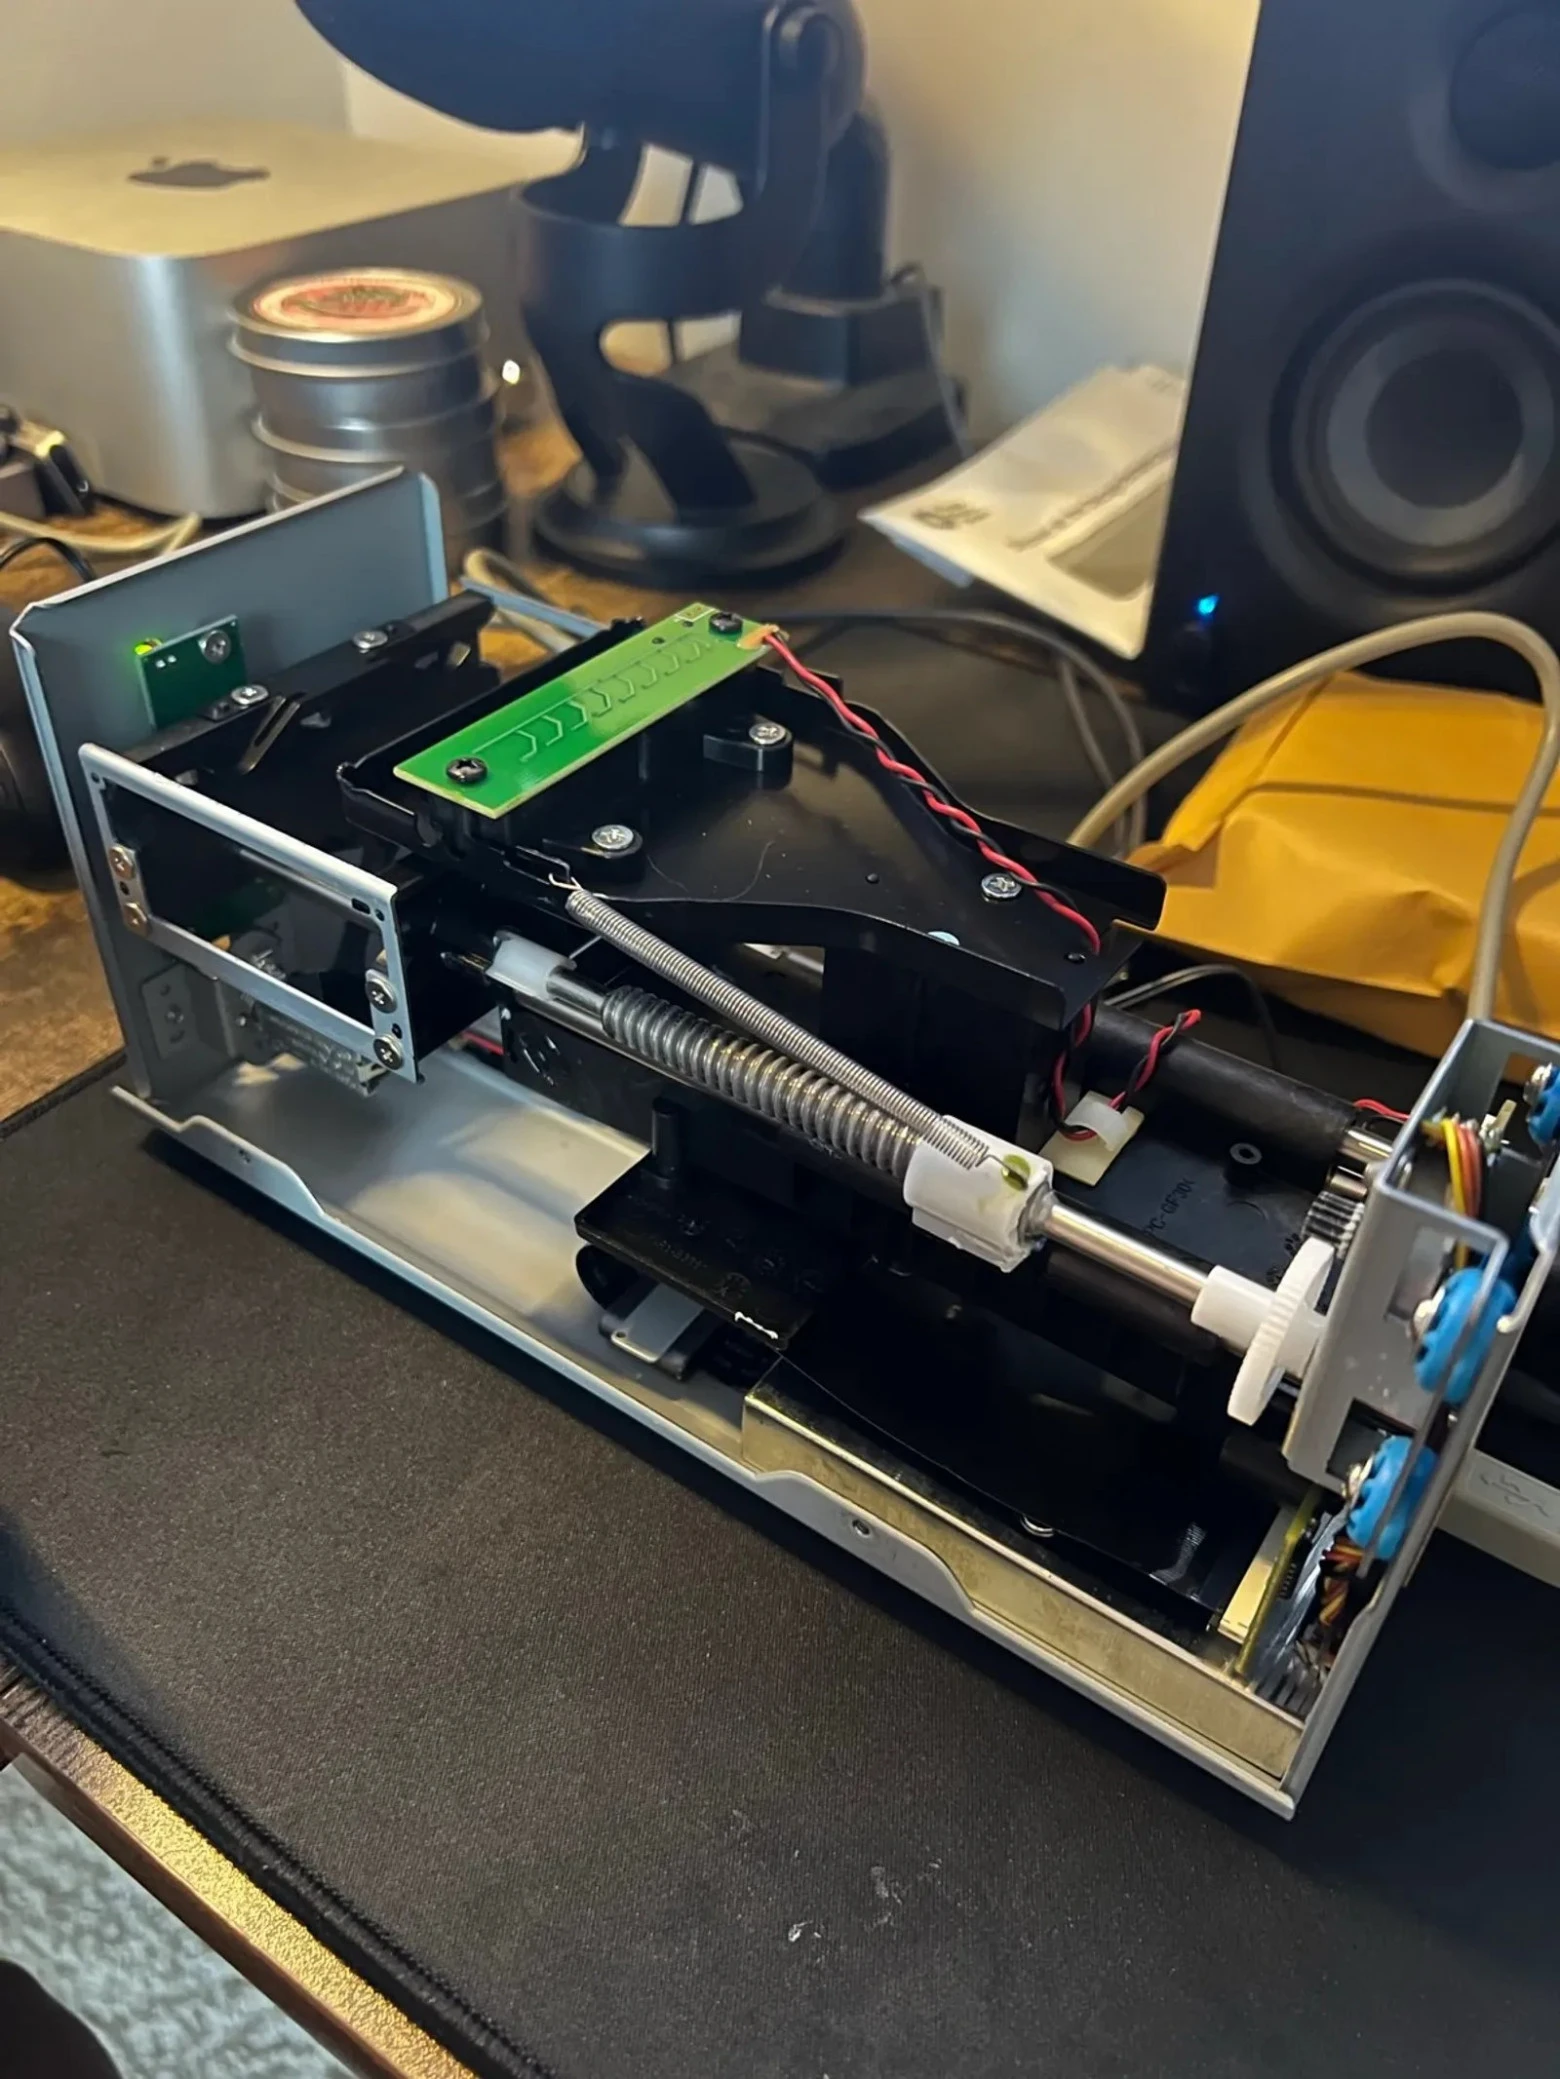
Фотограф автоматизировал оцифровку плёнки 35 мм с Claude: 4 часа обработки ушли в код
Фотограф Shan выложил разбор с перепиской о том, как нейросеть Claude взяла на себя четырёхчасовую обработку плёнки 35 мм, включая аварию со сканером, и это…
Комментарии