
ИИ-модели для принятия решений без токенов: Jev выбирает действие за один вызов API
Вы разрабатываете ИИ-агентов или автоматизируете поддержку и каждый раз выбираете между тупым if/else и дорогим вызовом большой языковой модели: Jev от TypeSafe закрывает этот зазор, принимая решения с вероятностями без генерации текста и без оплаты за рассуждения.
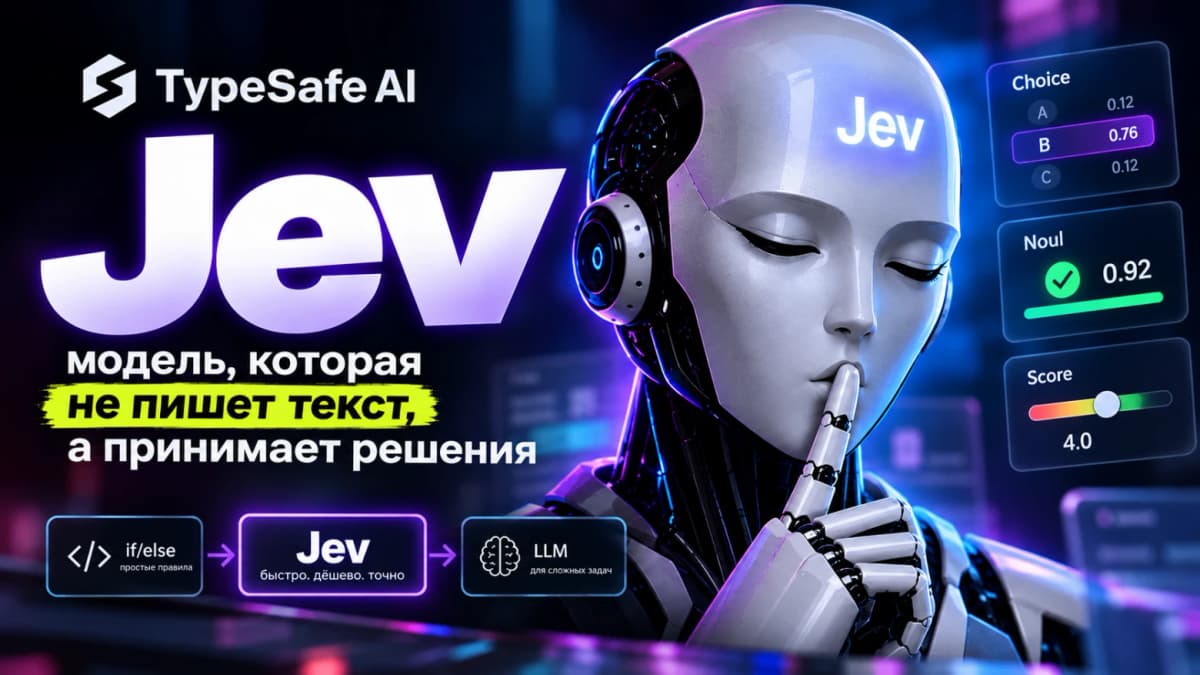
Jev физически не возвращает свободный текст, только типизированный выбор с распределением вероятностей, поэтому галлюцинации (когда модель уверенно выдумывает несуществующее действие) исключены на уровне архитектуры, а не промпта.
Модель Jev, которую выпустила компания TypeSafe под названием System One, занимает нишу, которую до сих пор закрывали костылями. Жёсткие правила if/else не понимают контекст и ломаются от перестановки слов. Большие языковые модели понимают контекст, но каждый вызов стоит денег и занимает секунды. Jev работает между этими крайностями: принимает решения с пониманием смысла, но без генерации прозы. Для задач маршрутизации заявок, модерации, классификации на русском языке это означает экономию на токенах и скорость, недоступную рассуждающим моделям.
Что понадобится
- Аккаунт TypeSafe и API-ключ (регистрация на сайте typesafe.ai)
- Node.js версии 18 или новее
- Репозиторий с готовыми скриптами:
https://github.com/gmoreva/jev-scripts - Текстовый редактор и терминал
- Примерно 30 минут на первый запуск и настройку порогов
Пошаговая инструкция
- Клонируйте репозиторий и установите зависимости.
git clone https://github.com/gmoreva/jev-scripts.git
cd jev-scripts
npm install
- Создайте файл
.envи впишите ключ API.
TYPESAFE_API_KEY=ваш_ключ
-
Разберитесь с тремя типами вопросов Jev. Это основа: ИИ модели для принятия решений работают не через свободный промпт (промпт, текстовое задание для модели), а через структурированные вопросы.
-
Choice : «выбери один вариант из предложенных». На выходе ключ опции, полное распределение вероятностей и уровень уверенности.
- Noul : «какова вероятность, что ответ "да"?» Одно число от 0 до 1.
-
Score : «определи положение на шкале». Шкала из 2 до 10 уровней, где каждый уровень описан словами.
-
Соберите батарею вопросов в одном HTTP-вызове. Главная особенность Jev: от 2 до 13 вопросов отправляются параллельно, за один запрос. Вопросы не видят ответы друг друга.
{
  "state": {
    "ticket": {
      "text": "Пользователь жалуется на списание средств"
    }
  },
  "model": "jev-latest",
  "questions": {
    "category": {
      "type": "choice",
      "criteria": {
        "billing": "вопрос связан с оплатой",
        "tech": "техническая проблема",
        "other": "всё остальное"
      }
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "Требуется ли немедленная реакция?"
    },
    "severity": {
      "type": "score",
      "criteria": ["не критично", "неудобство", "блокер", "потеря данных", "финансовый ущерб"]
    }
  }
}
- Отправьте запрос к API.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json
- Обработайте ответ в коде. Jev вернёт для каждого вопроса типизированный результат. Дальше логика простая:
if (response.is_urgent.probability > 0.55) {
  escalateToHuman();
} else {
  routeToQueue(response.category.selected);
}
- Запустите готовое демо для сравнения. В репозитории два скрипта:
agent-jev.js(Jev принимает решения, код владеет циклом) иagent-llm.js(классический агент на большой языковой модели). Запустите оба и сравните результаты.
node agent-jev.js
node agent-llm.js
Автор репозитория поставил обоим агентам одну задачу: найти на сайте ru.trip.com отель в Пекине до 10 000 рублей с завтраком. Агент на Jev выполнил задачу с нулём токенов большой языковой модели: все решения (какой элемент кликнуть, какой вариант автокомплита выбрать, включён ли фильтр завтрака, завершена ли задача) оказались типовыми суждениями, для которых свободный текст не понадобился вообще. Классический агент на чистой LLM (большая языковая модель) решил ту же задачу, но с оплатой каждого шага токенами. Подробные цифры автор приводит в файле REPORT.md внутри репозитория.
Релиз вышел без привязки к конкретному региону, API доступен по HTTP из любой точки, включая Россию, без VPN. Это делает Jev применимой для русскоязычных задач прямо сейчас, без ожидания локализации.
Где это пригодится конкретно вам?
Автору Дзена и копирайтеру. Если вы строите бота, который сортирует комментарии или заявки от читателей, Jev заменит цепочку промптов к ChatGPT одним вызовом. Формулируете варианты («спам», «вопрос по теме», «благодарность»), получаете классификацию с вероятностью. Экономия на токенах ощутима при сотнях сообщений в день.
Маркетологу. Маршрутизация лидов, скоринг заявок, модерация отзывов: все задачи, где нужно быстро и дёшево рассортировать входящий поток по категориям. Jev не требует дообучения (обучение модели на ваших примерах под узкую задачу) для базовых сценариев, достаточно описать варианты словами.
Разработчику и предпринимателю в РФ. API работает без ограничений по региону. Из доступных в России аналогов для классификации можно использовать YandexGPT и GigaChat, но они генерируют текст и берут плату за токены рассуждений. Jev снимает этот слой затрат для задач, где свободный ответ не нужен.
Первые запуски будут падать. Автор демо честно указывает: оба агента (и на Jev, и на LLM) упали по два-три раза на первых прогонах. Пришлось подбирать пороги вероятностей и формулировки вопросов. Это «налог на интеграцию», о котором мало кто пишет.
Jev не импровизирует. Модель работает строго внутри структуры, которую задаёте вы. Если сценарий длинный и непредсказуемый, без подключения полноценной языковой модели на отдельных шагах не обойтись. Jev принимает решения, но не ведёт диалог.
Не путайте Jev с универсальным ИИ-агентом (агентом, который сам планирует и выполняет цепочку действий). Jev не планирует, она отвечает на заданные вами вопросы. Код управления циклом пишете вы сами, и его придётся поддерживать.
ИИ модели для принятия решений закрывают реальную боль: между бесплатным, но хрупким if/else и умным, но дорогим вызовом LLM до сих пор зияла дыра. Jev её заполняет, и по моим наблюдениям, для рутинной классификации и маршрутизации это работает. Но честная оговорка: демо в репозитории показывает один сценарий на одном сайте. Для продакшена понадобится тюнинг порогов, обработка крайних случаев и мониторинг. Начните с одного конкретного процесса (например, сортировка обращений в поддержку), замерьте экономию в токенах и времени, и только потом расширяйте.
Попробуйте ИИ-инструменты для авторов Дзена
Узнайте, как автоматизировать рутину и работать с нейросетями на практике
Перейти на dzen.guruКто строит автоматизацию на больших языковых моделях и каждый месяц смотрит на счёт за токены, попробуйте вынести типовые решения в отдельный слой. Репозиторий открыт, API доступен из России, первый тест занимает полчаса.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Один автор обошёл 2 500 заявок XPRIZE AI и получил $2,5 млн на фильм
Компания Google совместно с XPRIZE AI и Range Media Partners объявила победителя конкурса Future Vision XPRIZE: короткометражный трейлер «The Gifted»…
Google объединил закупку вертикального видео в DV360: охват вырос на 24%
Компания Google запустила в Display & Video 360 функцию Vertical Video Unification, которая позволяет закупать и измерять вертикальное видео…
Google Arts & Culture добавил ИИ-поиск по 3 000 музеев: вопрос вместо каталога
Google Arts & Culture отмечает 15 лет и по этому случаю выпускает обновлённое мобильное приложение с поиском на естественном языке, доступом к архивам…
Комментарии