
ИИ-агенты проваливают бенчмарки: тесты измеряют совместимость с форматом, а не интеллект
Компании тратят миллионы на ИИ-агентов, которые умеют рассуждать, писать код и управлять браузером, но когда дело доходит до стандартизированной оценки, агенты проваливаются на задачах, с которыми справился бы стажёр.
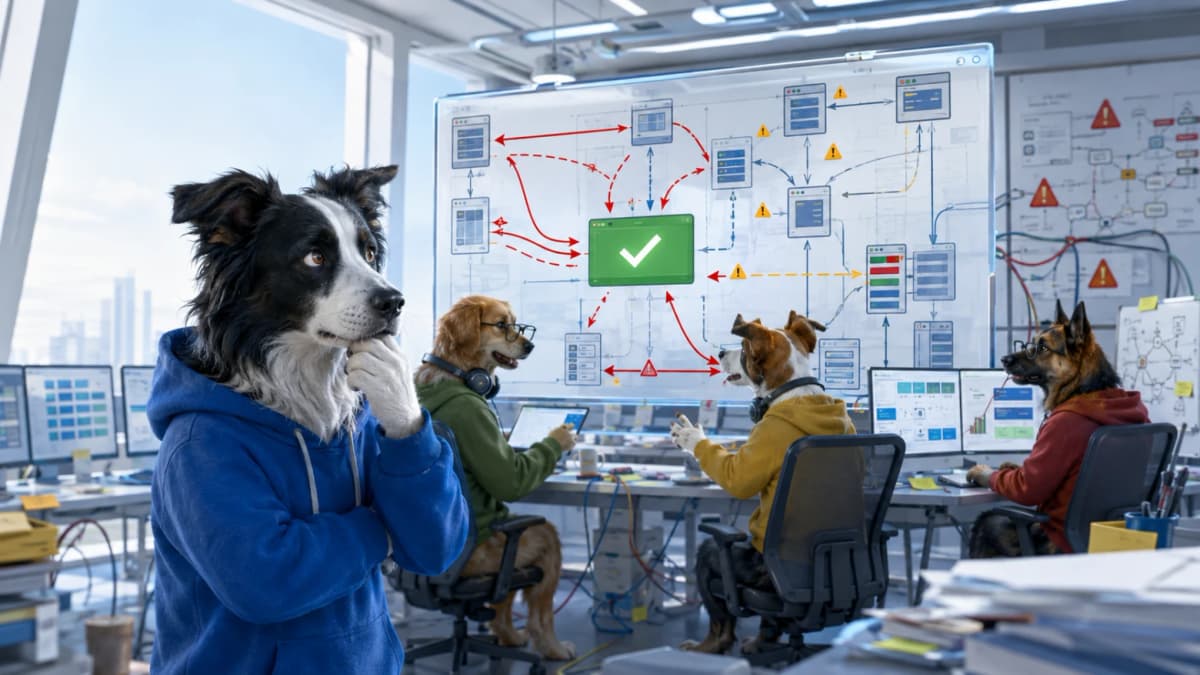
Проблема не в том, что ИИ-агенты глупы, а в том, что способ их тестирования не совпадает с тем, как они реально работают: оценка измеряет не интеллект агента, а его совместимость с форматом теста.
Спор вокруг оценки ИИ-агентов разгорелся после того, как несколько команд независимо опубликовали результаты бенчмарков для агентных систем. Картина оказалась парадоксальной: агенты, которые в реальных пайплайнах (цепочках последовательных действий) справлялись со сложными задачами, на формальных тестах показывали результаты ниже ожидаемых. Для тех, кто в России строит многоагентные решения поверх больших языковых моделей, это не академический курьёз, а практический вопрос: как оценивать то, что вы построили, если стандартные метрики врут?
Почему агенты решают задачу, но проваливают тест?
ИИ-агент (автономная программа, которая сама планирует шаги, вызывает инструменты и принимает промежуточные решения) отличается от обычной модели принципиально. Обычная модель получает промпт и выдаёт ответ за один шаг. Агент работает итерациями: формулирует план, выполняет действие, анализирует результат, корректирует план.
Стандартные бенчмарки построены под одношаговый формат. Они ждут от модели конкретный ответ в конкретном виде. Агент же может прийти к правильному результату нестандартным путём, оформить его иначе или потратить больше шагов, и формальная метрика засчитает это как ошибку.
Вот три ключевых разрыва между реальной работой агента и тем, что измеряет тест:
- Формат ответа. Бенчмарк ожидает строку «42». Агент выдаёт «Ответ: сорок два, потому что…» и получает ноль баллов
- Промежуточные шаги. Тест оценивает финальный результат. Агент мог корректно выполнить 9 из 10 шагов, споткнуться на последнем и потерять 100% балла, хотя 90% работы сделано верно
- Среда выполнения. Агенту нужен доступ к инструментам: браузеру, файловой системе, API. Бенчмарк часто запускается в песочнице, где этих инструментов нет, и агент работает «со связанными руками»
Сильные аргументы в пользу текущих бенчмарков
Сторонники стандартизированных тестов приводят весомые доводы.
Во-первых, без единой шкалы невозможно сравнивать агентов между собой. Если каждая команда оценивает свою систему по собственным критериям, рынок превращается в соревнование маркетинговых заявлений. Бенчмарк, пусть несовершенный, даёт общий язык.
Во-вторых, формальный тест воспроизводим. Любой исследователь может взять тот же набор задач и проверить результат. Субъективная оценка «агент хорошо справился в нашем пайплайне» не проверяема извне.
В-третьих, жёсткие критерии выявляют реальные слабости. Если агент не может оформить ответ в нужном формате, это проблема робастности (устойчивости к изменению условий), а не придирка тестировщика. В продакшене пользователь тоже не будет подстраиваться под капризы модели.
Почему эти аргументы не закрывают вопрос?
Противоположная сторона не менее убедительна.
Агентные системы решают задачи принципиально иного класса, чем те, для которых проектировались существующие бенчмарки. Тест на знание фактов не измеряет способность агента координировать пять инструментов для достижения цели. Это как оценивать работу менеджера проекта по результатам ЕГЭ по математике: корреляция есть, но она слабая.
Фиксированные бенчмарки создают ложные стимулы. Разработчики начинают оптимизировать агента под тест, а не под реальную задачу. Модель учится угадывать формат ответа вместо того, чтобы лучше планировать.
Наконец, бенчмарки устаревают. Задачи, которые год назад были сложными, сегодня решаются тривиально. Новые бенчмарки появляются медленнее, чем развиваются агенты, и оценка всегда отстаёт от реальности.
Мы измеряем способность модели пройти тест, а не способность агента решить проблему. Это разные навыки, и наши бенчмарки пока не научились их различать. : Исследователи, работающие над агентными системами (обобщённая позиция из дискуссий в сообществе)
Что делать тем, кто строит агентов в России?
Для разработчиков многоагентных систем вывод прямой: не полагайтесь на один бенчмарк. Создавайте внутренние тесты, которые повторяют реальные сценарии ваших пользователей, включая доступ к инструментам, многошаговые задачи и вариативность формата ответа.
Авторам и контент-специалистам на Дзене, которые используют ИИ-агентов для автоматизации, стоит помнить: если агент выдал странный результат в одном формате, попробуйте переформулировать задачу. Проблема может быть не в «уме» модели, а в несовпадении ожидаемого формата.
Предпринимателям, которые выбирают между агентными решениями на базе YandexGPT, GigaChat или зарубежных моделей: публичные рейтинги агентов полезны как первый фильтр, но решение о внедрении принимайте только после теста на ваших данных и ваших задачах.
Я считаю, что индустрия попала в ловушку собственных метрик. Мы научились строить ИИ-агентов, которые реально полезны, но продолжаем измерять их линейкой, нарисованной для предыдущего поколения моделей. Это не значит, что бенчмарки не нужны. Нужны другие: те, что оценивают планирование, координацию инструментов, восстановление после ошибки. Пока таких стандартов нет, каждая команда вынуждена строить свою систему оценки. Для тех, кто работает в России, это одновременно проблема (нет ориентира) и возможность (нет чужого потолка). По моим наблюдениям, команды, которые тестируют агентов на реальных пользовательских сценариях, а не на бенчмарках, быстрее выходят в продакшен.
Ближайший год покажет, появится ли открытый стандарт оценки именно агентных систем, а не языковых моделей с агентной обёрткой. Несколько исследовательских групп уже работают над бенчмарками, которые учитывают многошаговость и доступ к инструментам. Пока стандарта нет, единственный надёжный тест для вашего ИИ-агента, это задача вашего пользователя, выполненная от начала до конца, со всеми инструментами и в реальных условиях.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google открыла Gemini и поиск сторонним приложениям: заявку подаст любой разработчик из США
Google открыла американским разработчикам бета-версию Connected Apps Platform, через которую любой бизнес может встроить своё приложение в Gemini и поиск на…
Google открыла Connected Apps Platform: один сервис подключат сразу к Поиску и Gemini
Google открыла предварительный доступ к Connected Apps Platform, единой площадке для встраивания сервисов сразу в Поиск и Gemini, и подключила новых партнёров,…
Google разворачивает ИИ в медицине Сингапура: $7 млн на науку и ИИ-коуч для жителей
Google на саммите Google for Health Summit объявила о развёртывании передового ИИ во всей системе здравоохранения Сингапура, где старение населения…
Комментарии