
Hugging Face выпустила открытую нейросеть по биологии: анализ ДНК в 1800 раз дешевле GPT
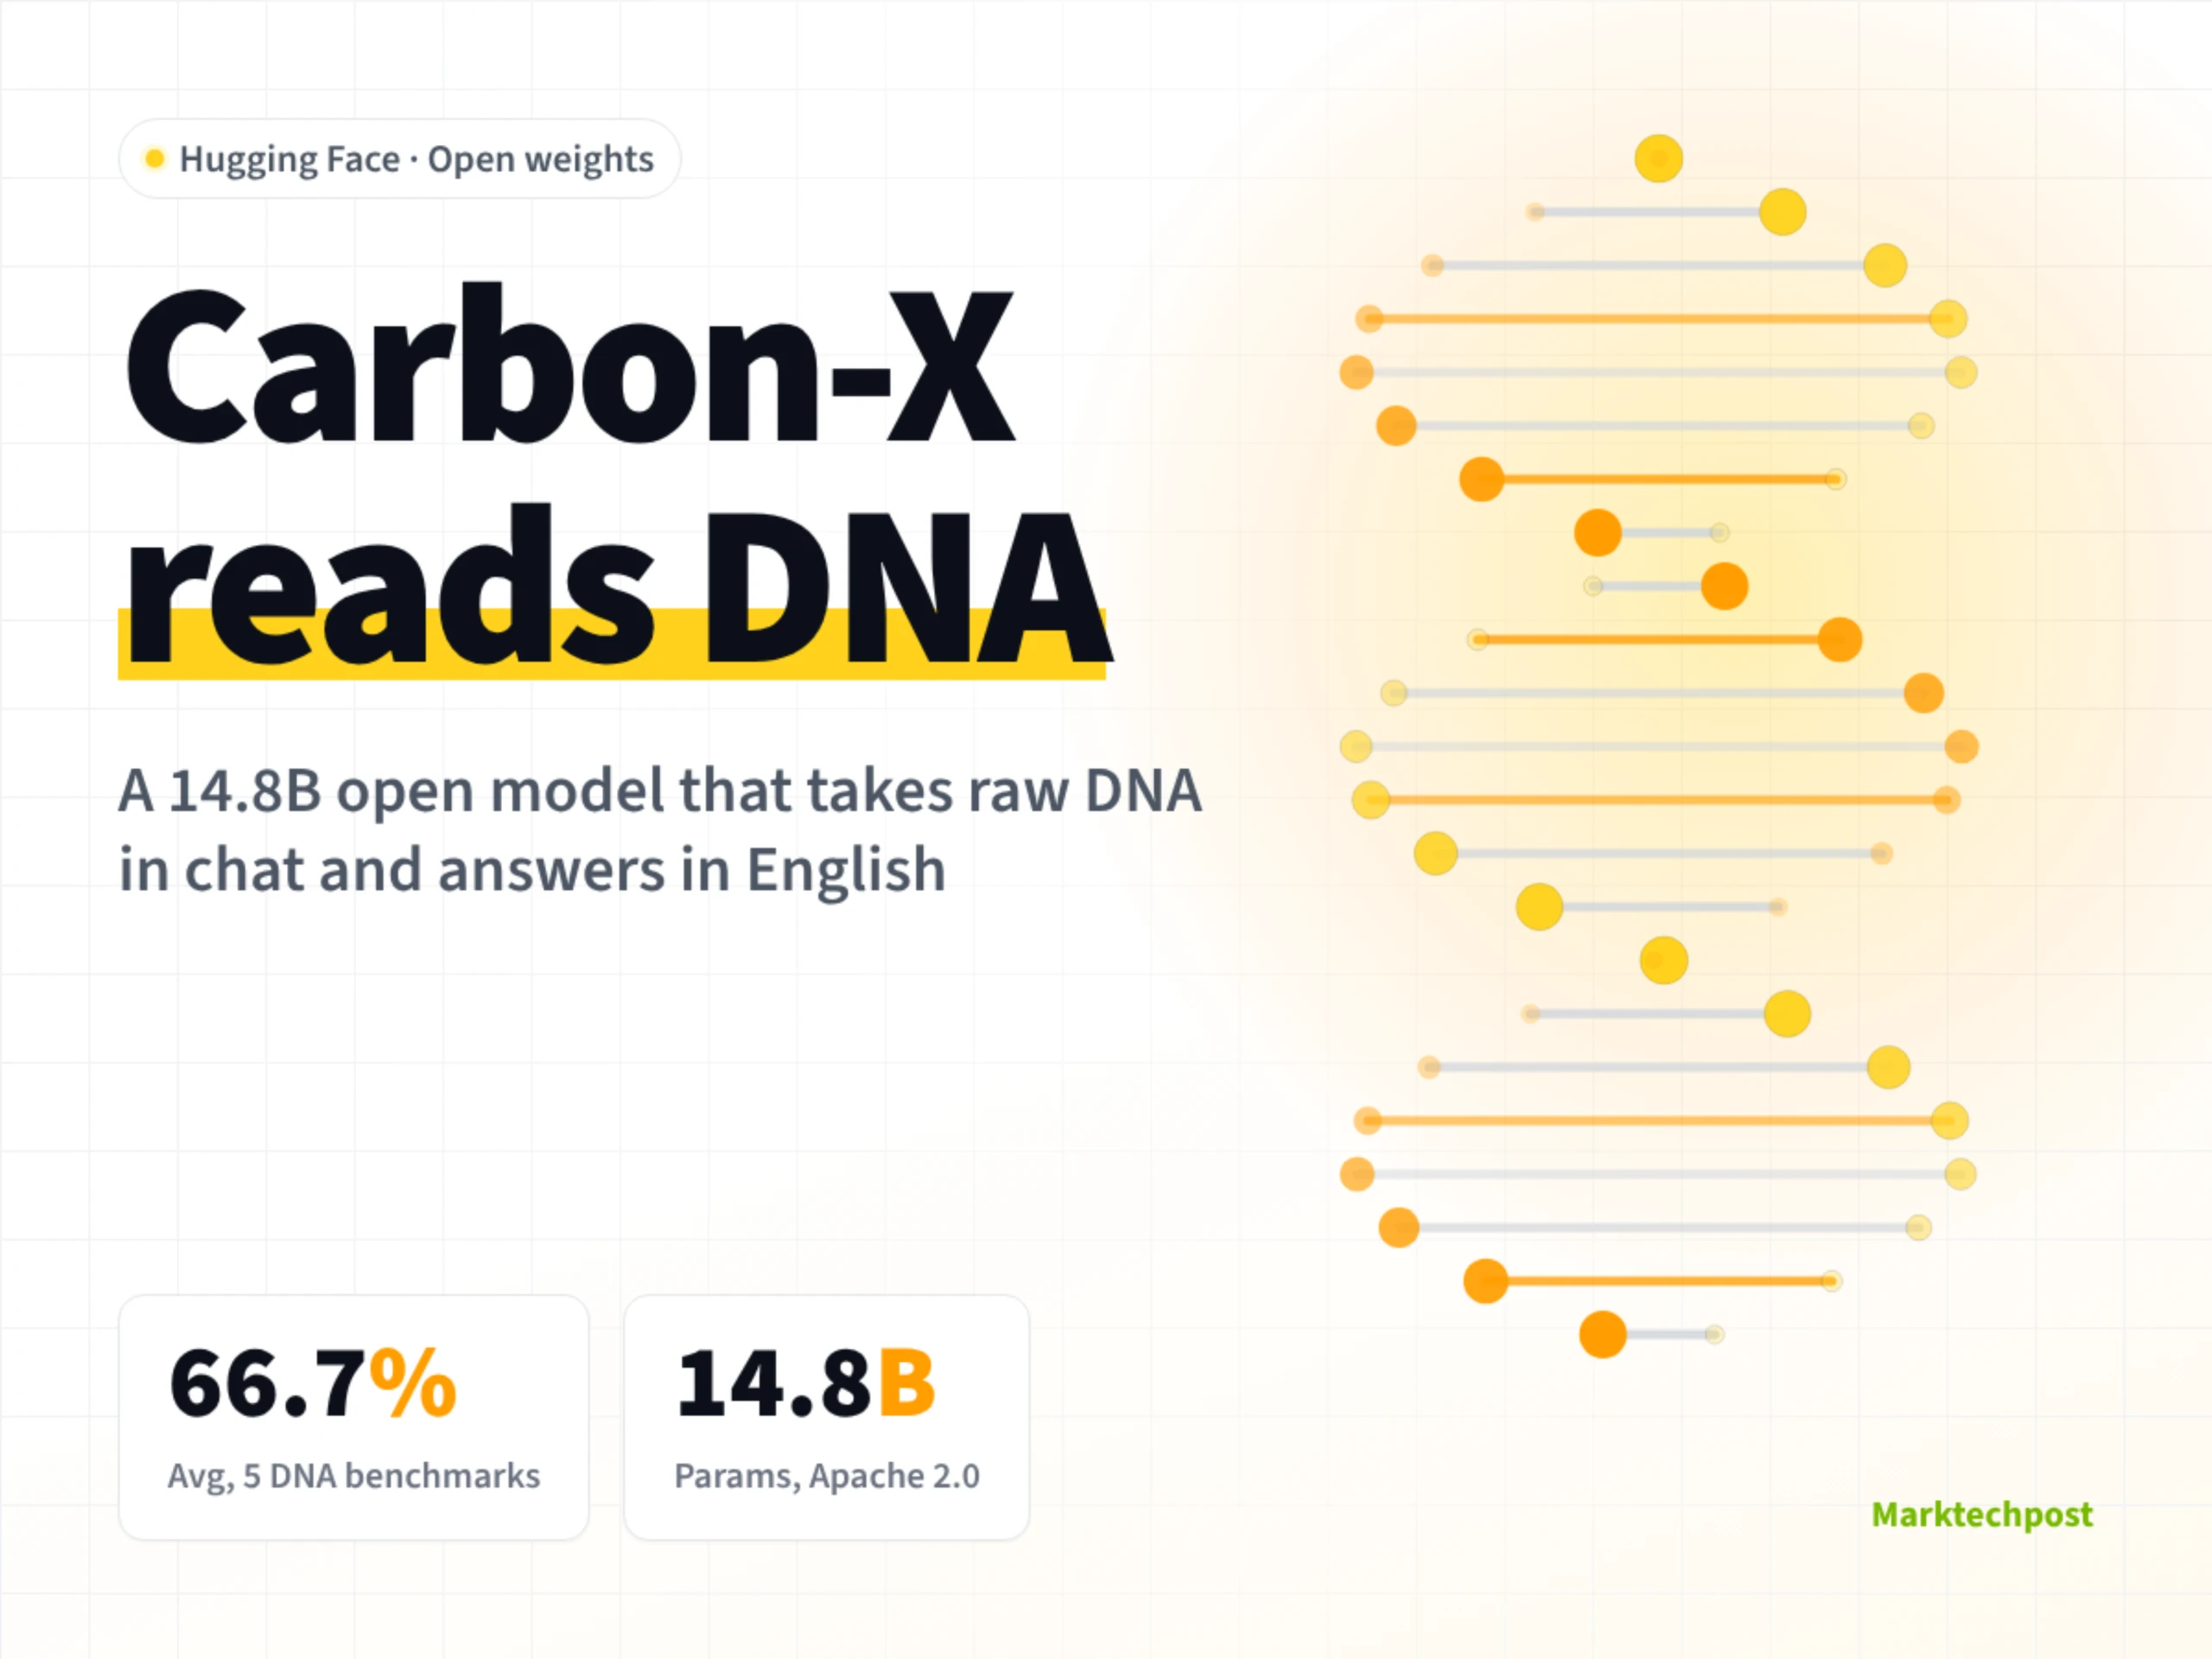
Hugging Face выпустила Carbon-X, открытую нейросеть по биологии, которая читает сырую ДНК в чате и по точности почти догнала закрытую GPT-6.1 Sol, отставая на 0,8 пункта в собственных тестах компании.
Модель такого класса запускается на одной видеокарте. Лаборатория может держать данные о ДНК пациентов на своём сервере и не отправлять их в чужое облако.
До этого лучшие результаты в тестах на понимание ДНК были у закрытых моделей. Carbon-X стала лучшей среди всех протестированных открытых моделей: в среднем 66,7% по пяти ДНК-тестам. Это на 27 пунктов выше базовой модели Qwen3-14B, с которой её начинали. Об этом пишет Marktechpost. Модель собрала команда Hugging Face Bio вместе с Zhongguancun Academy и TIGEM при Университете Неаполя имени Федерико II.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Carbon-X, открытая ДНК-модель на 14,8 млрд параметров | Дату релиза источник не указал | Hugging Face Bio, Zhongguancun Academy, TIGEM и Университет Неаполя имени Федерико II | Веса бесплатно по лицензии Apache 2.0, запуск на арендованной видеокарте H200 около 5 долларов в час (расчёт Hugging Face) |
Что нового умеет Carbon-X?
Параметры, это внутренние настройки, которые модель подбирает при обучении. Грубо говоря, это объём её «памяти». У Carbon-X их 14,8 млрд, а за один раз она удерживает 40 960 токенов. Токен, это кусочек текста или ДНК, которым оперирует модель, примерно как слог.
- Читает последовательность ДНК прямо в чате и отвечает по-английски.
- Оценивает мутацию: безвредная она или патогенная, то есть способная вызвать болезнь.
- Отмечает регуляторные участки, то есть фрагменты ДНК, которые включают и выключают гены.
- Определяет, какому организму принадлежит последовательность.
- Предсказывает следующие «буквы» цепочки ДНК.
- Обычные навыки сохранила: 79,3% на IFEval, тесте на точное выполнение инструкций.
Устроена модель проще предшественников. Текст и ДНК идут единым потоком через один блок, без отдельного кодировщика для ДНК, как было, например, в BioReason. К словарю Qwen3 добавили 5515 «ДНК-токенов», один такой токен покрывает 6 пар оснований.
Лучший результат Carbon-X показала в тесте BioReason Coding: 74,9%. Это выше всех проверенных моделей, открытых и закрытых. В предсказании следующего основания (NextBase) у неё 39,4%, тоже первое место. Худший результат пришёлся на вопросы о местах сплайсинга, то есть о границах, где клетка «вырезает» лишние куски из копии гена: 29,8%.
Деталь методики, которую стоит держать в голове: Carbon-X тестировали с выключенным режимом рассуждений, а конкурентов на максимальном. На цифры сильно влияют отказы закрытых моделей отвечать. Opus 5.5 в NextBase падает с 17,7% до 1,1% при максимальных настройках, Gemini 4 Argon на FrontierVEP опускается с 58% до 38%.
Главный аргумент релиза, цена. По расчёту Hugging Face, инференс (работа уже обученной модели, то есть её ответы) обходится примерно в 1/1800 стоимости GPT-6.1 Sol на одну задачу. Оценка 2,4 млн вариантов неясной значимости из базы ClinVar стоит около 300 долларов против суммы от 32 тысяч до 4 млн долларов на передовых закрытых моделях.
Carbon-X работает и как помощник для ИИ-агента (программы, которая сама решает задачи с помощью инструментов). Kimi K3, обращаясь к Carbon-X, поднял свой ДНК-показатель с 49,4% до 60,5%.
Как попробовать Carbon-X без своей лаборатории?
- Найдите на Hugging Face репозиторий HuggingFaceBio/Carbon-X, там карточка модели и инструкции.
- Если есть видеокарта на 80 ГБ, запускайте через vLLM или Transformers версии 5 и новее. Для Transformers нужен параметр
trust_remote_code=True, без него не заработает ДНК-токенизатор. - Если такой карты нет, берите репозиторий Carbon-X-GGUF. GGUF, это сжатый формат модели для программы llama.cpp: вариант Q8_0 весит 15,8 ГБ, Q4_K_M весит 9,6 ГБ. Нужна сборка llama.cpp b11742 или новее, старые неправильно режут ДНК на токены.
- Держите режим рассуждений выключенным (
enable_thinking=False): модель так дообучали и тестировали.
Все цифры Hugging Face опубликовала сама, независимой проверки в источнике нет. Клинической валидации у модели нет, ставить по ней диагноз нельзя. Сплайсинг она распознаёт хуже, чем в трети случаев.
Чем Carbon-X отличается от YandexGPT и GigaChat?
Hugging Face с российскими моделями Carbon-X не сравнивала, поэтому цифр сопоставления нет. Разница в самой задаче: Carbon-X читает цепочку ДНК как язык. YandexGPT и GigaChat, по моим наблюдениям, удобнее для текстовой работы вокруг темы: объяснить термин из статьи о генетике, упростить абзац, составить план материала.
Что с этого автору, маркетологу и предпринимателю?
Автору Дзена: это готовый сюжет для научпопа о том, как ИИ учится читать геном. Пишите аккуратно и не подавайте модель как «онлайн-генетика», она не проверена клинически.
Маркетологу: если среди клиентов есть клиники, лаборатории или биотех, у вас появился сильный довод. Это 300 долларов вместо миллионов и данные, которые не покидают сервер заказчика.
Предпринимателю в РФ и СНГ: веса открыты, ограничений по странам в материале нет. Для пилота нужна видеокарта на 80 ГБ или аренда H200. Начните с проверки на собственных обезличенных данных.
На мой взгляд, главное здесь не 66,7%, а то, что специализированная открытая модель на 14,8 млрд параметров держится наравне с гигантами в своей узкой нише. Оговорка серьёзная: тесты собственные, у конкурентов мешали отказы, клиники за моделью нет. Что сделать сегодня: если пишете о здоровье и науке, сохраните карточку модели и раздел об ограничениях. Это лучший источник формулировок, чтобы не обещать читателю лишнего.
Что чаще спрашивают про Carbon-X?
Можно ли запустить её на домашнем компьютере?
Полную версию нет, нужна видеокарта на 80 ГБ. Сжатый файл Q4_K_M весит 9,6 ГБ и запускается через llama.cpp, но требования к железу в источнике не уточнены.
Это нейросеть для решения задач по биологии для школьников?
Нет. Если вы искали «нейросеть решение задач по биологии» для уроков, Carbon-X не подходит: она работает с реальными последовательностями ДНК и отвечает по-английски.
Кому она реально нужна?
Лабораториям и биотех-командам, которым важно держать генетические данные у себя и массово оценивать мутации за сотни долларов, а не за миллионы. Если вы из этой среды, скачайте модель и прогоните её на сотне уже изученных вариантов до первого серьёзного проекта.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
LLM-шлюз Keystone вышел в версии 1.0: новая нейросеть больше не требует переписывать код
Разработчики открытого проекта Keystone выпустили версию 1.0 своего шлюза для нейросетей с гарантией стабильного подключения на всю ветку 1.x, и теперь…
Открытая Nanbeige4.3-33B для программирования выиграла 17 тестов из 20, но по своим замерам
Лаборатория Nanbeige выложила в открытый доступ Nanbeige4.3-33B, модель для программирования и офисной работы, которая по собственным замерам обходит трёх…
OpenAI выпустила ИИ-ассистента dots за $100 в месяц: он помогает без команды и видит почту
OpenAI выпустила dots, ИИ ассистента, который работает постоянно и сам предлагает помощь без команды, и собрала его из инструментов для программистов на фоне…
Комментарии