
Google Cloud выпустила llm-d 1.0: маршрутизация с учётом кэша для парков TPU и GPU снизила задержку на 85%
Google Cloud выпустила llm-d 1.0 — первый стабильный релиз распределённого стека для обслуживания больших языковых моделей, и главная цифра: маршрутизация с учётом кэша на процессорах Ironwood TPU снизила время до первого токена более чем на 85%.
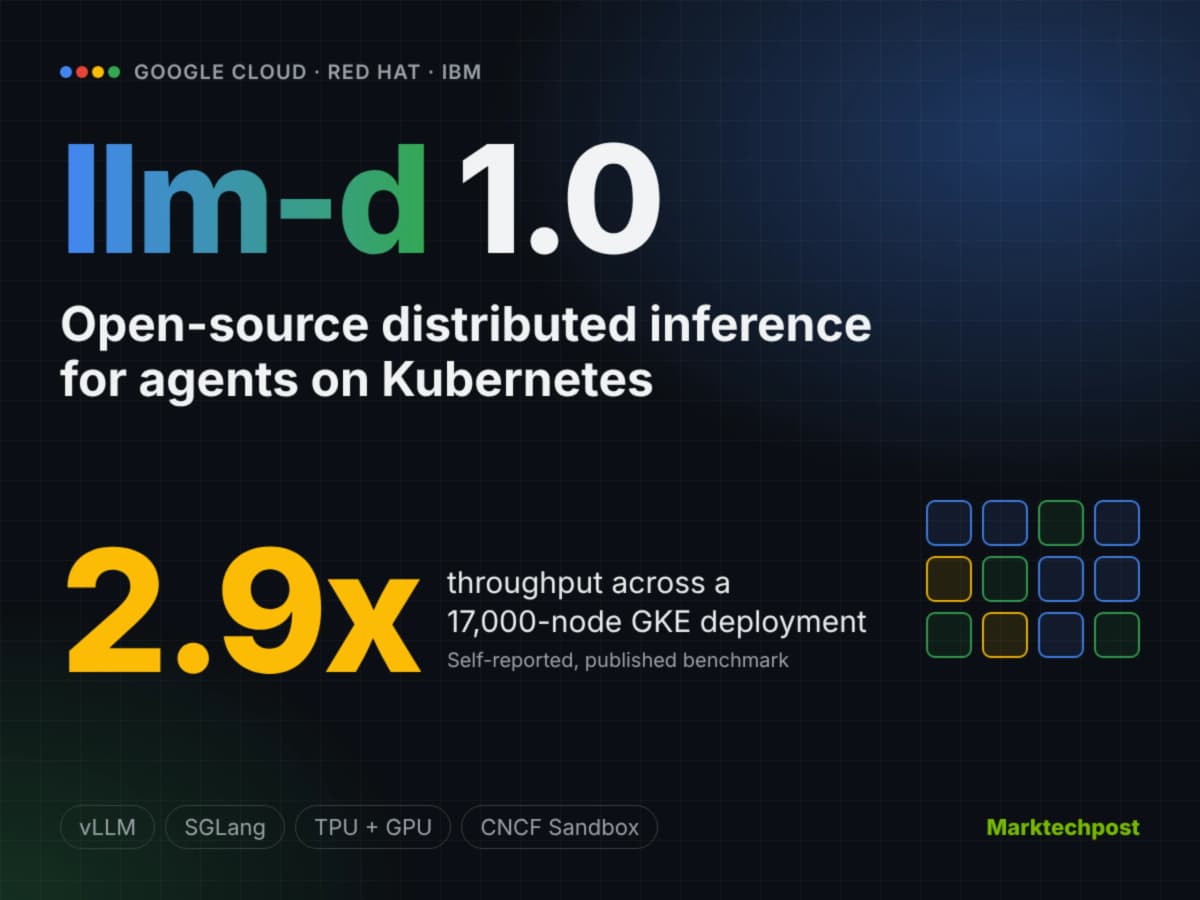
Впервые открытый инструмент на базе Kubernetes объединяет серверы моделей в один координированный пул, и Google показывает результаты на кластере из 17 000 узлов, а не на лабораторной установке.
До сих пор каждый, кто разворачивал крупную языковую модель на своих серверах, сталкивался с одной и той же проблемой: стандартная балансировка нагрузки (когда запросы раздаются серверам по кругу) не учитывает, какой сервер уже хранит нужный контекст разговора. Запрос улетает на случайную машину, контекст приходится загружать заново, задержка растёт. Проект llm-d, который ведут Google Cloud, Red Hat и IBM при участии более 500 разработчиков из 25 организаций, решает именно это. Релиз представили на конференции PyTorch Conference North America, о нём сообщил портал Marktechpost.
| Показатель | Значение | Источник |
|---|---|---|
| Снижение медианного TTFT (время до первого токена) на Ironwood TPU | более 85% | бенчмарк Google, llm-d |
| Рост пропускной способности на Ironwood TPU | 2,4 раза | бенчмарк Google, llm-d |
| Попадание в кэш префиксов на платформе Gemini | с 35% до 70% | данные Google |
| Масштабирование пропускной способности на 17 000 узлов GKE | 2,9 раза при 99,9% успешности | бенчмарк Google, llm-d |
| Снижение TTFT на промптах в 50 000 токенов (A3 Mega, 70B-модель) | около 40% | бенчмарк Google, llm-d |
| Снижение затрат GPU-часов (A3 Mega, 70B-модель) | около 60% | бенчмарк Google, llm-d |
| Загрузка ускорителей при RL time-slicing | с примерно 40% до более 70% | бенчмарк Google, llm-d |
| Число участников проекта | более 500 из 25+ организаций | llm-d, CNCF |
| Лицензия | Apache 2.0 | llm-d GitHub |
Что именно измеряли?
Суть llm-d проще всего объяснить через аналогию. Представьте колл-центр, где клиент каждый раз попадает на нового оператора и заново рассказывает свою историю. llm-d — это система, которая направляет звонок именно к тому оператору, который уже знает контекст разговора.
Технически это работает так: маршрутизатор отслеживает, на каком сервере хранится кэш предыдущих запросов (KV-кэш, то есть промежуточные вычисления, которые модель уже выполнила). Новый запрос отправляется туда, где контекст уже загружен. Если память ускорителя (GPU или TPU) заполняется, кэш автоматически перемещается на обычную оперативную память сервера, а затем на SSD-диск.
Дополнительно llm-d разделяет два этапа генерации: prefill (первичная обработка промпта, требующая большой вычислительной мощности) и decode (посимвольная генерация ответа, ограниченная скоростью чтения памяти). Каждый этап выполняется на отдельном пуле серверов, настроенном именно под его нагрузку.
Проект работает на Kubernetes (система управления контейнерами, стандарт для облачных сервисов) и поддерживает ускорители NVIDIA, AMD, Intel и Google TPU через серверы моделей vLLM или SGLang.
Что обнаружили?
Все цифры ниже — результаты, опубликованные самой Google и компаниями-пользователями llm-d.
-
Ironwood TPU (TPU 7-го поколения): маршрутизация с учётом кэша и выгрузка KV-кэша в оперативную память хоста снизили медианное время до первого токена (TTFT, то есть задержку перед началом ответа) более чем на 85%. Пропускная способность выросла в 2,4 раза по сравнению со стандартным сервисом Kubernetes.
-
Платформа Gemini: доля попаданий в кэш префиксов (когда модель находит уже посчитанный контекст) удвоилась — с 35% до 70%. TTFT для кодовых агентов снизилось более чем на 35%.
-
Масштабирование на 17 000 узлов GKE: пропускная способность выросла в 2,9 раза при распределении по трём кластерам. Успешность запросов составила 99,9%, накладные расходы на координацию — менее 1%.
-
70-миллиардная модель на A3 Mega: выгрузка KV-кэша на файловую систему Lustre и в оперативную память CPU улучшила TTFT примерно на 40% для промптов длиной 50 000 токенов. Сквозная задержка упала на 30%, расход GPU-часов — почти на 60%.
-
RL time-slicing: загрузка ускорителей выросла с примерно 40% до более 70%, но около 30% времени простоя осталось.
Пользователи подтверждают схожую картину. Snap сообщает о попадании в кэш префиксов до 75-80%. Zenteiq зафиксировала рост пропускной способности более чем в 4 раза: с 1,47 до 5,97 миллиарда токенов в день на 1 000 чипов TPU v6e. IBM в демонстрации обслужила 3 000 параллельных кодовых ИИ-агентов (программ, которые самостоятельно выполняют задачи) по цене в 5-10 раз ниже стоимости коммерческих API.
Все приведённые цифры — собственные бенчмарки Google и компаний-пользователей, а не независимые измерения. Результат «85% снижение TTFT» получен на конкретной конфигурации (Ironwood TPU, кодовая нагрузка) и не обязательно воспроизведётся на другом оборудовании или других задачах. Худший из заявленных показателей — RL time-slicing — по-прежнему оставляет около 30% ускорителя в простое, что честно указано самой командой. Проект открытый и имеет лицензию Apache 2.0, но развёрнут пока преимущественно в экосистеме Google Cloud (GKE Inference Gateway), а готовых результатов на других облаках команда не приводит.
Что это значит для вас?
Автору Дзена и копирайтеру. llm-d — инфраструктурный инструмент, напрямую вы с ним работать не будете. Но именно такие проекты определяют, как быстро и дёшево облачные сервисы отвечают на ваши промпты. Если вы используете API для генерации текстов или работаете с кодовыми агентами, задержка до первого символа ответа — ваше рабочее время. Снижение TTFT на десятки процентов — это заметное ускорение при массовой генерации.
Маркетологу и менеджеру. Демонстрация IBM (3 000 агентов по цене в 5-10 раз ниже API) — ориентир для оценки, когда выгоднее запустить собственный кластер вместо подписки на внешний сервис. Граница окупаемости собственной инфраструктуры смещается вниз.
Разработчику и предпринимателю в РФ. llm-d — открытый проект под Apache 2.0, код доступен на GitHub. Он работает на GPU NVIDIA, AMD и Intel, то есть не привязан только к Google TPU. В России прямого доступа к GKE Inference Gateway нет, но сам стек можно развернуть на собственных серверах с Kubernetes. Из доступных в РФ облаков с GPU-кластерами стоит смотреть на Yandex Cloud и Selectel, хотя готовых интеграций с llm-d там пока нет. Начать команда Google предлагает с простого: подключить маршрутизатор llm-d к уже работающему серверу vLLM и оценить попадание в кэш, без полного перехода на новую архитектуру.
Google Cloud выпустила llm-d 1.0 с маршрутизацией с учётом кэша для парков TPU и GPU в момент, когда конкуренция за инфраструктурный уровень ИИ обостряется: NVIDIA развивает Dynamo, CoreWeave строит собственные сервисы. То, что CoreWeave при этом использует llm-d параллельно с Dynamo, говорит о зрелости подхода. Для российского рынка главный вывод: открытый код под Apache 2.0 и поддержка разных ускорителей делают llm-d одним из немногих инструментов, которые реально можно запустить на отечественном железе без зависимости от конкретного облака. Я бы рекомендовал командам, которые уже работают с vLLM, протестировать маршрутизатор llm-d на небольшом кластере и замерить процент попаданий в кэш — именно эта метрика покажет, есть ли смысл идти дальше.
Релиз llm-d 1.0 — не прорыв в качестве моделей, а инженерная работа уровнем ниже: чтобы та же модель отвечала быстрее и обходилась дешевле. Для тех, кто разворачивает языковые модели на своих серверах, это конкретный инструмент с открытым кодом, а не обещание в блоге.
По данным Marktechpost

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Голосовой ИИ Mistral стартует от $0,0035 за минуту: транскрипция, синтез и SDK для агентов
Почему это важно Mistral выпустила полный голосовой стек: распознавание, синтез речи и SDK для голосовых агентов с ценой от $0,0035 за минуту, что делает…
Сравнение нейросетей вслепую: 27 моделей прошли один тест на задачах для бизнеса в РФ
Почему это важно Впервые 27 моделей, включая российские «Алису» и GigaChat, прогнали через один и тот же слепой тест на задачах, с которыми сталкивается…
Эпоха нооцена: почему ИИ-лаборатории нанимают философов вместо программистов
Британский The Economist зафиксировал парадокс: философы востребованнее программистов в ИИ-лабораториях, а профессор Михаил Эпштейн предложил считать запуск…
Комментарии