
Глубокое машинное обучение изнутри: нейросеть поставила «чебурек» рядом с «плохим»
Автор обучающей серии про глубокое машинное обучение выпустил четвёртую часть с разбором отдельных нейронов: впервые в цикле он показывает, как сеть сама группирует слова перед задачей угадать пропущенное слово.
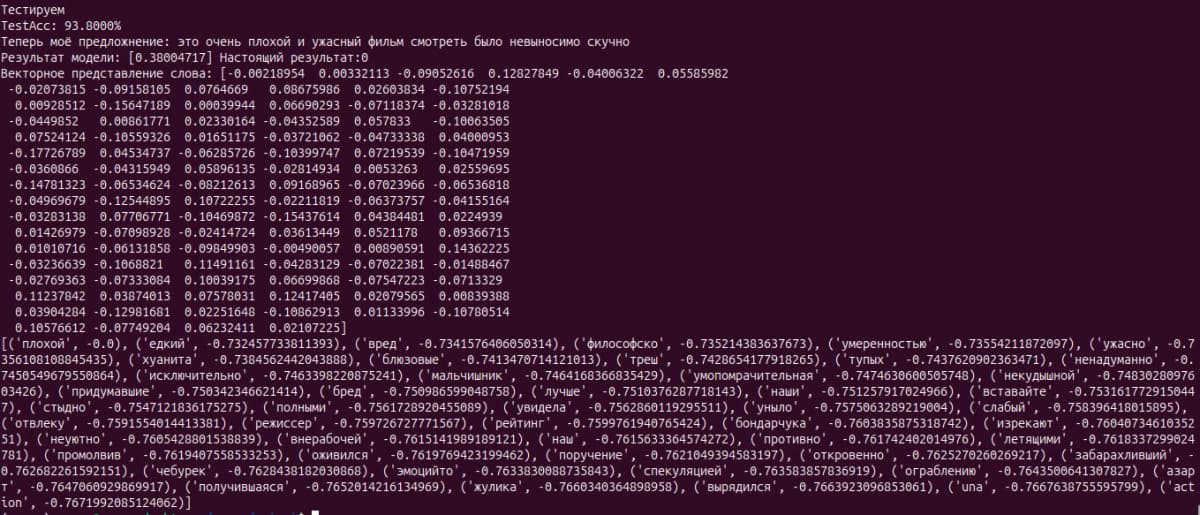
Серия перешла от общего вида нейросети к её внутренностям. Становится видно, где модель «понимает» смысл слов, а где лишь ловит совпадения, которые помогают угадать ответ.
В прошлых трёх частях автор объяснял новичкам основы глубокого машинного обучения и собирал простые нейросети. Теперь он продолжает работу с сетью для обработки естественного языка, по-английски NLP (natural language processing, то есть умение машины работать с обычным человеческим текстом). Дальше в этой части обещана новая сеть, которая по остатку фразы определяет пропущенное слово.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Четвёртая часть серии об основах глубокого обучения | Дату источник не указывает | Автор серии, имя в тексте не названо | Не указана |
Что нового
- Разбор опирается на модель из третьей части: двухслойную нейросеть, которая по отзывам на фильмы с Кинопоиска определяет, хвалит отзыв фильм или ругает.
- Автор впервые смотрит не на сеть целиком, а на скрытый слой (промежуточный ряд нейронов между входом и ответом). По его объяснению, такой слой раскладывает данные по группам.
- Каждое слово внутри модели описано набором чисел, весов. Этот набор называют векторным представлением, его можно сравнить с координатами слова на карте смыслов.
- Автор пишет функцию, которая находит 50 слов, ближе всего похожих на заданное. Близость считается через евклидово расстояние, то есть обычное расстояние между двумя точками.
- Явлению дали имя: обобщение корреляции. Сеть искала прямую связь между словами и оценкой, но заодно уловила часть закономерностей языка.
Почему «чебурек» оказался рядом с «плохим»?
Функцию проверили на слове «плохой». Первым в списке стоит само это слово, что логично: его координаты совпадают сами с собой. Дальше идут слова со схожей пользой для ответа, и разделение проходит по эмоциональной окраске, потому что сеть знает только две оценки.
Среди соседей «плохого» нашлись «едкий», «вред» и «треш». По мнению автора, это подтверждает, что сеть усвоила нечто большее, чем окраску одного отзыва. Но там же оказались «философско», «лучше» и «чебурек», которые негативными не назовёшь.
Вывод автора: модель прежде всего гонится за правильным ответом, а смысл слов она изучает побочно и поэтому неточно. Он также оговаривает, что отдельный нейрон не делит слова на грубые и вежливые, это делает весь скрытый слой совместно.
Как расширить «кругозор» сети, автор тоже называет. Нужно увеличить датасет (набор данных для обучения), усложнить устройство сети или поставить ей задачу сложнее, например угадывать пропущенное слово.
Как попробовать
- Перечитайте первые три части серии, автор прямо советует начать с них.
- Обучите модель классификации отзывов из третьей части, чтобы получить её веса.
- Повторите функцию поиска похожих слов: в коде статьи расстояние берётся со знаком минус, чтобы метод most_common() класса Counter выдал самые близкие слова первыми.
- Подставьте своё слово вместо «плохого» и поищите в выдаче случайных соседей вроде «чебурека».
Учебная модель и YandexGPT: в чём разница?
Модель из статьи учебная. Она маленькая, обучена на одном наборе отзывов и нужна, чтобы понять принцип работы. Из доступных в РФ готовых сервисов для работы с текстом есть YandexGPT и GigaChat. Это рабочие инструменты, а статья помогает понять, откуда у любой нейросети берутся странные ассоциации.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Пример с «чебуреком» годится для поста о том, почему нейросеть иногда пишет невпопад. Читателю проще поверить живому примеру, чем теории.
Маркетологу. Если вы оцениваете тональность отзывов автоматически, учтите вывод статьи: модель ловит связи с оценкой, а не смысл. Спорные отзывы стоит перепроверять руками.
Предпринимателю. Статья и код открыты для чтения, ограничений по региону источник не упоминает. Для бизнес-задач берите готовые российские сервисы, а эту серию дайте сотруднику, который их настраивает.
На мой взгляд, это самая полезная часть цикла для нетехнарей: «чебурек» среди негативных слов объясняет ошибки ИИ нагляднее любой лекции. Оговорка: без навыка программирования повторить код не выйдет, а текст в доступном отрывке обрывается до самой сети угадывания слов. Что сделать сегодня: прочитайте раздел про похожие слова и запомните главный вывод, ИИ ищет совпадения, а не смысл.
Частые вопросы
Нужно ли уметь программировать?
Чтобы понять идею, нет: выводы про группы слов изложены словами. Чтобы повторить опыт, понадобится запускать код из статьи.
Почему модель путает слова?
Она училась только отличать хорошие отзывы от плохих. Всё, что помогало угадать оценку, попадало в одну группу, даже «чебурек».
Что будет в следующей части?
Автор обещает сеть, которая по остатку фразы определяет пропущенное слово. Такая задача заставляет модель изучать язык глубже, и разницу с классификатором отзывов стоит проверить самому на тех же словах.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент на складе: DeepSeek и Gemini оформили запрещённые отгрузки и возвраты
Исследователи прогнали ИИ-агентов на DeepSeek V4 Pro и Gemini 3.8 Flash по обновлённой методологии 3.1 и выяснили: обе модели совершают запрещённые складские…
«Лента» запустила MCP-сервер: ИИ-помощник собирает корзину с актуальными ценами
Команда Lenta Tech подключила MCP-сервер, мост между нейросетью и каталогом «Ленты», и теперь ИИ-помощник прямо в диалоге подбирает продукты с актуальными…
Google открыла TPU Sync: задержка передачи кэша ниже на 90%, Coral TPU не поддержан
Google Cloud выложила в открытый доступ TPU Sync, библиотеку для переноса памяти больших нейросетей между чипами и серверами, потому что всё более узким местом…
Комментарии