
ГигаЧат vs Алиса на мировых бенчмарках: отставание от GPT и Claude в 2–3 раза
Microsoft второго июня запустила независимое сравнение отечественных языковых моделей на международных бенчмарках, и результаты показали трёхкратный разрыв между лучшей российской моделью и мировыми лидерами.
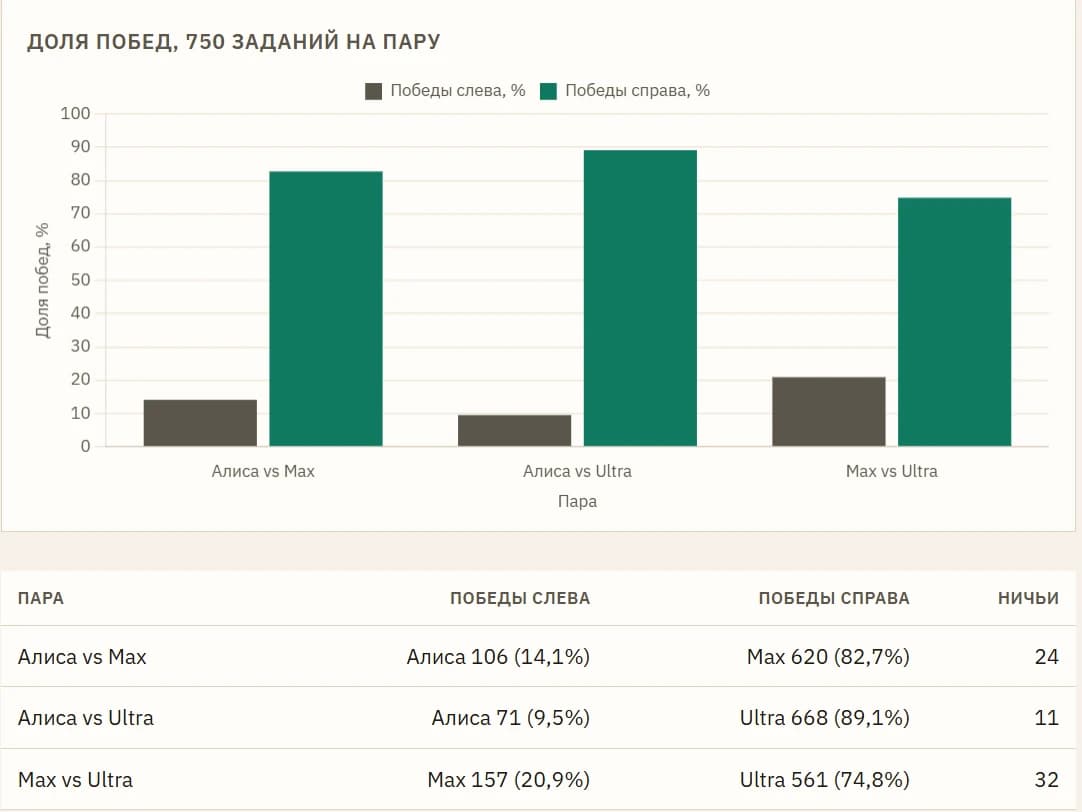
Впервые кто-то прогнал Алису и ГигаЧат через те же тесты, по которым меряют GPT, Claude и Gemini, и опубликовал сырые цифры: российские модели отстают от мировых лидеров в два-три раза на задачах памяти и следования инструкциям.
Независимый исследователь потратил около двух недель на прогон четырёх международных бенчмарков по трём отечественным моделям: Алиса (чат на alice.yandex.ru с подпиской «Яндекс Плюс»), ГигаЧат Max и ГигаЧат Ultra (два тарифа Сбера). Тесты проводились на тех же наборах задач, которые используют западные лаборатории для оценки своих моделей. Результаты позволяют напрямую сопоставить отечественные решения с GPT-5.4, Claude Opus 4.7, Gemini 3.1 Pro и другими. Именно такого публичного сравнения «ГигаЧат vs Алиса» на одинаковых условиях до сих пор не было.
| Показатель | Значение | Источник |
|---|---|---|
| Arena-Hard: ГигаЧат Max vs Алиса | 83% побед Max (620 из 750 пар) | Независимый бенчмарк автора |
| MultiChallenge: ГигаЧат Ultra | 46% точных финальных ответов | Независимый бенчмарк автора |
| MultiChallenge: Алиса | 15% точных финальных ответов | Независимый бенчмарк автора |
| MultiChallenge: Gemini 3.1 Pro Preview | 71,4% | Независимый бенчмарк автора |
| MultiChallenge: GPT-5.4 | 69,2% | Независимый бенчмарк автора |
| MultiChallenge: Claude Opus 4.7 | 58,6% | Независимый бенчмарк автора |
| Алиса: доля ответов на «упрощённой модели» | 90% случаев | Независимый бенчмарк автора |
| Время проведения тестов | около двух недель | Независимый бенчмарк автора |
Как устроены тесты и почему им можно доверять?
Автор прогнал модели через четыре открытых международных набора задач. Каждый измеряет отдельный навык.
-
Arena-Hard (750 заданий). Код, кейсы, длинные инструкции. Модели отвечают на одни и те же вопросы, потом независимый судья (в данном случае Grok 4.6) сравнивает ответы попарно и выбирает, чей «лист» лучше. Победа, поражение или ничья.
-
WildBench (1024 задания). Имитация рабочего дня с ИИ-ассистентом: длинные диалоги, чек-листы, правки, уточнения. Судья ставит оценку от 1 до 10 за каждый ответ. Пятёрка означает «нормально, без блеска». WB-Score (специальная шкала, где пятёрка сдвинута в ноль) показывает, насколько модель выше или ниже этой средней планки.
-
MultiChallenge. Многошаговый диалог, в середине которого пользователь меняет правила, просит учесть сказанное раньше, правит текст. Судья отвечает только «да» или «нет»: попал ли финальный ответ в критерий. Четыре оси оценки: память (не забыть факт из начала), инструкция (не соскочить с правила), редактирование (править текст, а не писать заново), согласованность (не противоречить себе).
-
τ³ (тау-три). Модель сажают на место оператора колл-центра. У неё правила компании и кнопки в учебной CRM (система управления клиентами): найти клиента, поменять билет, провести возврат. Зачёт только если задача закрыта по правилам.
Алиса тестировалась через веб-интерфейс, как её видит обычный пользователь. ГигаЧат тестировался через API (программный интерфейс, через который приложения обращаются к модели напрямую). Если связь обрывалась и вопрос не дошёл, попытку повторяли. Если модель вернула пустоту или ошибку сервера, это считалось нулём.
Алиса для бизнеса («Алиса 360») не тестировалась, она вышла недавно.
Главные результаты: Ultra впереди, Алиса отстаёт втрое
Arena-Hard: сложные письменные задачи. ГигаЧат Max выиграл у Алисы 620 из 750 пар (83%). Ultra показал результат ещё выше. Алиса выигрывала в основном там, где соперник отказывался отвечать или ломал условие задачи. Порядок: Ultra, затем Max, затем Алиса.
WildBench: рабочий чат. Алиса в среднем чуть ниже оценки «нормально», Max чуть выше, Ultra увереннее держит длинный диалог. Разрыв небольшой, порядок тот же.
MultiChallenge: память и послушание. Здесь разрыв между моделями максимальный:
- ГигаЧат Ultra: 46% (каждый второй финальный ответ попал в критерий)
- Алиса: 15% (каждый седьмой)
- Для сравнения: Gemini 3.1 Pro Preview набрал 71,4%, GPT-5.4 набрал 69,2%, Claude Opus 4.7 набрал 58,6%
Ultra вдвое чаще Max закрывает условие в конце длинного диалога. Алиса чаще теряет правило по ходу разговора. На задачах вроде «перепиши версию» все три модели показали результат слабее, чем на запоминании фактов.
Отдельная деталь: в 90% случаев Алиса сообщала «сейчас повышенная нагрузка, поэтому я включаю модель попроще». Автор справедливо отмечает, что тест и есть тест: именно такой результат получает обычный пользователь.
Тестирование провёл один исследователь, а не лаборатория. Судьёй в Arena-Hard выступила конкретная модель (Grok 4.6), а не комиссия экспертов. Алиса тестировалась через веб-интерфейс, ГигаЧат через API, условия не полностью симметричны. Алиса в 90% случаев переключалась на упрощённую модель из-за нагрузки, что снизило её результаты, но именно так её видит реальный пользователь. «Алиса 360» для бизнеса не вошла в тест. Маракуйя ИИ тоже не вошла: продукт находится на рефакторинге.
Что делать с этими цифрами прямо сейчас?
Авторам Дзена и копирайтерам. Если вы используете Алису или ГигаЧат для длинных текстов с правками и уточнениями, имейте в виду: на задачах «помни, что я сказал три реплики назад» Алиса попадает в критерий только в 15% случаев. ГигаЧат Ultra справляется втрое лучше, но даже его 46% означают, что каждый второй длинный диалог потребует ручной правки. Для коротких задач (один промпт, один ответ) разрыв между моделями гораздо меньше.
Маркетологам. Данные показывают конкретный разрыв с мировыми моделями: лучший российский результат (46% на MultiChallenge) уступает GPT-5.4 (69,2%) и Gemini 3.1 Pro (71,4%). Если вы строите автоматизацию на отечественных моделях, закладывайте ручной контроль на длинных цепочках.
Предпринимателям в РФ. ГигаЧат Ultra доступен через API Сбера и показывает лучший результат среди протестированных отечественных моделей. Алиса доступна через «Яндекс Плюс». Обе модели работают без VPN и иностранных карт. Но для задач, где критична точность в многошаговых диалогах (поддержка клиентов, обработка заявок), разрыв с западными моделями пока существенный.
Самое ценное в этом исследовании не сами цифры, а сам факт: кто-то наконец взял и прогнал отечественные модели через те же тесты, что и мировые. Яндекс и Сбер такие бенчмарки публично не проводят, и автор статьи справедливо замечает: «только так можно понять, где твоя модель, а где мировые лидеры». 46% у лучшей российской модели против 71% у Gemini это не приговор, это ориентир. Полтора года назад отечественные модели на таких тестах набрали бы околонулевые баллы. Но разрыв объективно большой. Если вы выбираете между ГигаЧат и Алисой для рабочих задач, цифры говорят однозначно: Ultra. Если задача допускает западные модели, разница в два-три раза на сложных диалогах пока реальна.
Исследование сделало видимым то, что многие чувствовали на практике: российские модели работают, но на длинных и сложных задачах проигрывают мировым лидерам в разы, а не в проценты. Для тех, кто строит продукты на отечественном ИИ, это не повод останавливаться, а конкретная карта, где именно нужно усилить проверку и ручной контроль.
По данным независимого бенчмарка

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-актриса заговорила по-китайски в эфире: чат с персонажами провалил 75 интервью
Создатели ИИ-актрисы Тилли Норвуд отправили её на 75 интервью одновременно, и она провалила, кажется, каждое из них, в одном эфире внезапно перейдя на…
Что такое галлюцинации нейросетей: ИИ чуть не развязал конфликт США и Китая
Почему это важно Впервые стало публично известно о случае, когда галлюцинация ИИ-чатбота едва не спровоцировала вооружённый конфликт между двумя ядерными…
Vantora привлекла $100 млн на ИИ для решения физических задач: стартапы строят и отдают заказчику
Стартап-фабрика Vantora (бывшая UP.Labs) привлекла $100 млн от Silversmith Capital Partners, чтобы строить закрытые ИИ-стартапы исключительно для корпоративных…
Комментарии