
Gemini 4 снова лидирует в 12 из 18 тестов: почему бенчмарки нейросетей не совпадают с реальностью
Gemini 4 Argon 30 сентября вышла с таблицей, где модель лидирует в 12 тестах из 18, и это дословное повторение февральского анонса Gemini 3.1 Pro, которая потом проиграла Claude в реальных задачах больше чем на 300 очков.
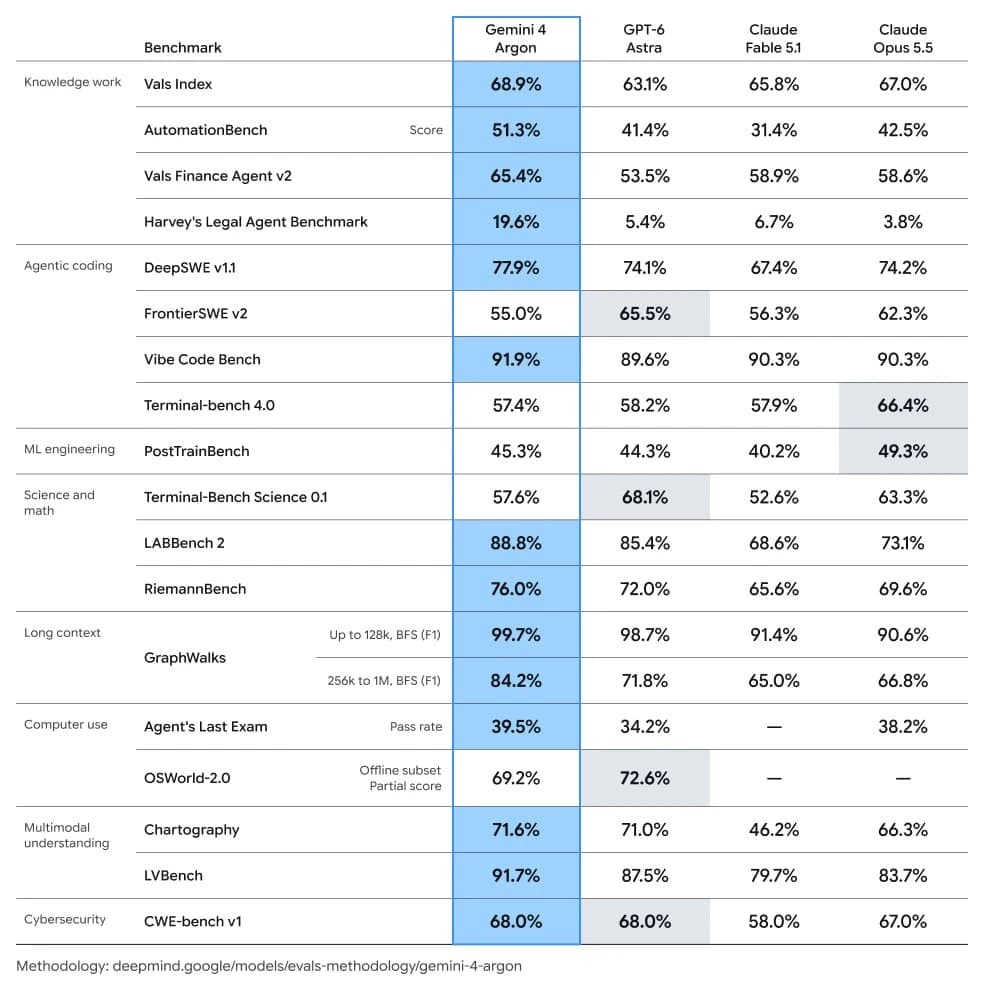
Бенчмарки нейросетей превратились в маркетинговый инструмент: лаборатория сама выбирает тесты, соперников и единицы измерения, а итоговая таблица говорит о качестве подачи, не о качестве модели.
Блогер-аналитик Евгений Медоедов разобрал, как устроены анонсы Gemini за последний год, и обнаружил повторяющийся сценарий: сначала победная таблица, затем разочарование разработчиков, затем обещание исправить всё в следующей версии. Gemini 4 Argon пока идёт по тому же шаблону, причём разочарование на этот раз пришло в день релиза, от самих сотрудников Google.
| Показатель | Значение | Источник |
|---|---|---|
| Побед в собственной таблице Google | 12 из 18 тестов | анонс Gemini 4 Argon |
| Тот же счёт у предыдущей модели | 12 из 18 тестов | анонс Gemini 3.1 Pro, февраль |
| Отставание Gemini 3.1 Pro от Claude в реальных задачах | больше 300 очков | независимые замеры после релиза |
| Доля галлюцинаций у Gemini 3 Pro | 88% | публичные замеры |
| Доля галлюцинаций у Argon | 15% | публичные замеры |
| Место Argon в Artificial Analysis | третье (за Claude Opus 5.5 и Sonnet 5.5) | индекс Artificial Analysis |
| Место Argon в Vals Index | первое, отрыв в пределах погрешности | Vals Index |
| Место Argon в WebDev Arena (оценка живых людей) | восьмое | WebDev Arena |
| Стоимость за токен по сравнению с GPT-6 Astra | в 2,5 раза дешевле | анонс Google |
| Расход токенов на задачу по сравнению с GPT-6 Astra | в 2,3 раза больше | независимые замеры |
| Потери на отменённую Gemini 3.5 Pro | до 400 млн долларов | оценка аналитиков |
Что именно считается бенчмарком?
Бенчмарк (benchmark) нейросети, это стандартный тест: модели дают набор задач, она решает, результат сравнивают с конкурентами. Примерно как ЕГЭ для нейросети. Набрала больше баллов, значит «умнее». Проблема в том, что лаборатория сама решает, какой «ЕГЭ» показать публике и кого поставить рядом.
Галлюцинация (hallucination), это когда модель не знает ответа, но уверенно выдумывает его. Gemini 3 Pro осенью 2025 года галлюцинировала в 88 случаях из 100.
Как Google выбирает, что показать?
Автор разбора выделяет пять приёмов, которыми Google формирует победную таблицу, ни разу не соврав в цифрах.
- Выбрать строки. Argon уступает Claude Opus 5.5 и GPT-6 Astra в программировании на 9 и 11 пунктов соответственно. В тексте анонса об этом ни слова, хотя именно из-за слабого кода отменили Gemini 3.5 Pro.
- Выбрать соперников. Claude Sonnet 5.5 вышел за два дня до анонса Argon и в таблицу не попал. В программировании Sonnet обходит Argon.
- Выбрать рейтинг. В независимом индексе Artificial Analysis Argon делит третье место. В Vals Index он первый, но с отрывом в пределах погрешности. В анонс попадает тот рейтинг, где цифра красивее.
- Выбрать единицу цены. За токен (token, минимальная единица текста, которую обрабатывает модель) Argon в 2,5 раза дешевле GPT-6 Astra. Но токенов на одну задачу он тратит в 2,3 раза больше, и итоговая стоимость задачи выходит дороже. Дешевле Argon только по промо-тарифу, срок которого Google не назвала.
- Выбрать рекорд. Миллион токенов в одном ответе Google называет лучшим лимитом в индустрии. Зачем столько в обычной работе, компания не объяснила.
Разочарование пришло в день релиза
Обычно второй акт, когда разработчики обнаруживают разрыв между таблицей и реальностью, наступает через пару недель. С Argon он начался в день анонса. По данным Bloomberg, собственные сотрудники Google считают, что модель слабо пишет код и слабо делает фронтенд (front-end, визуальная часть сайтов и приложений). Двое собеседников агентства заявили, что модель натаскали на тесты. Google это отрицает.
Публичные замеры подтверждают разрыв. Когда приложения Argon проверяет робот (автоматический тест: нажимаются ли кнопки, работают ли формы), модель вторая из 106. Когда те же сайты сравнивают живые люди в WebDev Arena, она восьмая. Робот проверяет функциональность, человек выбирает, каким сайтом хочет пользоваться.
При этом списывать Argon со счетов рано. В тесте DeepSWE модель первая, в Text Arena тоже, а доля галлюцинаций упала с 88% до 15%. Это реальный прогресс.
Бенчмарки нейросетей как жанр теряют смысл?
Проблема шире одного Google. Автор выделяет три причины, почему победа в бенчмарках нейросетей значит всё меньше.
- Тест стал целью. Когда первое место попадает в пресс-релиз, лаборатории начинают учить модель сдавать именно этот тест. Gemini 3 Pro и 3.1 Pro выиграли таблицы и проиграли реальную работу.
- Тестов слишком много. Из десятков тестов любая сильная модель соберёт набор побед. Argon одновременно первый в Vals, третий у Artificial Analysis и восьмой в WebDev Arena. Какое место попадёт в анонс, решает маркетинг.
- Лидеры упёрлись в потолок. На олимпиадных задачах по программированию у Argon и GPT-6 Astra по 100%. Тесты «выгорают» так быстро, что Vals с мая пять раз меняли состав своего индекса.
Попробовать Argon пока нельзя
Доступ к модели есть только у специалистов по кибербезопасности из программы Fairwind. Когда Argon откроют остальным, Google не сообщила. Всё, что известно о модели, это тесты, которые выбрала сама Google, независимые замеры и слова анонимных сотрудников. Ни один разработчик пока не провёл с ней хотя бы неделю.
Исследование основано на публичных данных: анонсах Google, независимых индексах Artificial Analysis, Vals Index, WebDev Arena и комментариях анонимных сотрудников для Bloomberg. Натаскивание модели на тесты по публичным данным доказать невозможно. Сценарий повторяемости, это наблюдение аналитика, а не доказанная закономерность: выборка из нескольких релизов одной компании за год.
Что это значит для вас?
Три вопроса из разбора работают как фильтр для любого анонса нейросети, включая российские сервисы.
Авторам Дзена и копирайтерам. Когда YandexGPT или GigaChat публикуют таблицу с победами, задайте те же три вопроса: где модель проигрывает и написано ли об этом в анонсе? Каких свежих конкурентов нет в сравнении? Сколько стоит решённая задача целиком, а не один токен? Это спасёт от выбора модели по маркетингу вместо реальной пользы.
Маркетологам. Бенчмарки нейросетей в карточке продукта или рекламе уже не аргумент для продвинутой аудитории. Если строите коммуникацию вокруг ИИ, показывайте результат на конкретной задаче клиента, а не место в рейтинге.
Предпринимателям в РФ и СНГ. Gemini 4 Argon пока недоступна даже на глобальном рынке. Для практических задач сейчас доступны Claude (через VPN или API), ChatGPT, а из российских сервисов YandexGPT и GigaChat. Выбирайте по пробному прогону на своих задачах, не по чужим таблицам.
Я каждый месяц тестирую новые модели на реальных задачах для Дзена: написать текст, собрать структуру статьи, переписать абзац. И каждый раз вижу одно и то же: модель, которая «первая по бенчмаркам», на моих задачах может оказаться третьей или пятой. Разбор Медоедова полезен не столько про Google, сколько как инструкция по чтению любого анонса. Три вопроса, которые он предлагает задавать, я бы вообще распечатал и повесил над монитором. Особенно вопрос про цену задачи целиком, а не за токен: на нём погорел не один бюджет.
Сценарий Gemini сломается, если через месяц после открытия доступа разработчики будут выбирать Argon для работы, а не для скриншотов. До тех пор каждая победная таблица, от Google, от OpenAI, от Яндекса, это приглашение задать три неудобных вопроса, а не повод менять подписку.
По данным Telegram-канал @emedoedov

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Нейросеть для генерации отчетов AstaBrief: 51 секунда вместо трёх минут у Claude
AstaBrief, нейросеть для генерации отчетов, разработанная командой Allen Institute for AI (Ai2), генерирует научные отчёты с цитированием в 3,5 раза быстрее…
Дата-центры для ИИ: почему KV-кеш, а не веса модели роняет сервис под нагрузкой
Почему это важно Большинство инструкций по запуску больших языковых моделей заканчиваются на строке «возьмите четыре карты», но ни слова не говорят про KV-кеш…
Новости нейросетей: Google выпустила Gemini 4 Argon с лимитом в миллион токенов
Google в сентябре выпустила Gemini 4 Argon, рассуждающую модель с лимитом вывода в миллион токенов, которая автоматически находит и закрывает уязвимости в…
Комментарии