
Нейросеть для генерации отчетов AstaBrief: 51 секунда вместо трёх минут у Claude
AstaBrief, нейросеть для генерации отчетов, разработанная командой Allen Institute for AI (Ai2), генерирует научные отчёты с цитированием в 3,5 раза быстрее проприетарных моделей и доступна для скачивания и локального запуска с открытыми весами.
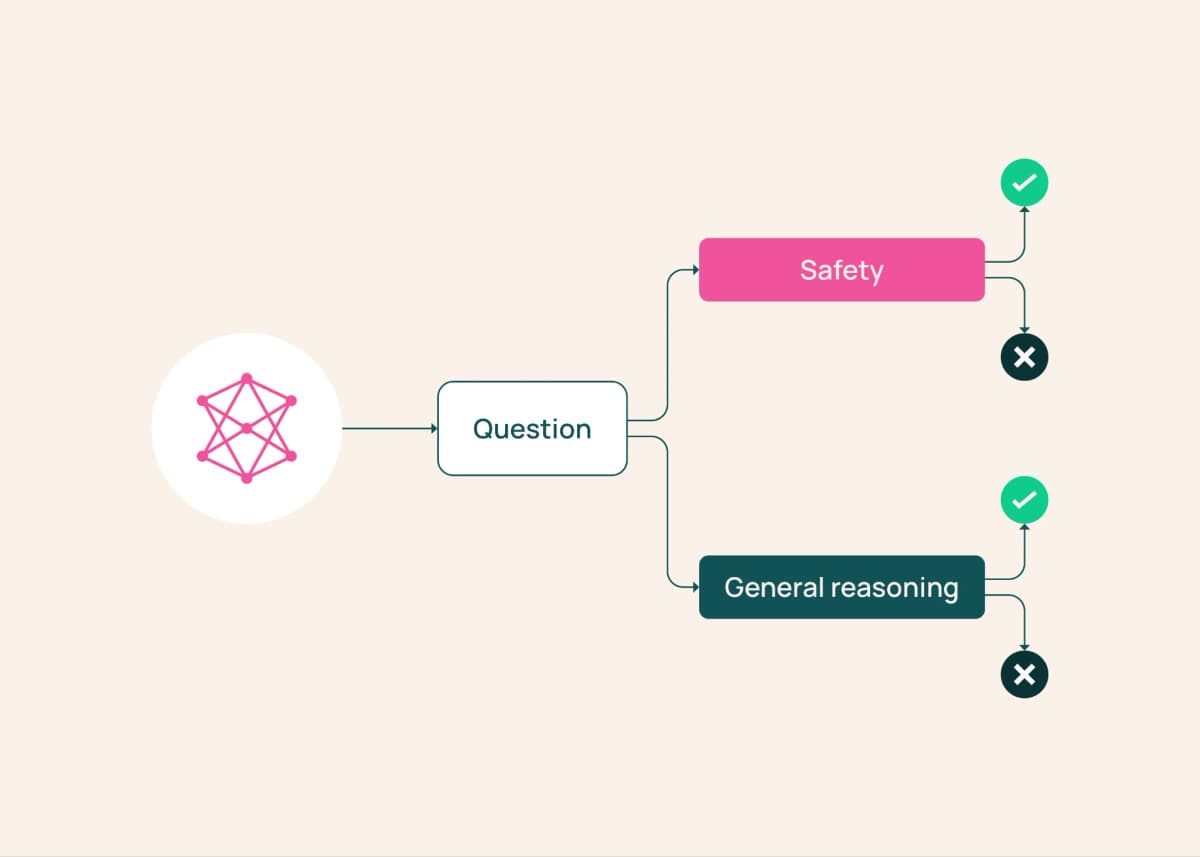
Впервые открытая модель (опенсорс) на 8 млрд параметров догоняет по качеству закрытые модели уровня Claude в задаче научного реферирования, а генерирует отчёт за 51 секунду вместо почти трёх минут.
Институт Ai2 опубликовал модель AstaBrief 8B вместе с обучающими данными и примером рабочего процесса. Модель встроена в Asta, агентную платформу Ai2 для научной работы, как режим Fast mode, работающий параллельно с режимом Thinking mode на базе Claude. Исследователи описали весь путь обучения: от сбора реальных пользовательских запросов до фильтрации по качеству цитирования.
| Показатель | Значение | Источник |
|---|---|---|
| Размер модели | 8 млрд параметров (на базе Qwen3-8B) | Ai2, документация AstaBrief |
| Среднее время генерации отчёта (Fast mode) | 51,1 секунды | Ai2, замеры по полному пайплайну Asta |
| Среднее время генерации отчёта (Thinking mode, Claude) | 178,5 секунды | Ai2, замеры по полному пайплайну Asta |
| Ускорение | примерно в 3,5 раза | Ai2, расчёт |
| Лицензия весов и данных | открытые веса, обучающие данные опубликованы | Ai2, репозиторий |
| Метод обучения | SFT + DPO (без RL) | Ai2, описание пайплайна |
Что именно измеряли?
Команда Ai2 проверяла, может ли небольшая открытая модель (модель с открытыми весами, опенсорс), заточенная под одну задачу, выдавать научные отчёты того же качества, что и крупные закрытые модели вроде Claude, но делать это быстрее и дешевле.
Качество оценивали по нескольким критериям: точность ответа, релевантность, структура отчёта и «заземлённость» на источниках. Последнее означает, что каждое утверждение в отчёте должно опираться на конкретный фрагмент научной статьи и не расширять выводы исследования дальше того, что автор действительно показал.
Для обучения использовали десятки тысяч реальных исследовательских запросов из платформы Asta. Это не синтетические задачи из бенчмарка, а вопросы, которые учёные действительно задавали системе: сравнить подходы в литературе с учётом конкретного метода, популяции или условий.
Что обнаружили?
-
Скорость выросла почти на порядок. Fast mode на AstaBrief генерирует отчёт за 51,1 секунды, Thinking mode на Claude за 178,5 секунды, по данным Ai2.
-
Качество не пострадало. Модель на 8 млрд параметров, обученная методами SFT (дообучение на размеченных примерах, supervised fine-tuning) и DPO (прямая оптимизация предпочтений, direct preference optimization), сопоставима по качеству отчётов с проприетарными моделями, на которых ранее работала Asta.
-
Генерация за один проход. AstaBrief пишет весь отчёт сразу, а не по секциям, пропуская дорогие этапы суммаризации и кластеризации фрагментов. Команда отмечает, что отказ от посекционной генерации не снизил результат.
-
RL оказался необязателен. Ai2 сознательно выбрали более простой рецепт (SFT + DPO) вместо обучения с подкреплением (RL, reinforcement learning), потому что RL-подход нестабилен и дорог. Более дешёвый путь дал сопоставимое качество при условии тщательной фильтрации обучающих данных.
-
Фильтрация данных критичнее метода обучения. Основные усилия ушли не на архитектуру, а на отбор и очистку примеров, которые демонстрировали нужное поведение: точное цитирование, корректную структуру, отсутствие «расширения выводов» (галлюцинация, когда модель уверенно приписывает исследованию больше, чем оно доказало).
Ai2 прямо указывают: обучение и оценка проводились в 2025 году, проприетарные модели для сравнения отражают тогдашний уровень. Полную оценку на свежих моделях-конкурентах команда не проводила. Результаты показывают эффективность конкретных решений по обучению и архитектуре пайплайна, а не абсолютное превосходство над всеми закрытыми моделями на сегодня. Размер и состав выборки обучающих запросов (десятки тысяч) описан без точного числа, что ограничивает воспроизводимость выводов о качестве данных.
Что это даёт вам прямо сейчас?
Исследователям и аналитикам. AstaBrief можно скачать и запустить на собственной инфраструктуре. Это критично, если ваши исследовательские вопросы касаются конфиденциальных или неопубликованных данных: запросы не уходят на чужие серверы. Ai2 публикуют пример рабочего процесса для генерации отчётов из ваших собственных PDF.
Авторам Дзена и копирайтерам. Нейросеть для генерации отчётов такого типа полезна при подготовке обзоров и лонгридов с опорой на источники. Модель обучена не просто пересказывать, а цитировать конкретные фрагменты, что снижает риск галлюцинаций. Для работы нужен компьютер с GPU, способный запускать модели на 8 млрд параметров.
Разработчикам и предпринимателям в РФ. Модель построена на базе Qwen3-8B с открытыми весами. Это означает, что её можно дообучить (fine-tuning) под собственные задачи: юридические справки, медицинские обзоры, техническую документацию. Из доступных в РФ аналогов для генерации длинных текстов с источниками можно рассматривать YandexGPT и GigaChat, но открытых весов у них нет, а значит, локальный запуск и адаптация невозможны.
По моим наблюдениям, главная боль при использовании больших моделей для научных обзоров не скорость, а «тихое расширение выводов»: модель пишет гладко, но приписывает исследованию то, чего в нём нет. То, что Ai2 сфокусировались именно на фильтрации обучающих данных по качеству цитирования, а не на усложнении архитектуры, мне кажется более надёжным путём. Открытые веса плюс обучающие данные дают возможность проверить, как именно модель «заземлена» на источниках. Для российских исследователей, работающих с чувствительными данными, локальный запуск без отправки запросов в облако может оказаться решающим аргументом. Единственное ограничение: Ai2 честно не сравнили AstaBrief с сегодняшними версиями Claude и GPT-4o, так что «сопоставимое качество» относится к моделям начала 2025 года.
Для тех, кто хочет попробовать: модель и данные доступны в открытом репозитории Ai2, а режим Fast mode уже работает внутри платформы Asta. Если вам нужна нейросеть для генерации отчётов, которую можно запустить у себя и адаптировать под конкретную область, AstaBrief на сегодня один из немногих открытых вариантов, собранных именно под эту задачу.
По данным Allen Institute for AI (Ai2)

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
TechCrunch Disrupt 2026 ждёт 10 000 участников: что полезно перенять, а не копировать
Конференция TechCrunch Disrupt 2026 пройдёт 13–15 октября в Сан-Франциско, и организаторы объявили, что бронирование выставочных столов в Expo Hall закрывается…
Blackstone раскрыл критерии отбора ИИ-гигантов: уроки для ИИ-стартапов в России
Blackstone, один из крупнейших мировых управляющих альтернативными активами, объявил, что глава подразделения Blackstone N1 Джас Кхаира выступит на конференции…
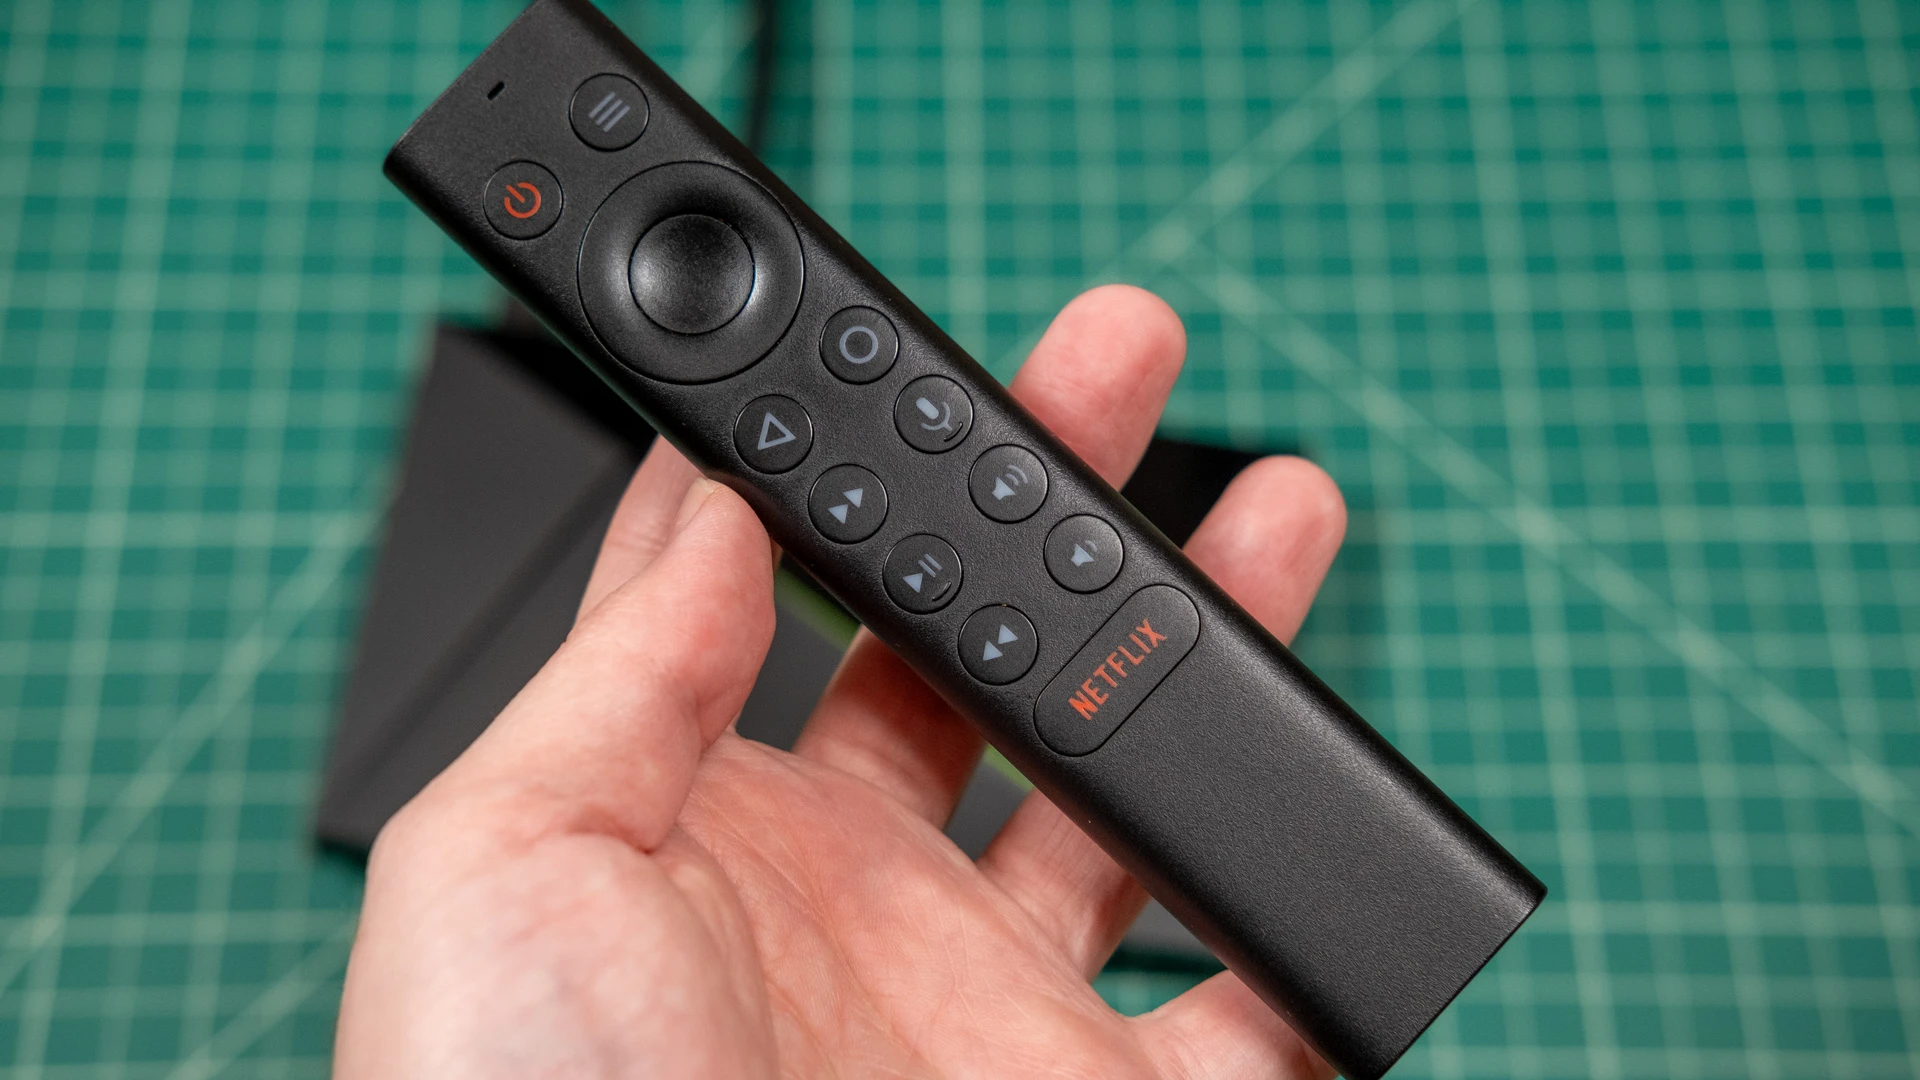
Nvidia Shield TV Pro подорожала на 50%: виноват дефицит памяти из-за ИИ-бума
Nvidia Shield TV Pro, стриминговая приставка 2019 года с ИИ-апскейлингом (улучшением картинки нейросетью), подорожала на 100 долларов до 299,99 доллара со 2…
Комментарии