
«Давайте просто развернём свою LLM на 1Т параметров»: что пришлось построить вокруг неё в Битрикс24
Сергей Нотевский, руководитель AI-платформы в Битрикс24, на конференции Saint HighLoad++ в июне рассказал, как команда прошла путь от единственной точки доступа к модели до полноценной платформы, и каждый шаг этого пути полезен любому, кто думает о собственном ИИ-сервисе на российской инфраструктуре.
Битрикс24 обслуживает миллионы пользователей в РФ и СНГ, и вопросы хранения данных, требований 152-ФЗ и выбора между внешним API и собственным развёртыванием здесь решаются не в теории, а в продакшене. Опыт команды показывает реальную цену фразы «давайте просто развернём свою LLM (большую языковую модель, нейросеть, которая генерирует текст) на 1Т параметров».
Доклад Сергея Нотевского на Saint HighLoad++ и его текстовая версия на Хабре описывают инженерную кухню, которую обычно не показывают. За простой идеей «поставить свою модель» стоит цепочка решений: от лицензионной проверки весов до разделения нагрузки между чатом и агентами. Для российского рынка, где вопрос «где обрабатываются данные клиентов» стоит остро, этот разбор особенно ценен.
Что понадобится
- Понимание, зачем вашему продукту собственная модель, а не внешний API (MaaS, model as a service, то есть провайдер запускает модель, вы платите за токены)
- Доступ к вычислительным мощностям с GPU (графическими процессорами, на которых работают нейросети)
- Движок для запуска моделей (в докладе упоминается проверка совместимости движка с форматом API и оптимизациями)
- Инженерная команда, которая возьмёт на себя очереди, кэширование, мониторинг и обработку пиков
- Время на тестирование: проверка модели «с витрины» и модель в продакшене отличаются радикально
Пошаговая инструкция: от одного endpoint до платформы
-
Определите, зачем вам self-hosted. По словам Нотевского, при выборе между внешним API и собственной инфраструктурой команда Битрикс24 смотрела на три вещи: данные (что приходит в запросе, какие ограничения на обработку, где допустимо выполнять), гибкость (выбор моделей, лимиты и приоритеты под сценарии) и экономика (сравнение цены внешнего API с расходами на мощности и команду). Переезд сам по себе не означает, что токен (единица текста, которую обрабатывает модель) стал дешевле.
-
Проверьте модель до того, как продукт от неё зависит. Карточка на Hugging Face (крупнейший каталог открытых моделей) показывает контекст, бенчмарки (результаты стандартных тестов) и требования к памяти. Но этого мало. Отдельно проверяйте движок: поддерживает ли он нужный формат API и оптимизации. Формат весов сопоставьте с доступным оборудованием. И обязательно прочитайте лицензию: возможность скачать веса не равна разрешению на коммерческое использование.
-
Выберите размер модели вместе с требованиями к качеству. Если компактная модель справляется, нет смысла занимать дорогой вычислительный пул. Крупную подключайте там, где выигрыш в качестве оправдывает ресурсы. Считайте стоимость законченной задачи: дешёвый вызов бесполезен, если после него задачу приходится решать заново.
-
Разделите нагрузку по профилю. Когда несколько сценариев (чат, обработка документов, агентные задачи) используют общие мощности, короткая реплика в чате встаёт в очередь за длинным документом. Команда Битрикс24 разделила пулы по трём профилям:
- Быстрый интерактив. Важны TTFT (time to first token, время до первого токена, то есть сколько пользователь ждёт начала ответа) и скорость генерации. Нужен резерв мощностей, даже если часть простаивает.
- Длинный контекст. Требует много памяти под KV-cache (кэш внимания модели, где хранится обработанный контекст). Это ограничивает параллельность.
-
Многошаговые задачи. Длительность зависит от цепочки вызовов ИИ-агента (программы, которая сама решает, какие действия предпринять) и объёма генерации.
-
Не надейтесь на «просто добавить реплик». Свободные мощности нужно получить, загрузить веса, подготовить окружение и проверить готовность. Всплеск нагрузки может случиться быстрее. Запас нужен заранее, планировать его приходится с учётом типа работы в пуле.
-
Настройте мониторинг качества после каждой оптимизации. Нотевский отдельно подчёркивает: после очередной оптимизации необходимо убедиться, что модель всё ещё отвечает как надо. Средняя утилизация (загруженность оборудования) сама по себе не показывает, что у пользователя чата всё в порядке.
В CRM после звонка ИИ помогает менеджеру получить саммари (краткое содержание разговора), заполнить карточку клиента и оценить качество беседы. Для пользователя это один сценарий, и время ожидания важно на весь сценарий целиком. Но за одним пользовательским запросом стоит несколько обращений к модели. У агента число шагов зависит от хода решения задачи. Поэтому по числу запросов в API трудно понять, сколько работы предстоит платформе. Именно для таких случаев и нужно разделение пулов: чат менеджера не должен ждать, пока закончится обработка длинного документа в соседнем сценарии.
Считать, что скачать модель равно запустить в проде. Успешно ответить на один запрос и обслуживать продукт с живыми пользователями, по словам Нотевского, разные задачи. Нужны параллельность, резерв и тестирование обновлений.
Игнорировать лицензию. Открытые веса (open weights, когда параметры модели доступны для скачивания) не означают свободу коммерческого использования. Ограничения бывают существенными.
Переезжать на self-hosted ради экономии без расчётов. Мощности оплачены и тогда, когда полезной работы нет. Задачи распределения запросов, очередей, кэширования и обработки пиков, которые у провайдера спрятаны за API, при переезде становятся вашими и тоже входят в себестоимость.
Смешивать все типы нагрузки в одном пуле. Длинный reasoning (когда модель «рассуждает» и генерирует развёрнутую цепочку мыслей) блокирует место для коротких реплик. Без разделения пулов пользователь чата платит временем ожидания за чужую задачу.
Что делать с этим прямо сейчас, по ролям
Автору Дзена и копирайтеру. Если вы используете ИИ для контента, этот разбор объясняет, почему один и тот же сервис иногда отвечает мгновенно, а иногда «думает» минуту. За кулисами идёт борьба за вычислительные ресурсы. Понимание этого помогает выбирать время работы и реалистично оценивать, чего ждать от российских сервисов.
Маркетологу и продакт-менеджеру. Выбор между MaaS и self-hosted влияет на бюджет напрямую. Доклад Нотевского даёт чеклист: данные, гибкость, экономика. Если ваш продукт работает с персональными данными в РФ, вопрос «где обрабатывается запрос» перестаёт быть техническим и становится юридическим.
Предпринимателю в РФ и СНГ. Битрикс24 показал, что развернуть LLM на своих мощностях реально, но дорого не только в деньгах, а в инженерных задачах. Если вы думаете о собственном ИИ-сервисе, начинайте с вопроса «оправдывает ли выигрыш в качестве дополнительные ресурсы», а не с покупки GPU.
Доклад Нотевского ценен именно тем, чего в нём нет: маркетинговых обещаний. Фраза «давайте просто развернём свою LLM на 1Т параметров» звучит иронично, потому что «просто» здесь не бывает. Команда честно описала, что переезд с внешнего API не сделал токен дешевле автоматически и что каждый слой платформы (очереди, пулы, мониторинг качества) пришлось строить отдельно.
По моим наблюдениям, большинство российских компаний, которые сейчас думают о self-hosted LLM, недооценивают именно эту «обвязку». Модель можно скачать за час. А вот платформу вокруг неё придётся строить месяцами. Если у вас нет инженерной команды такого уровня, внешний API (YandexGPT, GigaChat) остаётся разумным выбором, по крайней мере для старта.
Честная оговорка: доклад описывает логическую схему решений, не конкретное оборудование и не размещение сервисов. Перенести эту схему один в один на другой продукт без адаптации не получится.
Самый практичный вывод из всего доклада укладывается в одно решение: прежде чем покупать GPU, посчитайте стоимость не токена, а законченной задачи пользователя, и честно сравните её с ценой внешнего API, включив в расчёт команду, простой мощностей и бессонные ночи дежурного инженера.
Хотите разобраться в нейросетях на практике?
В dzen.guru мы тестируем ИИ-инструменты и показываем, как применять их в контенте и бизнесе без собственного дата-центра
Попробовать dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
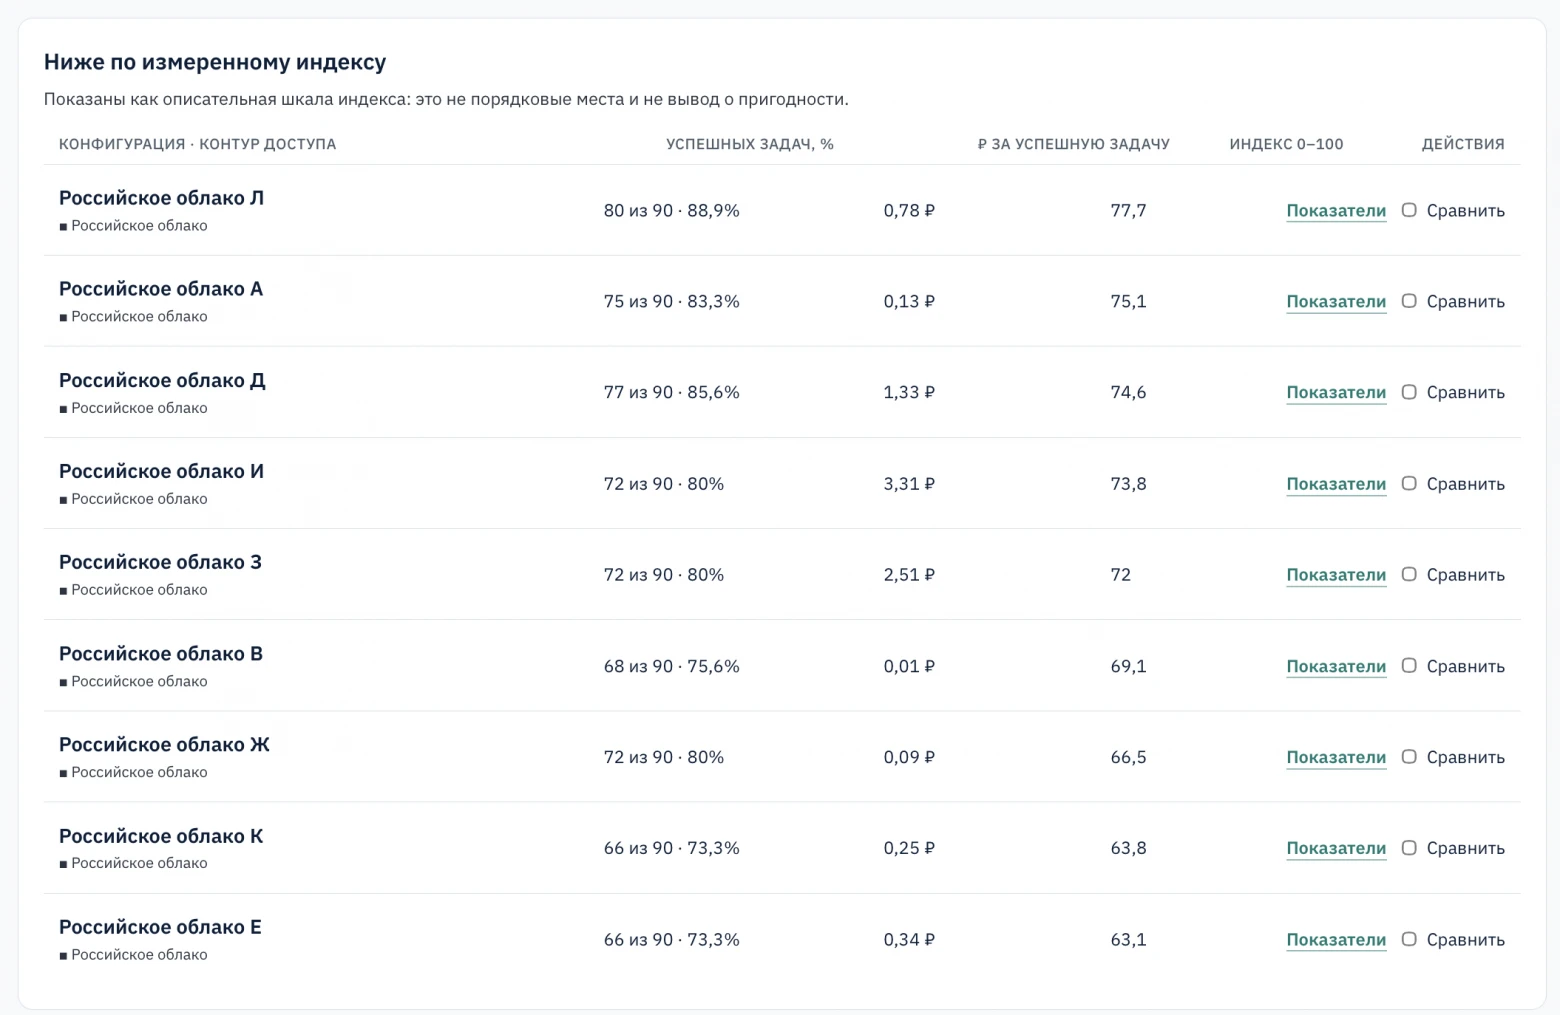
RTX 5070 Ti против 11 российских облаков: локальная модель не уступила и обошлась в 37 раз дешевле
Компания или частный автор не привлекала инвестиции, а провела независимое сравнение локальной видеокарты с российскими облачными провайдерами ИИ, поэтому…
Поэзия агентной разработки, или Как теперь писать код и не утонуть в легаси
Компания или продукт в источнике — это статья на Хабре (русскоязычная). Автор — разработчик с опытом в Яндексе, Clojure, Flutter. Давайте напишем по плану…
Локальный ассистент для Zoom, часть 10: NLI работает на коротких фразах, но ломается после 120 знаков
Эта статья написана в формате how-to и основана на личном опыте автора, описанном в его блоге о разработке локального ассистента «Чароит» для Zoom. Все факты,…
Комментарии