
Что такое ИИ-агент в работе: блог на Laya и Gemma 4 сам отбирает и публикует новости
Разработчик Алексей Яковенко собрал ИИ-агента, программу, которая сама отбирает, пишет и публикует новости блога, на моделях Laya и Gemma 4 у себя на сервере, на фоне шума вокруг новой модели JEV.
Если вы давно хотели понять, что такое ИИ-агент в работе, эта схема подойдёт как учебный образец. Сервис принимает новость, решает, нужна ли она блогу, и доводит подходящую до публикации.
Агента собрали без готовых агентных фреймворков, только на Python и двух моделях на своём сервере. Такую систему можно держать целиком у себя, а не в чужом облаке.
LangGraph и CrewAI, высокоуровневые агентные фреймворки (наборы готовых заготовок, которые связывают модель с инструментами), автор сознательно не использовал. Алексей Яковенко, разработчик на Python с многолетним стажем, написал всю логику взаимодействия моделей и инструментов сам. Поводом для разбора стала модель JEV, которую местами называют очередным «убийцей всех LLM».
Чем JEV отличается от привычной языковой модели?
JEV выпустила компания TypeSafe AI. Это нейросеть для быстрых решений внутри программ. Вести диалог, писать код или произвольный текст она не умеет, и это не её задача.
Обычная LLM (большая языковая модель, нейросеть, которая пишет текст) даже короткий ответ собирает последовательно, токен за токеном. Токен здесь означает кусочек слова, из которых модель складывает ответ. Яковенко задаёт прямой вопрос: зачем генеративная модель там, где нужно лишь выбрать вариант из известного списка?
TypeSafe AI называет JEV первой публичной моделью класса System One Models. Название отсылает к двум системам мышления, которые популяризировал психолог и нобелевский лауреат Даниэль Канеман: быстрой интуитивной и медленной, требующей усилий. JEV берёт на себя работу первой.
У модели три особенности:
- типизированный ответ: вы заранее задаёте форму ответа, это выбор из вариантов, оценка по шкале или вероятность того, что утверждение истинно;
- параллельная обработка: несколько независимых вопросов к одному тексту модель оценивает одновременно;
- числовая уверенность: вместо фразы «я практически уверен» модель возвращает вероятность.
Для практики автор берёт Laya, один из открытых аналогов JEV. Открытая модель (open-source) означает, что её можно скачать и запустить на своём сервере.
Что понадобится для сборки?
- собственный сервер для обеих моделей;
- Laya для сортировки новостей по темам;
- LLM семейства Gemma 4 для анализа и написания статей;
- Python и FastAPI, набор инструментов для создания веб-сервисов на Python;
- база данных и фоновый обработчик задач, который забирает новости из очереди;
- доступ к вашему блогу для публикации.
Требования к железу и время на сборку в разобранной части материала не названы, поэтому закладывайте запас.
Пошаговая инструкция: от входящей новости до статьи в блоге
- Разверните Laya на сервере. Её задача: определить тематику новости и отсеять неинтересное.
- Рядом разверните модель семейства Gemma 4. Она получит только те новости, которые прошли фильтр.
- Сформулируйте для Laya типизированный вопрос, например вероятность того, что новость относится к теме вашего блога.
- В коде на Python задайте правило: что делать с полученной вероятностью. Новость можно взять в работу, отправить другой модели или запросить дополнительные данные. Порог вы выбираете сами.
- Дайте большой модели инструменты для анализа информации, подготовки статьи и публикации. Набор правил для неё задаётся в системном промпте, постоянной инструкции, которую модель читает перед каждой задачей.
- Соберите всё в сервис на FastAPI с базой данных, фоновым обработчиком и собственной обвязкой агента (Agent Harness), то есть кодом, который передаёт задачи между моделью и инструментами.
- Добавьте небольшой веб-интерфейс, чтобы видеть процесс от классификации новости до готовой статьи на сайте.
Набросок системного промпта для шага 5, это мой шаблон, а не код автора:
Ты редактор новостного блога. Тебе передают новость, которая прошла фильтр по теме.
Проверь факты по доступным инструментам, напиши статью на русском без выдуманных цифр
и опубликуй её через инструмент публикации. Если данных не хватает, не публикуй.
Схема разделяет дешёвое решение и дорогую генерацию. Laya отсекает лишнее, а Gemma 4 тратит ресурсы только на то, что прошло отбор.
В материале есть пример. На вход подают обращение пользователя, модель возвращает вероятность 0.92, что оно связано с проблемой авторизации. Дальше обычный код на Python решает, выполнить действие или передать задачу другой модели. В новостном агенте вопрос тот же, только вместо «авторизации» стоит тема вашего блога.
- Путать правильный формат с правильным решением. Типизированный ответ не делает модель безошибочной: она может выбрать неверный вариант.
- Верить вероятностям как абсолютной истине. Автор прямо предупреждает, что к ним тоже нужен скептический взгляд.
- Считать вычисления бесплатными. У JEV оплачиваются только входные токены, но это особенность тарифов API (программного доступа к модели), а не отсутствие работы на стороне модели.
- Сравнивать JEV с большой LLM без учёта задачи. Заявленные разработчиками цифры автор отдельно призывает проверять на своём случае.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Заберите идею фильтра: отделите отбор тем от написания текста. Даже без своего сервера можно сначала спрашивать нейросеть «подходит ли новость под мою тему, да или нет», а писать только по отобранному.
Маркетологу. Схема показывает, где экономить: дешёвая модель сортирует поток, дорогая работает только с отобранным. Это стоит учесть, когда считаете бюджет на ИИ для мониторинга новостей.
Предпринимателю в РФ и СНГ. Laya и Gemma 4 разворачиваются на собственном сервере, поэтому данные не уходят в зарубежное облако. Если свой сервер не по силам, из доступных в РФ аналогов для роли большой модели подойдут YandexGPT и GigaChat.
На мой взгляд, главная ценность разбора не в JEV, а в отказе от фреймворков: когда логику пишешь сам, понимаешь, где агент ошибается. Я бы начал с одного фильтра по теме и неделю сверял его решения вручную, прежде чем доверять публикацию. Честная оговорка: автопубликация без человека на старте рискованна, галлюцинация (когда ИИ уверенно выдумывает то, чего не было) попадёт прямо в блог.
Агент, который пишет за вас, полезен ровно настолько, насколько строг его фильтр. Начните с фильтра, а писать доверите потом.
Нейросети для авторов Дзена
Разбираем, как встроить ИИ в работу над каналом без потери качества и доверия читателей.
Перейти в dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
OpenAI предложила называть дата-центры «кампусами ИИ-вычислений»: ставка на выборы 2028 года
OpenAI готовит пиар-кампанию на период после выборов в Конгресс США и на фоне непопулярности дата-центров предлагает называть их «кампусами ИИ-вычислений»,…
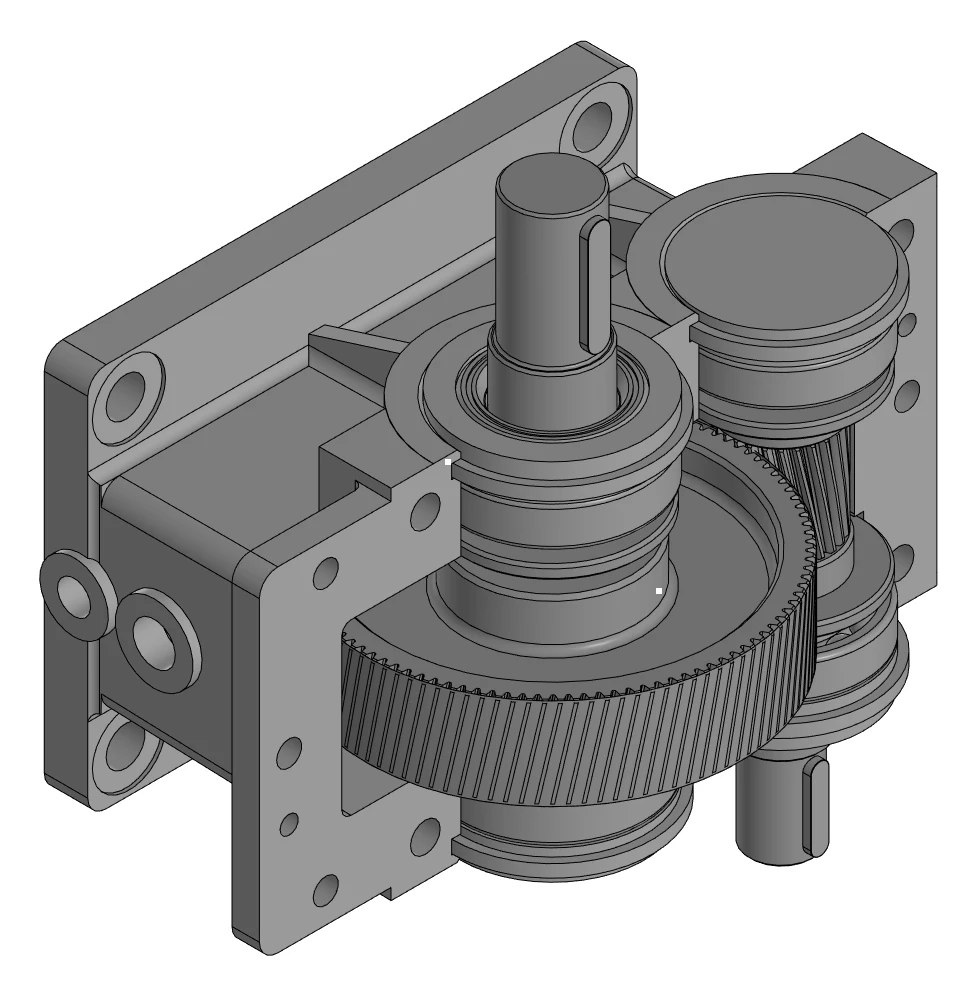
Нейросеть сама спроектировала редуктор в КОМПАС-3D: от расчёта до чертежей и спецификации
Энтузиаст ИИ-агентов выпустил плагин, через который нейросеть сама строит детали, сборки и чертежи в КОМПАС-3D, и проверил его на типовой студенческой…
OpenAI запустила рекламу в ChatGPT: показ получает не тот, кто больше заплатил
OpenAI запустила рекламу в ChatGPT и 21 октября 2026 года раскрыла её устройство, а значит, борьба за клиента переезжает из поисковой выдачи прямо в диалог с…
Комментарии