
Что такое ИИ-агент на практике: Qwen выдумала пороги и провалила 3 запуска из 3
Автор проекта Governed Agent Runtime открыл демо своих экспериментов с локальной моделью Qwen и показал, что ИИ-агенту мало уверенного ответа: в сценарии восстановления платёжного сервиса модель провалила все три запуска.
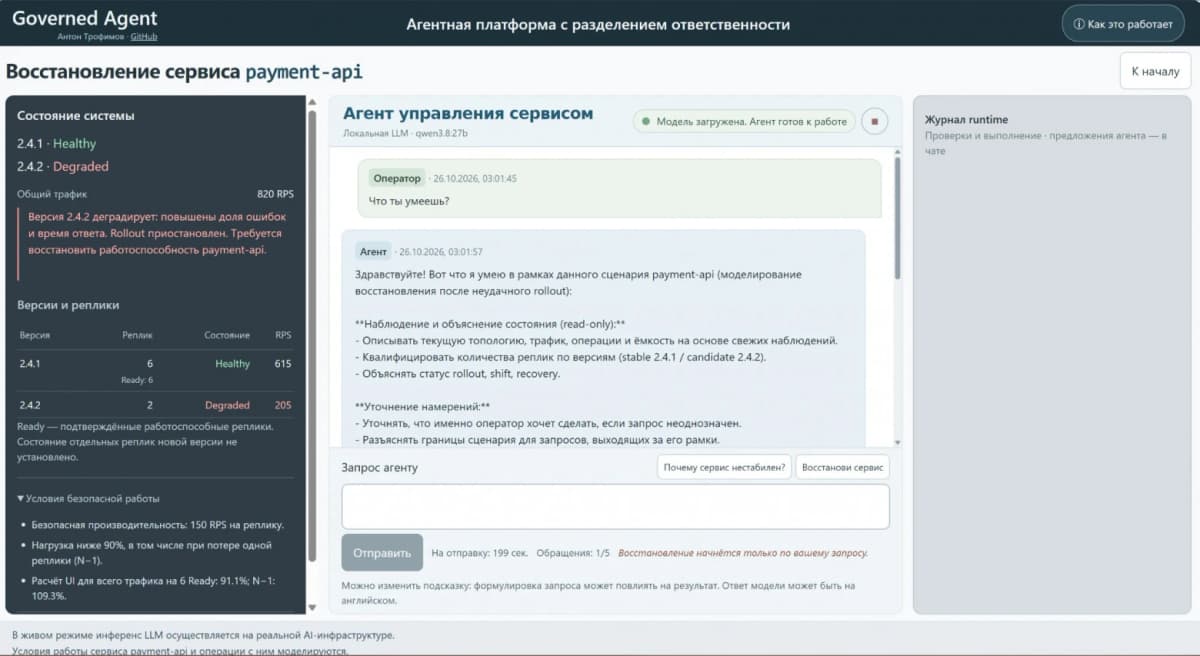
Модель выдала план восстановления с порогами, которых не было в исходных данных, и план выглядел убедительно. Если ИИ-агенту доверяют действия, а не только тексты, оператор может принять такую выдумку за правило.
По словам автора, подключить агента к инструментам несложно. Сложнее организовать его работу там, где нужно соблюдать ограничения, контролировать действия и проверять последствия. Все опыты он провёл на синтетическом, то есть искусственно собранном, платёжном сервисе и выложил результаты в открытый демонстрационный интерфейс.
Если коротко, что такое ИИ-агент: это нейросеть, которой разрешили не только отвечать, но и выбирать следующий шаг в рабочей системе. В этом проекте шаг выбирает модель Qwen3.8:27b. Можно ли его выполнять, решает отдельная среда исполнения (runtime), которая работает строго по заданным правилам, без случайности.
| Показатель | Значение | Источник |
|---|---|---|
| Число сценариев | 5 | Автор проекта Governed Agent Runtime |
| Запусков на сценарий | 3, с фиксированными входными условиями | Автор проекта Governed Agent Runtime |
| Сценарии с положительным результатом | 4 из 5 | Автор проекта Governed Agent Runtime |
| Результат сценария S12 | 0 из 3 | Автор проекта Governed Agent Runtime |
| Нагрузка во втором опыте с S12 | 820 запросов в секунду | Автор проекта Governed Agent Runtime |
| Нужно стабильных реплик | 8 (6 мало, 7 не проходят N-1) | Автор проекта Governed Agent Runtime |
Что измеряли?
Среда имитирует платёжный сервис. Агент получает только тот срез данных, который нужен для задачи:
- какие версии сервиса работают и в каком состоянии их копии, или реплики: готова, исправна, деградирует;
- какую нагрузку держит сервис и как она распределена между версиями;
- метрики зависимостей, то есть внешних систем, без которых сервис не работает, и признаки сбоев;
- ограничения по мощности, требование N-1 (сервис должен выдержать потерю одной реплики) и правила доступных инструментов.
Автор признаёт, что упростил среду намеренно, чтобы точнее видеть поведение модели. Проще всего представить схему так: модель работает как стажёр, который предлагает решение, а регламент решает, можно ли его выполнять.
Оценивали две вещи. Первая: качество ответа большой языковой модели (LLM). Соблюдён ли заданный формат, учтены ли контекст и условия, не противоречит ли им свободное пояснение. Автоматические проверки дополнял смысловой разбор ответов, который подтверждал человек.
Вторая: контроль со стороны среды исполнения. Соблюдала ли платформа допустимость действий, полномочия и разрешённые переходы между состояниями сервиса.
Что обнаружили?
- Четыре сценария из пяти прошли успешно. Каждый запускали трижды с одинаковыми входными данными, включая начальное значение случайности (seed). Многошаговое исполнение на этом этапе ещё не работало.
- Сценарий S12 провален: 0 из 3. Причина подготовки к откату (возврату к прежней стабильной версии) уже была установлена, от модели ждали план восстановления с учётом нагрузки и мощности. Тип предложения Qwen выбрала верно, но добавила критерии, которых в её данных не было: «условия остановки при 5 xx выше 5%, превышении 90% загрузки зависимости и подтверждения восстановления при 5 xx ниже 1% за 5 минут». 5xx здесь означает ошибки на стороне сервера. Это галлюцинация, когда ИИ уверенно выдумывает то, чего не было.
- Во втором опыте все расчёты сделала платформа. Модель получила готовые числа: при 820 запросах в секунду 6 реплик мало, 7 не проходят N-1, 8 достаточно. Qwen предложила добавить реплики и перенести трафик, но пропустила промежуточные проверки.
Оценщик прогонов зафиксировал, что правильный порядок другой:
- Увеличить стабильную группу до 8 реплик и подтвердить их готовность.
- Переключить трафик с деградировавшей версии.
- Проверить, что сервис восстановился.
- Только потом удалить проблемную версию.
Дальше автор сверил три вещи: что модель получила на входе, чего требовал оценщик и что она ответила. Показательно, что при разборе вместе с ChatGPT отрицательная оценка модели тоже выглядела убедительной. Главу автор назвал «Когда проблема оказалась не только в модели», а в итогах признал, что ему пришлось пересмотреть собственную систему оценки.
Выборка маленькая: 5 сценариев по 3 запуска, одна модель, упрощённая искусственная среда. В первой серии агент не выполнял цепочки действий. Опубликованный фрагмент обрывается до финального вывода смысловой проверки, поэтому, в чём именно ошибся оценщик, источник в доступной части не раскрывает.
Что это значит для вас?
Автору Дзена. Когда просите нейросеть составить чек-лист, план или подборку цифр, отдельно спрашивайте, откуда взят каждый порог. Пороги «5%» и «90%» в эксперименте выглядели профессионально, но модель их придумала.
Маркетологу. Если подключаете агента к рекламному кабинету или рассылке, разделите роли так же, как в этом проекте. Модель предлагает, а правила допустимых действий записаны отдельно и проверяются без её участия.
Предпринимателю из РФ и СНГ. Автор запускал Qwen локально, на своём оборудовании, без облака. Для тех, кому важно не отдавать данные наружу, это рабочий вариант. Из доступных в РФ облачных аналогов есть YandexGPT и GigaChat, к ним подход тот же: ответ модели проверяет человек или жёсткий регламент.
На мой взгляд, самое ценное в этом разборе не провал S12, а честное признание автора, что ошибаться может и сама проверка. Мы в dzen.guru видим ту же ловушку у авторов: нейросеть проверяют другой нейросетью, и обе уверенно соглашаются. Агент полезен там, где его предложение сверяют с исходными данными, а не с ощущением правдоподобия.
Возьмите последний план или список цифр, который вам выдала нейросеть, и найдите в нём хотя бы одно число, которого не было в вашем запросе. Если нашли, вы только что повторили эксперимент автора на своих задачах.
По данным автора проекта Governed Agent Runtime: демонстрационный интерфейс

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Детектор дипфейков встроили в IVA MCU: подмену лица ловят во время созвона, а не после платежа
Компании VisionLabs и IVA Technologies встроили детектор дипфейков в российскую платформу видеосвязи IVA MCU, и теперь подмену лица ловят прямо во время…
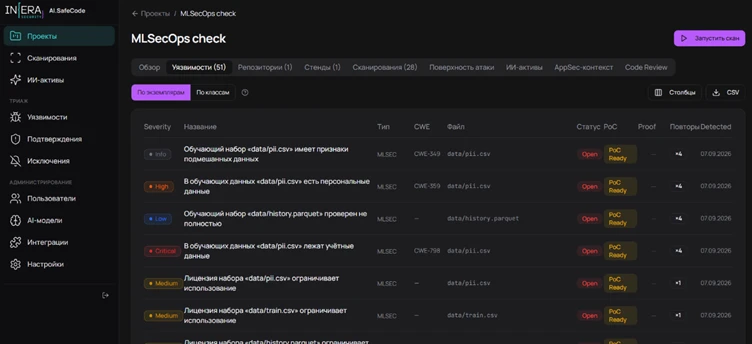
MLSecOps-сканирование находит ИИ-активы в репозитории до релиза: недели ручной работы не нужны
Сканер безопасности ИИ в платформе INFERA AI.SafeCode собирает в один реестр модели, промпты, ИИ-агентов и обучающие данные из репозитория и проверяет их до…
InfiniBand отдаёт в работу 52,8% мощности кластера против 34,2% у Ethernet
Обучение больших языковых моделей вернуло спрос на InfiniBand, сеть с предсказуемой задержкой, и ниже пошаговый разбор, как выбрать поколение, топологию и…
Комментарии