
Что такое ИИ-агент без чистых данных: контента больше, а конверсия стоит на месте
ИИ-агенты обрабатывают данные об аудитории быстрее любой команды, но если исходные данные о пользователях неточны, автоматизация не исправляет ошибки, а масштабирует их до размеров, которые вручную уже не отловить.
Маркетологи в 2025 и 2026 году массово подключают ИИ-агентов к рекламе и аналитике, принимая рост упоминаний бренда в ответах ChatGPT или Gemini за успех. Проблема не в агентах, а в том, что грязные данные на входе дают грязный результат на выходе, только теперь в тысячекратном объёме.
Колонку опубликовал Джейсон Барнард на Search Engine Journal, опираясь на интервью с Мэллори Грей, креативным директором Skydeo. Skydeo продаёт именно те данные об аудитории, о качестве которых идёт речь, поэтому автор сразу оговаривает конфликт интересов. При этом аргументы Грей он считает самостоятельными и подкрепляет их собственным анализом рынка.
| Показатель | Значение | Источник |
|---|---|---|
| Объём данных Skydeo | 1,4 трлн точек данных по 320 млн человек | Skydeo (через Search Engine Journal) |
| Типы сигналов, обрабатываемых агентом | Поведенческие, покупательские, интересы, намерения (тысячи одновременно) | Мэллори Грей, Skydeo |
| Характерный симптом проблемы | Объём контента растёт, конверсия стоит на месте или падает | Мэллори Грей, Search Engine Journal |
Что именно проверяли?
Автор задал Мэллори Грей серию скептических вопросов о том, как ИИ-агенты (автономные программы, которые сами ищут информацию, выявляют закономерности и собирают аудиторные сегменты) работают с данными о пользователях.
Суть проста. Человек-аналитик изучает несколько источников, замечает закономерности и строит гипотезу. ИИ-агент делает то же самое, но параллельно обрабатывает тысячи сигналов и постоянно пересматривает выводы по мере поступления свежих данных. Решения о стратегии по-прежнему принимает человек, агент лишь расширяет объём «сырья» для этих решений.
Ключевой вопрос звучит так: что происходит, когда это «сырьё» изначально некачественное?
Три вывода, которые стоит запомнить
-
Упоминание не равно выбору. Бренд может резко нарастить свою видимость в ответах генеративных систем (ChatGPT, Gemini), но при этом не получить роста целевого трафика или продаж. По словам Грей, частота цитирования сама по себе измеряет не то, что нужно бизнесу.
-
Объём растёт, результат стоит. Грей описывает характерный тревожный сигнал: контента, вариаций и кампаний становится больше, а вовлечение или конверсия тихо выходят на плато или снижаются. Объём легко измерить, а автоматизация делает его производство дешёвым, поэтому рост выглядит как прогресс, хотя реальный показатель давно не двигается.
-
Потеря объяснимости. Когда на вопрос «почему мы нацелились на эту аудиторию?» честный ответ звучит как «так решил ИИ», обратная связь, которая раньше ловила ошибочные допущения, исчезает. Стратегия может месяцами катиться по инерции, пока кто-то не заметит, что ключевая метрика никогда не была той, которая росла.
Урок из эпохи DMP: масштаб усиливает ошибку
Автор проводит параллель с платформами управления данными (DMP, Data Management Platform, системы, которые в начале 2010-х собирали сторонние данные о пользователях и обещали точный таргетинг за счёт объёма). Тогда сторонние данные часто оказывались неточными, а масштаб лишь ускорял накопление ошибок. Отказ Safari и Firefox от сторонних куки вернул индустрию к данным из первых рук, то есть к тому, что пользователь сообщил или показал своим поведением сам.
ИИ-агенты, по мнению Грей и автора колонки, повторяют тот же цикл с новым двигателем. Доступ к мощной модели становится массовым. А вот то, чем бренд её кормит, по-прежнему остаётся редкостью и реальным конкурентным преимуществом.
Исследованием в строгом смысле материал не является: это экспертная колонка с одним интервью. Skydeo продаёт данные об аудитории и прямо заинтересована в выводе «качество данных важнее модели». Автор это признаёт, но независимых замеров конверсии или A/B-тестов в тексте нет. Цифра 1,4 трлн точек данных взята со слов компании и не верифицирована третьей стороной. Выводы логичны, но воспринимайте их как аргументированную позицию, а не как результат контролируемого эксперимента.
Что делать с этим прямо сейчас?
Автору на Дзене. Если вы используете ИИ-агента для анализа аудитории канала или подбора тем, проверьте, на каких данных он работает. Метрики Дзена (дочитывания, подписки, время на странице) относятся к данным первого типа, наблюдаемому поведению, и они надёжнее, чем «интересы», которые модель вывела сама. Стройте контент-план на том, что читатели реально делают, а не на том, что агент предположил о них.
Маркетологу. Перестаньте считать упоминания бренда в ответах ChatGPT или Gemini финальной метрикой. Отследите, совпадают ли промпты, по которым вас показывают, с реальными запросами ваших клиентов, и конвертируются ли эти показы хотя бы на уровне, оправдывающем затраты на оптимизацию.
Предпринимателю в РФ. Из доступных в России инструментов аудиторной аналитики с элементами ИИ работают «Яндекс Метрика» и «Яндекс Аудитории». Принцип тот же: прежде чем подключать автоматизацию, разделите данные на три слоя. Первый, то, что клиент сказал сам. Второй, то, что вы наблюдали в его поведении. Третий, то, что модель додумала. Если основная часть таргетинга держится на третьем слое, вы автоматизируете догадки.
Я проверял это на собственных каналах: стоит дать ИИ-агенту «вывести портрет аудитории» без жёсткой привязки к реальной аналитике, и он выдаёт гладкий, убедительный и абсолютно бесполезный профиль. Грей формулирует точно: агент не заменяет потребность в качественных данных, он на них работает. Для авторов Дзена это значит одно: не доверяйте агенту решение «для кого писать», пока не убедились, что он опирается на ваши реальные дочитывания и подписки, а не на собственные галлюцинации (случаи, когда модель уверенно выдумывает то, чего не было). Автоматизация без проверки входных данных, это способ ошибаться быстрее.
Три проверки из колонки стоит провести до любого масштабирования. Первая: разберите, какие сигналы реально питают ваши инструменты. Вторая: замените подсчёт упоминаний на отслеживание конверсий. Третья: заведите правило, по которому кто-то в команде обязан объяснить простым языком, почему выбрана именно эта аудитория или именно это сообщение. Если ответ сводится к «так решил ИИ», это момент притормозить, а не ускориться.
По данным Search Engine Journal

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google AI Overviews нарастили ссылки до 26%, но часть кликов уводит обратно в Google
Google AI Overviews наращивает встроенные ссылки, но часть из них ведёт не на сайты, а обратно в ИИ-режим Google, и это напрямую касается трафика любого…
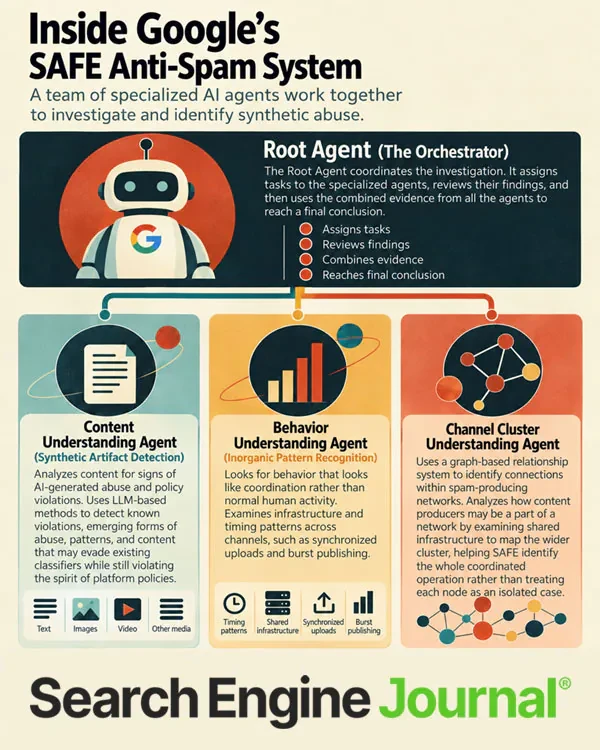
Google раскрыл архитектуру спам-детектора SAFE: четыре ИИ-агента ищут ботов по смыслу
Google второго июня опубликовал исследование о системе SAFE (Scaled Abuse Forensics Examiner), которая автоматически находит ИИ-спам на платформе, имитируя…
Google обновление алгоритма против спама: четвёртое за 2026 год, раскатка до двух недель
Google четвёртый раз за 2026 год обновил систему автоматического обнаружения поискового спама, и на этот раз развёртывание может занять до двух недель вместо…
Комментарии