
Большие языковые модели разобрали 474 712 строк автосервиса: точность 96%
Владимир Терехин из компании «РОЛЬФтех» описал, как его команда привела в порядок справочник автосервиса из 474 712 строк с помощью большой языковой модели, и этот опыт полезен каждому, кто работает с запущенными базами данных.
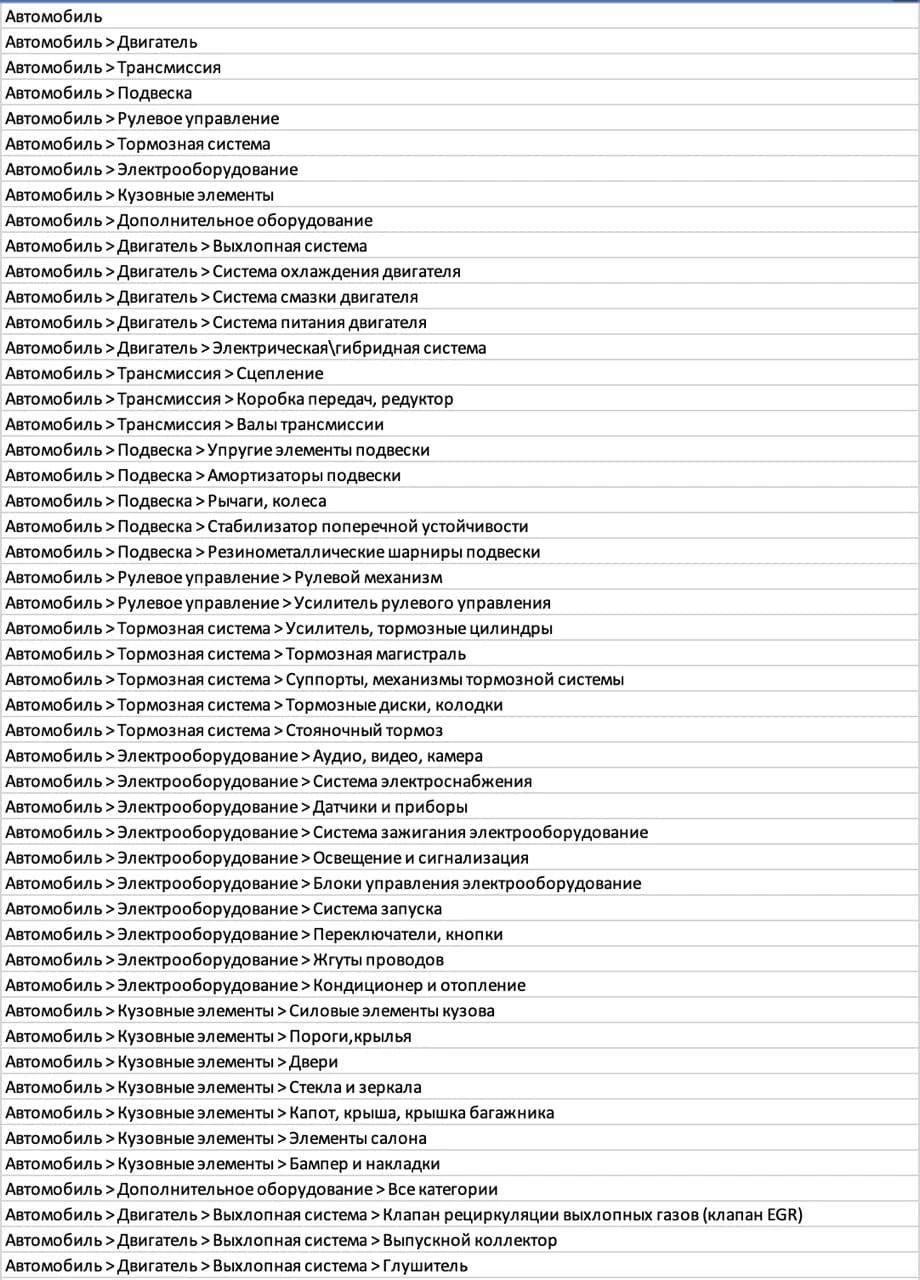
Справочник копился 35 лет без единого стандарта: сокращения, опечатки, записи на разных языках. Большие языковые модели позволили нормализовать массив до уровня, при котором для 96,13% работ после удаления дублей эксперты подтвердили корректный узел автомобиля.
Статья Владимира Терехина на Хабре показывает реальный кейс «РОЛЬФтех», где команда разрабатывает Dealer Digital Platform «Флора». Проект ещё не завершён, но основная часть нормализации пройдена. Ценность истории в том, что описаны конкретные ошибки: отказ от полнотекстового поиска, многократная перестройка работы с LLM (большой языковой моделью, то есть нейросетью, которая понимает и генерирует текст) и экспертами, а также промах в оценке производительности более чем втрое.
Что за хаос был в справочнике?
Строка «НАР РУЧКУ ДВЕРЬ РАСПАШ З ПР С/У» не ошибка кодировки. Это реальное название сервисной работы. Часть записей пришла из справочников автопроизводителей на английском, немецком, французском. Часть переводилась в разные годы разными системами. Часть сотрудники дилерских центров заводили вручную, без стандарта.
Опытный мастер-консультант с десятью или двадцатью годами практики считывает такие сокращения по контексту. Но специалист по записи клиентов не обязан обладать той же насмотренностью и вынужден идти к коллеге уточнять.
Для аналитиков проблема ещё острее: запрос «покажи динамику замен передних тормозных колодок» превращается в ручной сбор десятков вариантов написания одной операции.
Что понадобится
Если вы хотите повторить подобную нормализацию для своих данных, вот минимальный набор:
- Доступ к большой языковой модели с поддержкой длинного контекста (авторы использовали LLM для классификации; подойдут и российские сервисы, например YandexGPT или GigaChat, если задача не требует специфичной мультиязычной базы)
- Выгрузка вашего справочника в табличном формате (CSV, Excel), с указанием всех полей: название работы, код, марка, дата создания
- Дерево узлов или категорий, к которому вы хотите привязать записи. В кейсе «РОЛЬФтех» это справочник узлов автомобиля: Автомобиль, Двигатель, Система смазки, Масляный фильтр и так далее
- Эксперты предметной области для валидации результатов (минимум два цикла проверки)
- Время: первые два месяца команда потратила не на код, а на сбор проблематики, интервью со специалистами и стейкхолдерами
Пошаговая инструкция
-
Соберите проблематику до кода. Поговорите с пользователями справочника: кто и как ищет записи, где спотыкается, какие варианты написания одной операции встречаются. В «РОЛЬФтех» на это ушло два месяца интервью со специалистами по записи, мастерами-консультантами и аналитиками.
-
Подготовьте и согласуйте целевой справочник узлов. Это «координатная сетка», к которой вы будете приводить старые записи. Без неё LLM некуда классифицировать.
-
Проведите дедупликацию (удаление дублей). Прежде чем отправлять массив в большую языковую модель, уберите точные и почти точные копии. Это резко сокращает объём работы для следующих шагов.
-
Настройте промпт (prompt, текстовую инструкцию для модели) для классификации. Передайте модели дерево узлов и попросите для каждой строки определить, к какому узлу она относится. Пример промпта:
Ты — эксперт по сервисным работам в автодилерском центре.
Тебе дано дерево узлов автомобиля и название работы из старого справочника.
Определи, к какому узлу дерева относится эта работа.
Если строка содержит сокращения, расшифруй их по контексту.
Если невозможно определить узел однозначно, укажи "не определён" и поясни почему.

Дерево узлов:
[вставьте ваше дерево]

Работа: НАР РУЧКУ ДВЕРЬ РАСПАШ З ПР С/У
-
Верните результат экспертам на проверку. Команда «РОЛЬФтех» провела два цикла экспертной валидации. Без этого шага автоматическая классификация остаётся гипотезой.
-
Возвращайте экспертный фидбек в правила и навыки ИИ-агента (agent, программа, которая выполняет задачи самостоятельно по заданным правилам). Если эксперт исправил привязку, это исправление должно стать новым правилом для модели, иначе она повторит ошибку на похожих строках.
-
Замерьте точность и зафиксируйте метрику. В кейсе «РОЛЬФтех» итоговый показатель составил 96,13% подтверждённых корректных узлов после дедупликации.
Входная строка справочника: «НАР РУЧКУ ДВЕРЬ РАСПАШ З ПР С/У»
Модель расшифровала сокращения: «Наружная ручка двери распашной задней правой, снятие/установка».
Классификация по дереву узлов: Кузов, Двери, Дверь задняя правая распашная, Наружная ручка.
Действие: Снятие и установка.
До нормализации аналитик не мог агрегировать эту строку с другими записями о дверных ручках. После привязки к узлу все варианты написания одной операции собираются в одну группу автоматически.
Полнотекстовый поиск не работает. Команда «РОЛЬФтех» сначала пробовала этот путь и отказалась: при таком уровне сокращений и опечаток обычный поиск по совпадению слов не справляется.
Переоценка скорости. Авторы ошиблись более чем втрое в оценке производительности на одной из задач. Закладывайте запас по времени минимум в три раза от оптимистичной оценки.
Пропуск экспертной валидации. Большие языковые модели галлюцинируют (галлюцинация, это когда модель уверенно выдаёт несуществующий факт). Без живого эксперта, который знает марку и контекст, ошибки классификации просочатся в продакшен.
Одноразовый промпт. Если не возвращать исправления экспертов обратно в правила агента, модель будет повторять одни и те же ошибки на похожих строках. Настройте цикл: ошибка, исправление, новое правило.
Что делать с этим прямо сейчас, по ролям
Автору Дзена и копирайтеру. Если вы ведёте канал про авто, сервис или бизнес-процессы, этот кейс показывает, что «навести порядок в базе» с помощью LLM реально и без команды из двадцати разработчиков. Это тема для разбора или серии постов: как ИИ разбирает старые данные.
Маркетологу. Грязные справочники, это не только автосервис. CRM, каталоги товаров, базы услуг копят дубли годами. Метод «дерево категорий плюс LLM плюс эксперт» переносится на любые исторические данные. Поговорите с вашими аналитиками: возможно, у вас те же 35 лет хаоса, просто в другой отрасли.
Предпринимателю в РФ и СНГ. Подход работает с любой большой языковой моделью, включая доступные в России YandexGPT и GigaChat. Ключевое ограничение не в модели, а в наличии экспертов для валидации и в качестве дерева категорий, которое вы подготовите заранее.
Этот кейс ценен не технологией, а честностью. Команда открыто говорит: ошиблись втрое в оценке сроков, отказались от первого подхода, дважды гоняли результат через экспертов. По моему опыту, именно так и выглядит реальное внедрение LLM в любой бизнес: не «подключил API и всё заработало», а циклы проб, экспертных правок и постепенного улучшения.
Честная оговорка: проект «Флора» ещё не завершён, финальные цифры могут измениться. Но сам метод (дедупликация, классификация через LLM, два раунда экспертной проверки, возврат ошибок в правила агента) уже проверен на массиве из 474 712 строк. Это достаточно, чтобы пробовать на своих данных.
Главный вывод из этой истории прост: если у вас есть старый справочник, который «понимают только два человека в компании», это не повод его терпеть. Выгрузите данные, постройте дерево категорий, прогоните через LLM и отдайте результат экспертам на проверку. Два цикла валидации дадут вам базу, с которой сможет работать любой новый сотрудник, а не только тот, кто помнит сокращения из 1990-х.
Попробуйте промпты для работы с данными
В библиотеке dzen.guru собраны готовые промпты для классификации, нормализации и анализа текстовых данных с помощью нейросетей
Открыть библиотеку
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Nvidia на Disrupt 2026: open source AI и закрытые модели выгоднее совмещать
TechCrunch Disrupt 2026 выведет на сцену двух директоров Nvidia, чтобы разобрать, когда стартапу выгоднее строить продукт на открытой модели (open source AI),…
Нейросеть для дизайна интерьера: тест 4 сервисов на одном фото комнаты
Нейросеть для создания дизайна интерьера позволяет за пять минут увидеть свою комнату после ремонта, и для этого достаточно фотографии с телефона, а не…
Google вывела ИИ на подиум: не мод на искусственный интеллект в Майнкрафт, а реальная мода
Google накануне Нью-Йоркской недели моды представила два специализированных инструмента на базе Google Flow, своей ИИ-студии для творческих задач, которые…
Комментарии