
Baseten привлекла $13 млрд: Radeon для инференса нейросетей и борьба за TFLOPS
Компания Baseten, специализирующаяся на инфраструктуре для инференса (выполнения запросов к нейросетям в реальном времени), привлекла 13 миллиардов долларов и вошла в клуб так называемых «декакорнов», стартапов с оценкой свыше 10 миллиардов, на волне резкого роста спроса на оптимизацию работы открытых моделей.
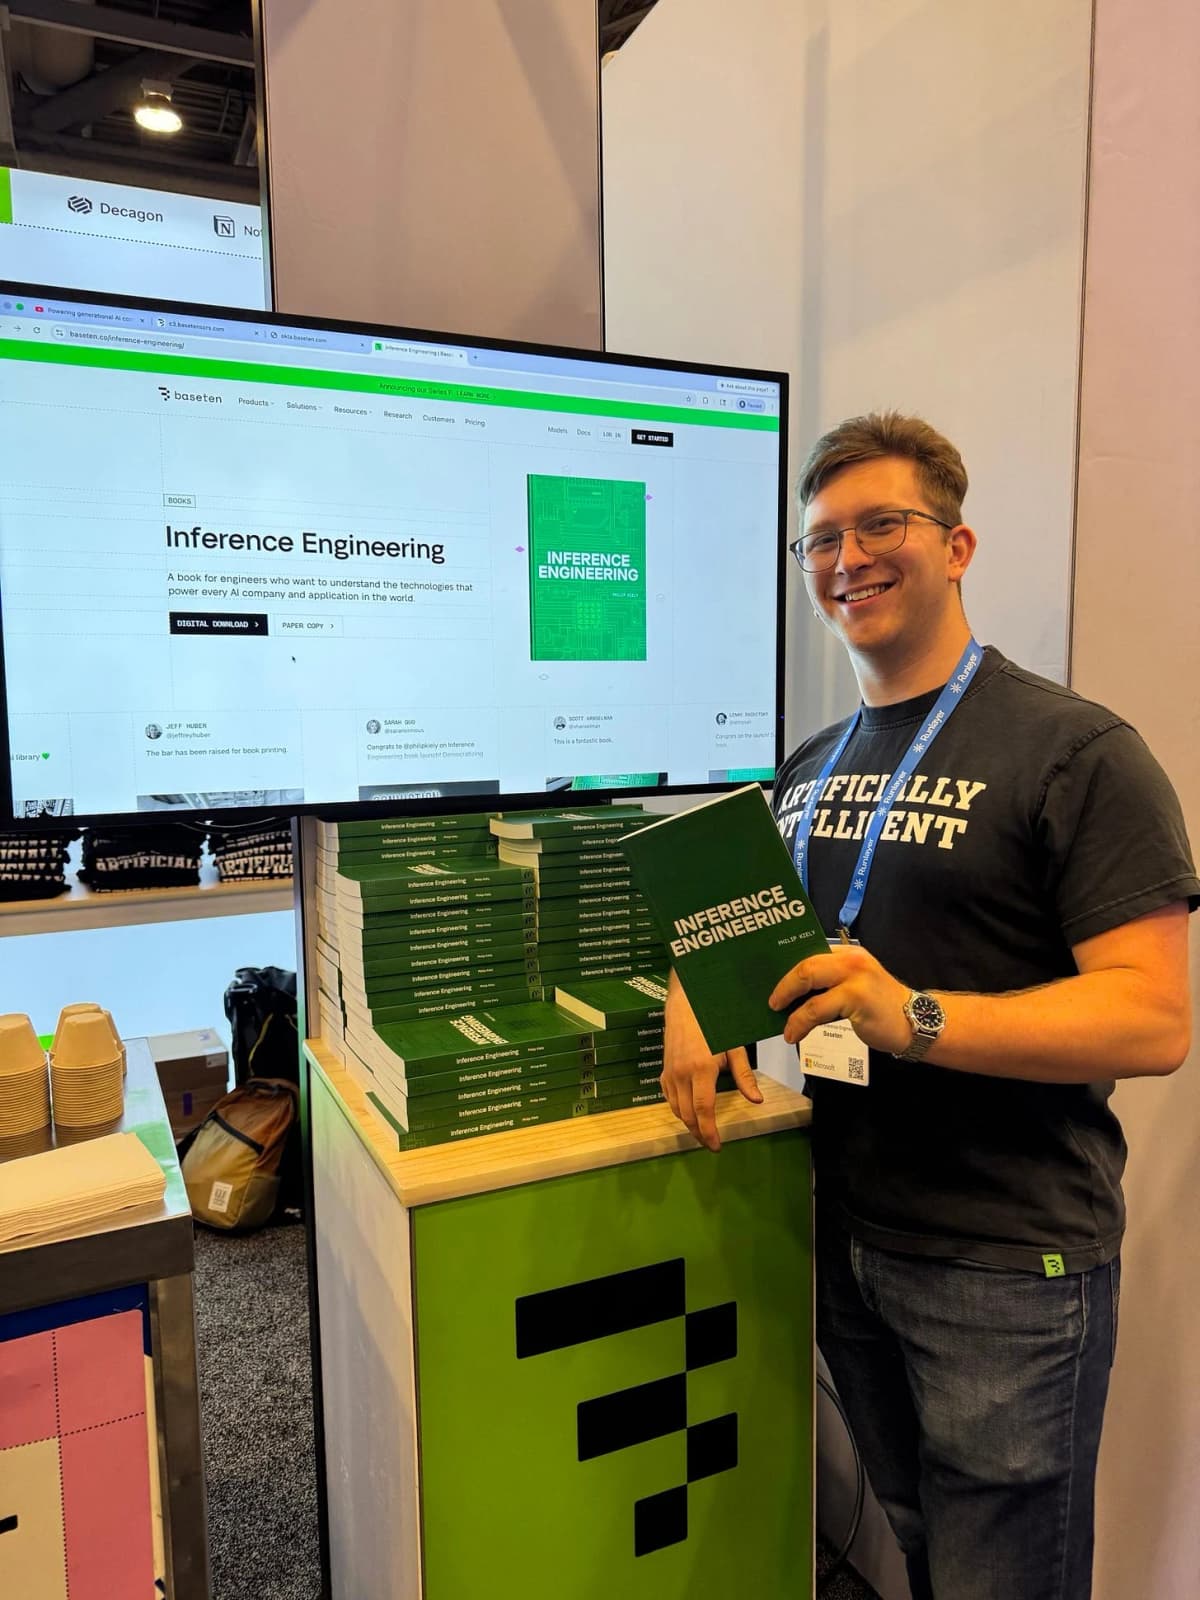
Инференс перестал быть финальным шагом после обучения модели и превратился в отдельную инженерную дисциплину со своими задачами, инфраструктурой и специализированными ролями: деньги теперь идут не только в создание моделей, но и в то, чтобы они работали быстро и дёшево.
| Параметр | Значение |
|---|---|
| Компания | Baseten |
| Сумма раунда | $13 млрд |
| Тип сделки | Раунд финансирования (точный тип не раскрыт) |
| Дата | 2025 год (точная дата не названа) |
Зачем нужны 13 миллиардов на «последнюю милю» нейросетей?
Baseten решает задачу, которую три года назад почти никто не формулировал: как превратить обученную модель с открытыми весами (open weights), когда разработчик публикует параметры модели и любой может её запустить, в быстрый, надёжный и доступный по цене API для реального продукта.
Именно на этом этапе обнаруживается, что одна и та же модель может работать с разной скоростью на разных кластерах GPU, а ошибки квантизации (упрощения модели для ускорения) в разных слоях иногда компенсируют друг друга. По данным Baseten, в одном из экспериментов с моделью GLM-5.2 более агрессивная квантизация сохранила качество на бенчмарках и одновременно увеличила пропускную способность на 20%.
Речь идёт не о процентах: по заявлениям инженеров Baseten, оптимизация инференса способна дать прирост от 20% до 200%, а в отдельных случаях ускорить модель до 10 раз. Для тех, кто платит за каждый запрос к нейросети, разница между «работает» и «работает в десять раз быстрее» измеряется прямыми расходами.
Что именно оптимизируют и при чём тут Radeon для инференса нейросетей (TFLOPS)?
Инженеры Baseten работают сразу на нескольких уровнях. Вот ключевые направления:
- Маршрутизация с учётом кэша (cache-aware routing): система направляет запрос на тот GPU, где уже сохранены результаты предыдущих вычислений, вместо того чтобы считать заново.
- Разделение prefill и decode: этап подготовки контекста и этап генерации токенов выполняются на разных GPU, каждый оптимизирован под свою задачу.
- Спекулятивное декодирование: маленькая быстрая модель «угадывает» следующие токены, а большая только проверяет, что экономит вычислительные ресурсы.
- Квантизация: модель переводится в формат с меньшей точностью чисел, что снижает требования к памяти и повышает скорость. Тот самый случай, когда ошибки в разных слоях могут компенсировать друг друга.
- Параллелизм: модель распределяется по нескольким GPU (тензорный, экспертный и конвейерный параллелизм).
Вопрос мощности GPU и производительности в терафлопсах (TFLOPS, триллионах операций с плавающей запятой в секунду) здесь критичен. Инженеры Baseten отмечают, что такие гигантские модели, как Kimi K3, требуют оборудования класса GB300 от NVIDIA. Именно поэтому выбор видеокарт для инференса нейросетей, будь то линейка NVIDIA или Radeon для инференса нейросетей с их собственными показателями TFLOPS, становится инфраструктурным решением, а не просто покупкой железа.
Интересная деталь: Baseten сумели «привить» визуальный энкодер модели Kimi к языковой модели GLM-5.2 без изменения самой языковой модели. Более того, GLM-5.2 помогла оптимизировать ядра (kernels), которые обслуживают её саму, то есть модель участвовала в улучшении собственной инфраструктуры.
Три года назад инженерия инференса едва существовала как категория. Сегодня это одна из самых критичных дисциплин в ИИ. : Baseten, из описания подкаста AI Engineer
Почему открытые модели меняют экономику инференса?
Раунд Baseten пришёлся на пик дискуссии об открытых весах (open weights debate 2026). Релиз DeepSeek, волна интереса к Kimi K3, доступность GLM-5.2 создали ситуацию, где мощные модели выложены публично, но запустить их в продакшне дорого и технически сложно.
Именно здесь появляется рынок: компании готовы платить за инфраструктуру, которая превращает «мы сгенерировали токен» в стабильный, быстрый продукт. По словам инженеров Baseten, при запросе на 200 000 токенов система должна маршрутизировать, кэшировать и распределять нагрузку так, чтобы пользователь получил ответ за приемлемое время.
Отдельно обсуждается локальный инференс: по формулировке Baseten, «локальный ИИ нужен, чтобы сделать модели менее глупыми, а дата-центровый, чтобы сделать их менее медленными». Это разные задачи с разной экономикой.
Что это значит для вас?
Авторам на Дзене и копирайтерам. DeepSeek и Kimi K3 доступны как открытые модели. Но «доступны» не значит «быстро работают»: без оптимизированной инфраструктуры генерация длинного текста может занимать минуты. Если вы используете API открытых моделей через сторонние сервисы, спрашивайте провайдера о скорости инференса и методах оптимизации. Разница в цене между оптимизированным и неоптимизированным сервисом бывает пятикратной.
Маркетологам и предпринимателям. Раунд Baseten означает, что инфраструктура инференса становится отдельным рынком. Для российских проектов, работающих с открытыми моделями DeepSeek или Kimi, это сигнал: стоит оценить, сколько вы тратите на вычисления, и искать провайдеров, которые применяют квантизацию и спекулятивное декодирование. В РФ прямого аналога Baseten пока нет, но такие платформы, как VK Cloud и Yandex Cloud, начинают предлагать оптимизированный инференс для ряда открытых моделей.
Тем, кто строит инфраструктуру. Выбор GPU для инференса нейросетей (включая сравнение TFLOPS у NVIDIA и Radeon для инференса нейросетей) перестаёт быть вопросом «какая карта мощнее». Архитектура обслуживания, маршрутизация запросов, разделение этапов вычислений дают больший прирост скорости, чем простое наращивание TFLOPS.
13 миллиардов на компанию, которая не обучает модели, а «всего лишь» запускает чужие, говорят о сдвиге ценности в индустрии. По моим наблюдениям, для русскоязычных авторов и небольших команд это хорошая новость: чем больше инвестиций идёт в инференс, тем быстрее и дешевле становится доступ к мощным открытым моделям. Но есть оговорка: Baseten и подобные сервисы ориентированы на англоязычный рынок, а в России ситуация с доступом к мощным GPU ограничена санкциями. Практический шаг прямо сейчас: если вы работаете с DeepSeek или другой открытой моделью через API, попросите провайдера уточнить, используется ли квантизация и какой метод обслуживания применяется. Это может сократить ваши расходы без потери качества.
Инференс превращается из технической детали в самостоятельную отрасль с миллиардными ставками. Для тех, кто работает с нейросетями в России, главный вывод: модель можно скачать бесплатно, но запустить её быстро и дёшево стоит денег, и именно за это теперь борются крупнейшие инвесторы мира.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
11 часов бесплатного видео: как собрать reasoning модель с нуля на PyTorch
Компания Sebastian Raschka (автор книги «Build a Large Language Model (From Scratch)») 3 июня 2025 года выложила в открытый доступ восемь видеолекций общей…
Kimi AI выпустила открытую модель на 2,8 трлн параметров и обошла закрытых конкурентов
Kimi AI выпустила модель с 2,8 триллиона параметров, которая 22 октября 2026 года обошла закрытые аналоги в независимых тестах и станет доступна с открытыми…
«Ты и есть команда»: Анеха Сохал из Moshi объясняет, почему один инженер с ИИ не заменит отдел
Moshi — рекомендательный движок для трейдеров на стыке рыночных данных и ИИ, который основала Анеха Сохал после карьеры в JPMorgan, — стал поводом для…
Комментарии