
Авито раскрыла архитектуру кластера для обучения нейросети: GPU, InfiniBand, Kubernetes
Распределённое обучение больших языковых моделей (LLM, large language model) на собственных GPU остаётся задачей, которую большинство команд в России решают вслепую, потому что публичных кейсов с деталями инфраструктуры почти нет.
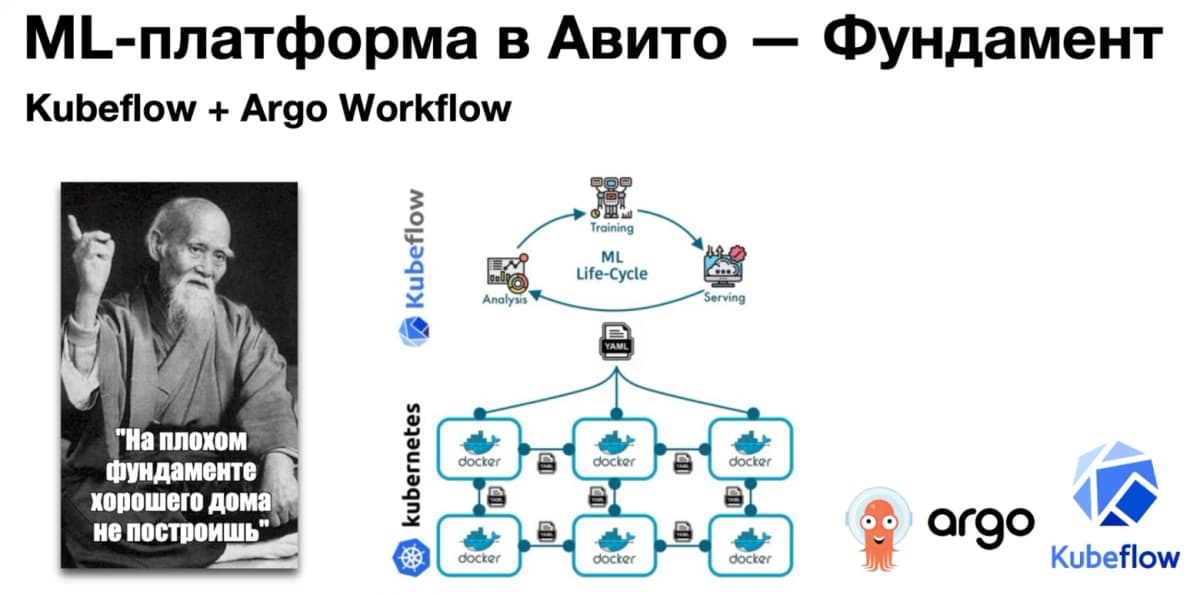
Авито открыто описала полный путь от SSH-доступа к машинам до облачно-нативной платформы распределённого обучения на собственном кластере, и это редкий для российского рынка разбор, где названы конкретные компоненты, топология сети и выбор оркестратора.
Павел, старший разработчик ML-платформы Авито, рассказал на конференции Kuber Conf, как компания за полтора года перешла от разрозненных DevBox-машин к платформе Aviflow. Материал ценен тем, что описывает не абстрактную архитектуру, а реальную инфраструктуру российской компании для нейросети обучение которой требует нескольких GPU одновременно.
Зачем вообще распределять обучение?
Когда модель и данные не помещаются на одну видеокарту, обучение делят между несколькими вычислительными узлами (воркерами). Есть две базовых парадигмы.
- Параллелизм данных. Модель целиком копируется на каждый воркер. Каждый получает свой кусок обучающих данных (training data). Во время обучения воркеры синхронизируются и выдают итоговую модель с конечными весами.
- Параллелизм модели. Данные одинаковы для всех воркеров, но каждый хранит свой фрагмент модели. Вариации: распределённый градиент, распределённые параметры или оба сразу.
Гибридные схемы совмещают оба подхода. Именно так устроено нейросети обучение на масштабах, которые нужны для LLM.
Что понадобится
- Вычислительные узлы с GPU. В Авито используют серверы HGX от Dell и Inspur.
- Высокоскоростная сеть. InfiniBand вместо Ethernet. В кластере Авито два варианта: NDR (быстрый, для вычислений) и HDR (для передачи данных). Топология кластера Fat Tree. По одному NDR-коннектору и одному HDR-коннектору на узел.
- Распределённая файловая система. Авито выбрали BeeGFS на серверах Lenovo. Метадата-сервер задублирован для отказоустойчивости. Каждая storage-нода тоже продублирована, внутри каждой поднята ZFS, всё обёрнуто buddy group.
- Холодное хранилище. Ceph для хранения датасетов до начала обучения.
- Оркестратор. Kubernetes (K8S) вместо Slurm.
- ML-платформа. Kubeflow (открытая модель платформы для ML) как основа, доработанная до внутреннего продукта Aviflow. Управление пайплайнами через Argo Workflow.
Пошаговая инструкция по запуску распределённого обучения
Ниже воспроизведён путь, который проходит пользователь Aviflow. Если вы строите собственную инфраструктуру, логика шагов та же, инструменты могут отличаться.
-
Подготовьте датасет. Соберите обучающие данные и положите их в холодное хранилище. В случае Авито это Ceph.
-
Перенесите датасет в горячее хранилище. Выгрузите данные из Ceph в BeeGFS. Горячее хранилище обеспечивает скорость чтения, которая не станет узким местом при обучении на нескольких узлах.
-
Настройте оркестратор. Авито выбрали Kubernetes, а не Slurm, по трём причинам:
- платформа Aviflow уже работала на K8S, интеграция была нативной;
- K8S позволяет использовать инференс (inference, запуск готовой модели для получения ответов) и обучение внутри одного механизма;
- экосистема K8S обновляется чаще, в том числе появляются инструменты, заточенные под LLM.
По данным Авито, перфоманс-сравнение K8S и Slurm дало почти аналогичные результаты.
- Опишите пайплайн обучения. Пайплайн (pipeline) в Kubeflow это последовательность компонентов, каждый из которых представляет собой код, обёрнутый в контейнер. Пример минимального определения компонента:
# Пример: компонент пайплайна Kubeflow
name: train-llm-step
container:
  image: your-registry/train:latest
  command: ["python", "train.py"]
  args: ["--data-path", "/mnt/beegfs/dataset"]
  resources:
    limits:
      nvidia.com/gpu: 8
-
Запустите обучение через платформу. Aviflow распределяет задачу по узлам HGX. Каждый узел читает данные из BeeGFS и пишет туда же чекпоинты (checkpoint, промежуточное сохранение состояния модели, чтобы продолжить обучение после сбоя).
-
Заберите нужные чекпоинты. Из BeeGFS перенесите в постоянное хранилище те чекпоинты, которые пойдут в дальнейшую работу: дообучение (fine-tuning), оценку качества или деплой.
До платформы: дата-сайентист заходил на DevBox по SSH, вручную блокировал машину, обучал модель, собирал датасеты. Инструменты были разрозненными, добавление LLM создавало отдельную ветку со своей спецификой.
После Aviflow: весь цикл, от анализа данных и нарезки датасетов до обучения и обслуживания моделей, замкнут внутри одной платформы. Пайплайны запускаются через единый интерфейс, обучение распределяется по узлам HPC автоматически, чекпоинты сохраняются в горячем хранилище и забираются по необходимости.
Дополнительные интеграции, которые Авито добавили поверх Kubeflow: Trisigma (внутренний сервис A/B-тестирования), Vault (управление секретами), собственные notebook-среды, подключение к DWH (хранилище данных) и IDE. Плюс отчёты.
- Начинать с облака, не посчитав. Авито сознательно выбрали собственный HPC (High Performance Computing, высокопроизводительные вычисления, по сути суперкомпьютер) вместо облачных вычислений. Решение зависит от объёмов: если вы обучаете одну модель раз в квартал, облако дешевле. Если нейросети обучение идёт постоянно и на больших данных, собственный кластер окупается.
- Ставить Ethernet вместо InfiniBand. Для распределённого обучения LLM полоса пропускания между узлами критична. InfiniBand NDR обеспечивает скорость, при которой синхронизация воркеров не становится бутылочным горлышком. Ethernet на таких задачах замедляет обучение.
- Не дублировать метадата-сервер. Авито отдельно подчёркивают, что задублировали метадата-сервер BeeGFS и каждую storage-ноду. Без этого отказ одного компонента останавливает весь кластер.
- Нанимать только Slurm-специалистов, если компания на K8S. Инженеров по HPC мало, большинство работают со Slurm. Но если остальная инфраструктура на Kubernetes, гибридная схема создаёт лишнюю сложность. Авито решили развивать K8S-экспертизу внутри компании.
- Игнорировать горячее хранилище. Читать датасеты напрямую из холодного хранилища (Ceph) во время обучения значит получить простой GPU в ожидании данных.
Что делать с этим прямо сейчас?
Разработчику и ML-инженеру в России. Кейс Авито показывает, что распределённое обучение LLM на собственной инфраструктуре в РФ реально без зарубежных облаков. Набор Kubeflow плюс Argo Workflow плюс BeeGFS плюс InfiniBand покрывает базовые потребности. Все компоненты опенсорсные, кроме железа.
Автору на Дзене и контент-маркетологу. Тема «как российские компании строят свои ИИ-кластеры» пока не заезжена. Разбор конкретного стека (названия серверов, файловой системы, оркестратора) привлекает техническую аудиторию и отличается от потока обзоров ChatGPT.
Предпринимателю и руководителю. Если ваша команда обучает модели на арендованных GPU, просчитайте порог, после которого собственный HPC дешевле. Авито сделали этот выбор осознанно, «проанализировав все вводные». Решение не универсально: оно работает при постоянной загрузке кластера и наличии инженерной команды.
Открытых технических кейсов по распределённому обучению LLM от российских компаний пока единицы. Авито назвали конкретные модели серверов, тип сети, файловую систему и причины выбора Kubernetes вместо Slurm. Для тех, кто строит собственную ML-инфраструктуру в условиях ограниченного доступа к западным облакам, это готовый чеклист компонентов.
Честная оговорка: Авито не раскрыли бюджет, количество узлов и время обучения конкретных моделей. Повторить их путь без сопоставимых ресурсов (закупка HGX, InfiniBand-коммутаторов, наём HPC-инженеров) не получится. Для небольших команд разумнее начать с российских облачных GPU (Yandex Cloud, SberCloud) и переходить к собственному кластеру, когда загрузка станет постоянной.
Подпишитесь на dzen.guru
Разбираем кейсы нейросетей и ИИ-инструментов для авторов, маркетологов и предпринимателей в РФ. Практика без воды.
ПодписатьсяПлатформа Авито показала, что путь от SSH-доступа к распределённому обучению LLM на десятках GPU занимает полтора года и требует трёх вещей: железа с InfiniBand, опенсорсной ML-платформы и команды, готовой развивать K8S-экспертизу вместо привычного Slurm.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Авито делит GPU в Kubernetes как Meta: опыт после KubeCon Japan 2026
Компания Авито второго июня поделилась опытом внедрения инструментов распределения GPU в Kubernetes для нейросетей после конференции KubeCon Japan 2026, где…
FPGA для нейросетей за $50: инженер запустил LLM без GPU на плате с AliExpress
Почему это важно Русскоязычный инженер собрал работающий ИИ-ускоритель на FPGA за 50 долларов и запустил на нём языковую модель без видеокарты NVIDIA, доказав,…
TechCrunch Disrupt 2026 ждёт 10 000 участников: скидка до $100 сгорает через 4 дня
TechCrunch Disrupt 2026 пройдёт 13-15 октября в Сан-Франциско, и до закрытия онлайн-скидок на билеты остаётся четыре дня, после чего цены вырастут до «дверных»…
Комментарии