
Авито делит GPU в Kubernetes как Meta: опыт после KubeCon Japan 2026
Компания Авито второго июня поделилась опытом внедрения инструментов распределения GPU в Kubernetes для нейросетей после конференции KubeCon Japan 2026, где шесть ключевых докладов оказались зеркалом задач, которые российская команда уже решает на практике.
Две трети мирового ИИ-вычислительного ресурса теперь уходит на инференс (запуск готовых моделей для ответов пользователям), а не на обучение, и компании вынуждены делить дорогие видеокарты между командами. Опыт Авито показывает, что открытые инструменты Kubernetes GPU уже работают в российском продакшене.
MLOps-инженер Авито Антон Алексеев побывал на KubeCon + CloudNativeCon Japan 2026 в Иокогаме (28-30 июля) и разобрал шесть докладов о распределении GPU и LLM-инференсе (запуске больших языковых моделей). Его наблюдение: почти каждый спикер повторял одну и ту же мысль: видеокарты дорогие, их надо делить. Авито решает ту же задачу на собственной ML-платформе, построенной на Kubeflow, и уже использует или тестирует инструменты, о которых говорили на сцене.
| Что | Когда | Кто выпустил / рассказал | Цена |
|---|---|---|---|
| Kueue TAS (планировщик задач с учётом топологии GPU) | v0.17, статус alpha | Google, Meta | Бесплатно, опенсорс |
| HAMi (программное деление GPU между контейнерами) | Перешёл в incubating CNCF | Dynamia, SNOW (NAVER) | Бесплатно, опенсорс |
| llm-d (горизонтальное масштабирование vLLM) | Проекту чуть больше года | CNCF-сообщество | Бесплатно, опенсорс |
| NVIDIA AI Cluster Runtime (AICR) | Анонс на KubeCon Japan 2026 | NVIDIA | Не раскрыта |
| Kubernetes AI Conformance | Запуск на KubeCon Japan 2026 | CNCF | Не раскрыта |
Инференс обогнал обучение: что это значит?
Два года назад большая часть вычислительных мощностей для ИИ шла на обучение моделей. Сейчас пропорция перевернулась: две трети ресурсов уходит на инференс, то есть на обслуживание запросов пользователей к уже готовым нейросетям. Конференция стартовала именно с этой цифры.
По прогнозу McKinsey, к 2030 году инференсу понадобится более 93 ГВт мощности. Исполнительный директор CNCF Джонатан Брайс (Jonathan Bryce) отметил, что это превышает текущее потребление всех вычислений в мире. Для авторов и предпринимателей цифра означает одно: запуск ИИ-сервисов дорожает, и умение экономить GPU становится конкурентным преимуществом.
Какие инструменты Kubernetes GPU обсуждали?
-
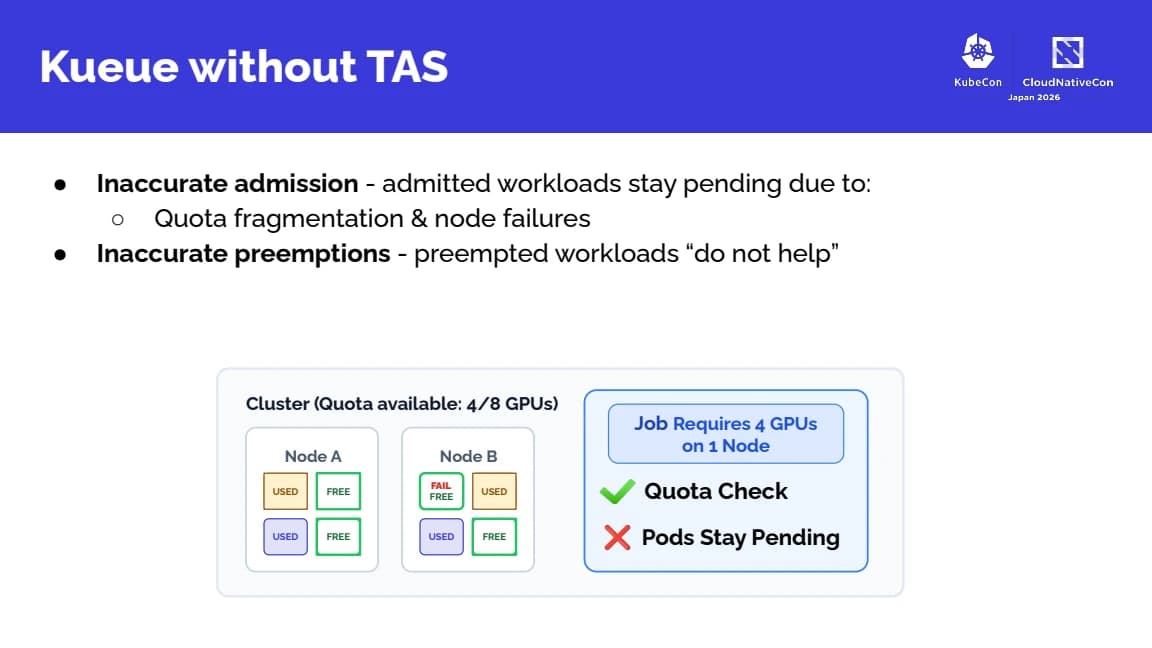
Kueue TAS (Topology-Aware Scheduling, планирование с учётом физического расположения видеокарт). Обычный планировщик видит свободные GPU, но не знает, на одном ли сервере они стоят. Если задаче нужны четыре карты на одной машине, а они разбросаны по двум, задача зависает. TAS решает это: администратор описывает топологию (стойка, зал, сервер), и Kueue распределяет задачи с учётом физики. Meta Superintelligence Lab переезжает на Kubernetes с этим инструментом для кластеров на NVIDIA GB200 и GB300.
-
HAMi (Heterogeneous AI Model Integration). Программная прослойка, которая перехватывает вызовы к видеокарте и позволяет двум контейнерам делить одну GPU. Компания SNOW (дочка южнокорейского NAVER) использовала HAMi, чтобы запустить дообучение (fine-tuning) и инференс в одном поде (минимальная единица запуска в Kubernetes). Результат: вдвое меньше GPU при том же объёме работы.
-
llm-d. Проект для горизонтального масштабирования vLLM (популярного движка для запуска больших языковых моделей). За счёт кэширования и умной маршрутизации запросов llm-d выдаёт заметно больше производительности, чем стандартная балансировка нагрузки по GPU.
-
NVIDIA AI Cluster Runtime (AICR). Версионированные рецепты GPU-кластера: драйвер, операторы, ядро, среда выполнения, упакованные в готовые наборы для инструментов развёртывания Helm, Argo CD или Flux.
-
Kubernetes AI Conformance. Новая сертификация ИИ-платформ от CNCF по образцу обычного Kubernetes-соответствия. Идея: ИИ-нагрузка запустится на любой сертифицированной платформе без доработок.
Как Авито решает те же задачи?
Опыт Авито ценен тем, что показывает: инструменты с мировой конференции уже работают внутри российского продакшена.
Kueue используется как основной планировщик ИИ-нагрузок на ML-платформе Авито. Очереди построены на иерархических когортах (группах команд с общим пулом ресурсов). У каждой команды две очереди: Regular (использует чужие простаивающие GPU) и Prod (держит гарантированный объём и при необходимости забирает ресурсы обратно). TAS включён, видеокарты HGX H100 пакуются по InfiniBand-домену (высокоскоростной сети между картами).
HAMi в Авито тоже тестировали. Компания SNOW после внедрения HAMi смогла обслужить тот же трафик вдвое меньшим количеством карт. Для автоскейлинга (автоматического добавления мощностей при росте нагрузки) SNOW использует KEDA с метрикой доли занятых воркеров, а не загрузку GPU, которая, по наблюдению Алексеева, для разнородных задач «врёт».
Как попробовать?
- Установите Kueue в свой Kubernetes-кластер по официальной документации на сайте проекта kueue.sigs.k8s.io. Минимально нужен кластер версии 1.26 и выше с доступными GPU-нодами.
- Для деления одной видеокарты между контейнерами разверните HAMi из репозитория проекта на GitHub (Project-HAMi). HAMi перехватывает вызовы CUDA и не требует правок вашего кода.
- Если запускаете LLM-инференс, попробуйте llm-d поверх vLLM: проект доступен на GitHub и масштабирует запросы горизонтально с кэшированием.
- Следите за программой Kubernetes AI Conformance от CNCF: когда сертификация станет массовой, выбор ИИ-платформы упростится до проверки значка соответствия.
Есть ли аналоги для российских компаний?
Kueue, HAMi и llm-d работают с любым Kubernetes-кластером, в том числе развёрнутым в российских облаках (Yandex Cloud, VK Cloud, Selectel). Специфических российских аналогов этих инструментов нет: это опенсорс-проекты CNCF, доступные без ограничений.
Для самого инференса в России доступны YandexGPT и GigaChat, но они работают как облачные API, а не как инструменты для распределения собственных GPU. Если ваша компания держит свои видеокарты и запускает модели с открытыми весами, стек Kueue + HAMi + vLLM применим напрямую.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена. Если вы используете локальные нейросети для генерации текстов или изображений, HAMi позволит запустить два инструмента на одной видеокарте. Раньше одна модель занимала всю карту, теперь ресурс делится программно.
Маркетологу. Стоимость инференса растёт, и скоро это отразится на ценах ИИ-сервисов. Компании, которые научились делить GPU, смогут держать цены ниже. Следите за тем, как ваши подрядчики управляют вычислениями.
Предпринимателю в РФ. Все описанные инструменты бесплатны, имеют открытый код и работают в российских облаках. Опыт Авито показывает, что внедрение Kueue и HAMi в продакшен реально силами небольшой MLOps-команды без закупки проприетарных решений.
Я вижу в этом материале редкий случай, когда российская компания не просто слушает доклады на мировой конференции, а приходит с готовым опытом. Авито уже использует Kueue как основной планировщик, тестирует HAMi и делится замерами. Для рынка РФ это полезнее любого пересказа зарубежного кейса: конфигурации, грабли и метрики получены на реальном трафике.
Оговорка: статья описывает опыт одной компании, и масштаб Авито (тысячи GPU) отличается от типичного стартапа с парой карт. Не всё перенесётся один к одному.
Что сделать сегодня: если у вас есть хотя бы два GPU-сервера и Kubernetes, поставьте Kueue и попробуйте очереди с приоритетами. Это бесплатно и занимает пару часов. Результат увидите на первой же задаче, которая раньше висела в очереди.
Частые вопросы
Нужны ли дорогие NVIDIA H100 для этих инструментов?
Нет. Kueue и HAMi работают с разными поколениями видеокарт. HAMi поддерживает и более ранние карты серии A100, и потребительские GPU. Для учебных задач и небольшого инференса подойдут даже карты уровня RTX 4090.
Можно ли использовать Kueue без глубоких знаний Kubernetes?
Базовое понимание Kubernetes потребуется: нужно уметь создавать кластер, применять манифесты и читать логи подов. Но Kueue не требует замены стандартного планировщика, он работает поверх него. Документация проекта содержит пошаговые примеры, рассчитанные на инженеров среднего уровня.
Законно ли использовать эти инструменты в России?
Все перечисленные проекты имеют открытые лицензии (Apache 2.0) и распространяются через CNCF без географических ограничений. Санкционные ограничения касаются поставок оборудования NVIDIA, а не программного обеспечения с открытым кодом.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Amazon и Microsoft отказались от NDA при строительстве дата центров: сотни мораториев вынудили
Почему это важно Amazon отказывается от соглашений о неразглашении при строительстве дата-центров, и это уже тенденция: Microsoft сделала то же самое ранее в…
Бот ВКонтакте на ChatGPT за 20 минут: собираем в GPTunneL без кода
Автор Дзена, маркетолог или владелец сообщества ВКонтакте может за полчаса собрать бот ВКонтакте ChatGPT в конструкторе GPTunneL без единой строчки кода и…
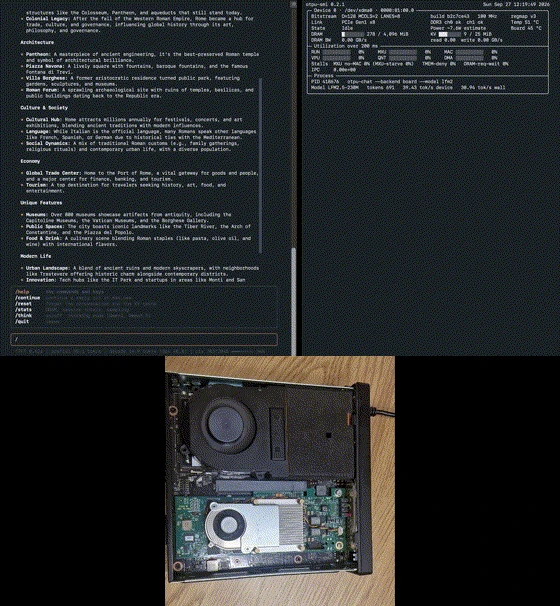
FPGA для нейросетей за $50: инженер запустил LLM без GPU на плате с AliExpress
Почему это важно Русскоязычный инженер собрал работающий ИИ-ускоритель на FPGA за 50 долларов и запустил на нём языковую модель без видеокарты NVIDIA, доказав,…
Комментарии