
Аренда сервера с GPU: восемь скрытых статей расходов, которые удваивают бюджет
Аренда сервера с GPU: почему дешёвый тариф часто обходится дороже, и как считать бюджет правильно.
Компании выбирают облачную площадку для ИИ по цене часа GPU, а потом обнаруживают перерасход к середине проекта, потому что реальный бюджет складывается из простоев, хранилища, сети и времени инженеров.
Аренда сервера с GPU по минимальному тарифу не равна минимальной стоимости проекта: отчёт SemiAnalysis выделяет восемь составляющих полной стоимости GPU-кластера, и сам GPU лишь одна из них.
Михаил Воронин, менеджер продукта GPUaaS (GPU как сервис, когда видеокарты предоставляются в аренду через облако) в K2 Cloud, разобрал, из чего на самом деле складывается бюджет ИИ-проекта. Главный тезис: прайс-лист описывает цену ресурса, а не цену выполненной работы. Две площадки с одинаковыми GPU могут дать кратно разную итоговую сумму.
Что понадобится
- Понимание задачи: дообучение (fine-tuning, обучение модели на ваших данных под конкретную задачу), инференс (inference, обработка запросов готовой моделью) или RAG-контур (система, которая подтягивает ответы из вашей базы знаний).
- Список вопросов к поставщику (см. инструкцию ниже).
- Калькулятор или таблица для сравнения TCO (Total Cost of Ownership, полная стоимость владения) по восьми параметрам.
- Примерно 2 часа на первичный аудит одного провайдера.
Как посчитать реальную стоимость аренды сервера с GPU?
-
Запросите у провайдера не только тариф за час GPU, а полный перечень из восьми статей расходов. По данным отчёта SemiAnalysis, TCO GPU-кластера включает: аренду GPU, хранение, сеть, управление кластером (control plane), поддержку, простой и потерю производительности из-за отказов, начальную настройку, последующую отладку.
-
Оцените потребность в хранилище. Для обучения нужны исходные данные, промежуточные результаты, контрольные точки (checkpoint, сохранённое состояние модели в процессе обучения), логи и артефакты экспериментов. Мультимодальные (multimodal, работающие с текстом, изображениями, видео и аудио одновременно) модели добавляют к этому медиафайлы и синтетические данные. В исследовании SemiAnalysis приводится диапазон от 2 до 25 ТБ хранения на один GPU в зависимости от нагрузки.
-
Проверьте скорость хранилища, а не только его объём. Медленное хранилище превращает GPU в дорогой ресурс ожидания: ускорители простаивают, пока система читает и записывает данные. Это касается и аренды сервера с GPU под инференс: задержка при обращении к базе знаний напрямую влияет на скорость ответа пользователю.
-
Уточните пропускную способность сети и возможность связать облако с вашей инфраструктурой. При обучении GPU постоянно обмениваются параметрами. При инференсе сеть связывает модель с хранилищем данных и внешними сервисами. Отдельно спросите про стоимость публичных IP-адресов, балансировщиков, исходящего трафика, передачи данных между регионами и операций с объектным хранилищем.
-
Обсудите SLA (Service Level Agreement, соглашение об уровне обслуживания) не только по доступности, но и по операционным показателям. Ключевые метрики: среднее время обнаружения сбоя, срок замены или восстановления узла, наличие резервных мощностей. Даже при небольшом количестве GPU простой инференс-сервиса означает потерю выручки и ухудшение пользовательского опыта.
-
Посчитайте стоимость собственной команды. Для устойчивой работы в продуктиве нужны компетенции в MLOps (практики вывода моделей в продакшен), DevOps, SRE (инженерия надёжности), системах хранения, сетях, информационной безопасности и оркестрации. Таких специалистов на рынке мало, поиск занимает месяцы. Если инженер тратит время на диагностику сетевых библиотек вместо работы над моделью, это тоже расход.
-
Сравните две площадки не по прайсу, а по проектной экономике. Площадка с более высоким тарифом, но с готовой средой, протестированной сетью, резервными мощностями и инженерной поддержкой при инцидентах может оказаться дешевле по итогу проекта.
Российский сценарий: адаптация, а не обучение с нуля
В России распространён подход, когда компании берут открытые модели (open-source), не обучают их с нуля, а адаптируют под свои данные и разворачивают RAG-контуры с локальными базами знаний. В этом случае главный расход смещается: важна не подготовка датасетов для обучения, а быстрый доступ к базам знаний в момент обработки запросов.
Это означает, что при выборе площадки для аренды сервера с GPU под RAG нужно в первую очередь тестировать скорость хранилища и задержку сети между GPU-узлом и хранилищем. Экономия на тарифе GPU при медленном диске сводится к нулю, потому что модель ждёт данные.
Две компании арендуют одинаковые GPU для RAG-сервиса.
Компания А выбрала площадку с минимальным тарифом. Среда разворачивалась три дня вместо нескольких часов. Хранилище оказалось медленным: при каждом запросе к базе знаний GPU простаивал. Мониторинг настраивали отдельно, сбой обнаружили спустя часы. Итог: GPU-часы оплачены, но половина из них потрачена на ожидание данных и восстановление после инцидентов.
Компания Б выбрала площадку с тарифом выше на 15 процентов. Среда была готова за часы, хранилище протестировано заранее, при сбое подключился инженер провайдера. GPU работали на полезную нагрузку, а не на ожидание. Итоговый бюджет проекта оказался ниже.
- Сравнивать площадки только по цене GPU-часа. Это один параметр из восьми. Без оценки хранилища, сети и поддержки сравнение бессмысленно.
- Не закладывать стоимость простоев. Для инференс-сервисов каждый час недоступности означает потерю выручки и репутационный ущерб.
- Считать, что своя команда справится бесплатно. Специалисты по ML-инфраструктуре стоят дорого, и их время на отладку чужих проблем тоже расход.
- Игнорировать сетевые расходы. Публичные IP, балансировщики, исходящий трафик, межрегиональная передача незаметны в пилоте, но ощутимы в продуктиве.
- Выбирать хранилище по цене терабайта, а не по скорости. Медленный диск обесценивает быстрый GPU.
Что делать прямо сейчас, по ролям?
Автору на Дзене или копирайтеру. Если используете локальные модели для генерации текстов, проверьте, не тормозит ли хранилище при загрузке базы знаний. Иногда перенос базы на быстрый SSD ускоряет ответы заметнее, чем апгрейд видеокарты.
Маркетологу. Перед согласованием бюджета на ИИ-инструменты запросите у подрядчика или провайдера разбивку по всем восьми статьям TCO. Одна строка «аренда GPU» в смете означает, что остальные расходы будут сюрпризом.
Предпринимателю в РФ и СНГ. Сценарий «адаптация открытой модели плюс RAG с локальной базой» сейчас основной на российском рынке. При выборе провайдера тестируйте скорость хранилища и связность с вашей инфраструктурой до подписания договора. K2 Cloud, Yandex Cloud, Selectel предлагают GPU-серверы, но условия по хранилищу и сети у каждого свои.
По моим наблюдениям, большинство команд в России начинают считать полную стоимость аренды сервера с GPU только после первого перерасхода. Статья Воронина полезна тем, что даёт конкретный чек-лист из восьми пунктов до подписания договора. Честная оговорка: автор представляет K2 Cloud, поэтому материал стоит читать как экспертный разбор с коммерческим контекстом. Восемь параметров TCO из отчёта SemiAnalysis при этом универсальны и применимы к любому провайдеру. Рекомендую запросить у двух-трёх площадок разбивку по всем восьми статьям и сравнить не тарифы, а итоговые суммы на горизонте квартала.
Проверять провайдера по прайс-листу, всё равно что выбирать квартиру по цене квадратного метра, не спросив про коммунальные платежи, ремонт и время до метро. Восемь вопросов к поставщику до подписания договора обойдутся дешевле, чем один пересчёт бюджета в середине проекта.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Большие языковые модели пробуют учить без роста весов: накопления знаний пока нет
Компания или автор представляет не готовый продукт, а промежуточные результаты открытого исследования по архитектуре LANN-4, название расшифровывается как…
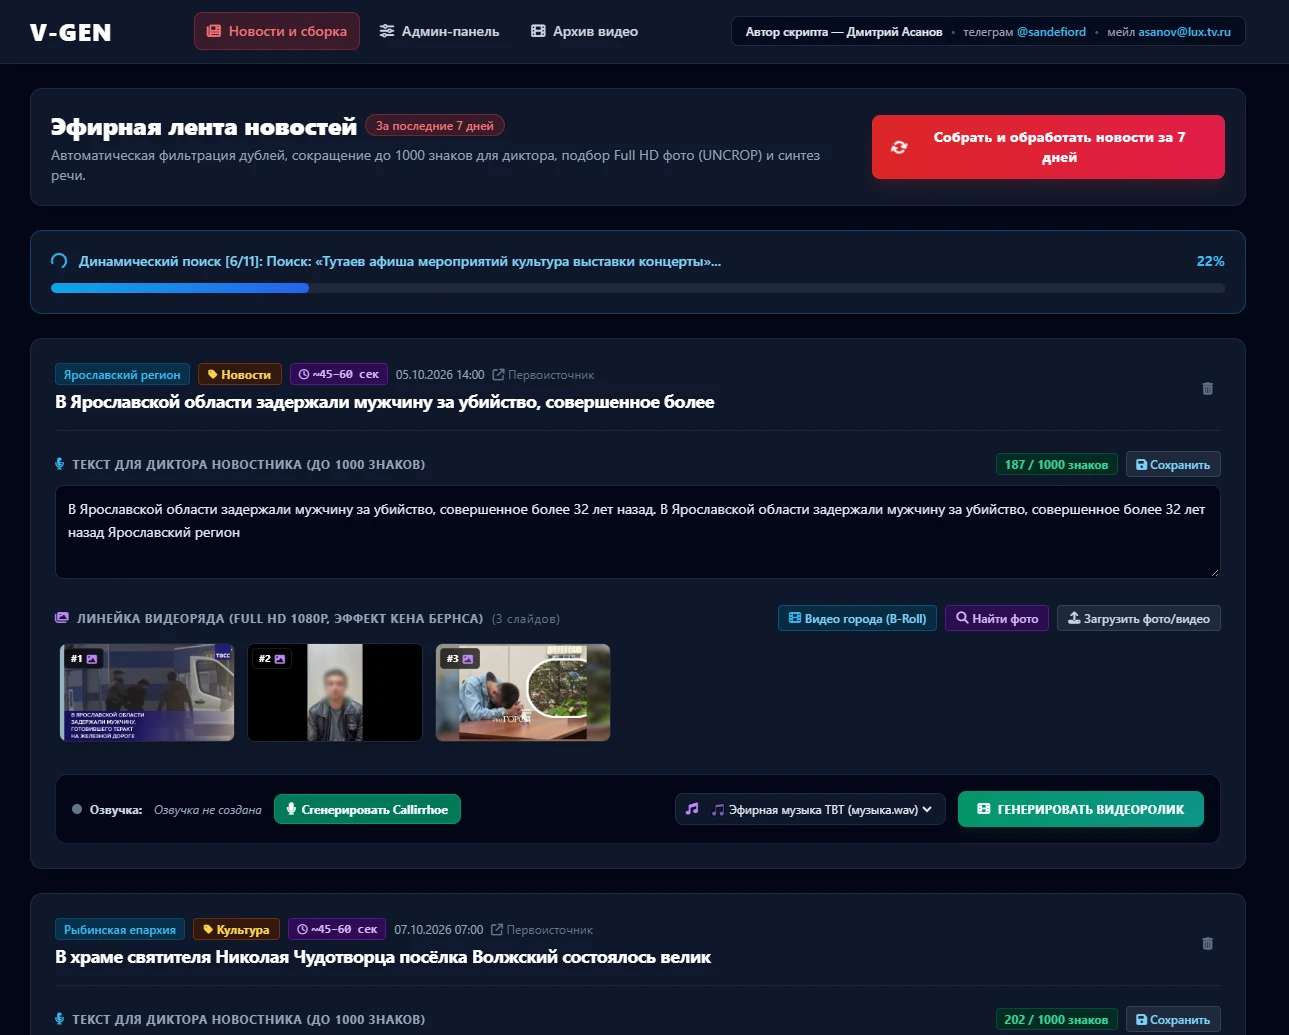
Нейросеть для генерации видео V-GEN: от поиска новости до готового ролика без команды
Нейросеть для генерации видео, которая сама находит новости, пишет текст, озвучивает и монтирует готовый эфирный ролик, уже существует как открытый проект на…
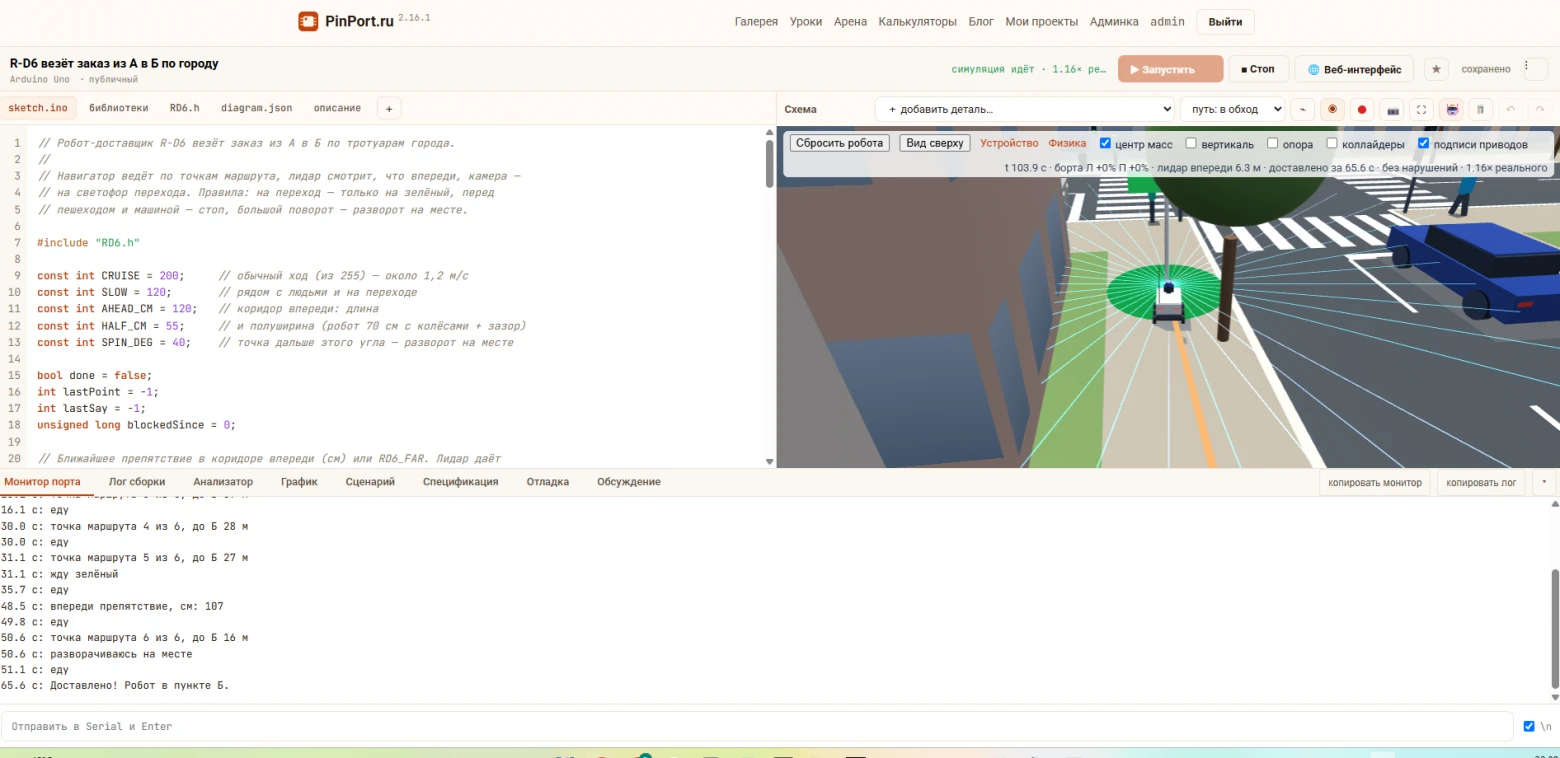
Робот-курьер в браузере: PinPort запустил 3D-город для обучения на реальных скетчах Arduino
Почему это важно Впервые образовательный симулятор робота-курьера работает прямо в браузере, без покупки железа: ученик пишет настоящий скетч Arduino, а…
Комментарии