
AI ассистент в медицине теряет контекст: как команда «Я Здоров» разделила память на 11 блоков
Медицинские ИИ-ассистенты теряют контекст между сеансами, и простое хранение всех данных в одном файле только усугубляет проблему: команда приложения «Я Здоров» нашла рабочую архитектуру и описала путь от первой версии до текущей.
Если ai ассистент медицина не различает «пациент не сообщал об аллергии» и «пациент подтвердил, что аллергий нет», рекомендация может навредить. Разобранный ниже подход показывает, как разделить память на управляемые блоки и не перегружать модель лишними данными.
Команда ASAP, которая разрабатывает мобильное приложение «Я Здоров», опубликовала разбор своей архитектуры долгосрочной памяти, LTM (Long-Term Memory, механизм сохранения фактов между сеансами диалога). Приложение собирает медицинские данные пользователя в цифровой профиль: результаты анализов, дневники здоровья, оцифрованные документы. В чате пользователь сообщает ИИ-ассистенту о симптомах, препаратах, аллергиях. Часть этих сведений нужна не только в текущем разговоре, но и при следующих обращениях, и именно здесь начинаются сложности.
Почему «один большой файл» не работает?
Первая версия LTM выглядела просто: всё, что ассистент извлекал из диалогов, складывалось в единый JSON-объект (текстовый файл с набором пар «ключ и значение»). При каждом ответе этот объект целиком передавался в контекст LLM (большой языковой модели, на которой построен ассистент).
По мере накопления данных обнаружились три проблемы.
- Контекст раздувался. Модель получала всю историю здоровья, хотя для конкретного вопроса нужна лишь часть. Лишние факты занимали токены (единицы текста, которые модель обрабатывает за один проход) и снижали точность.
- История изменений терялась. Новое значение просто заменяло старое. Если врач сначала назначил препарат, потом пациент начал его принимать, а позже дозировку изменили, в JSON оставалось только последнее состояние. Восстановить цепочку событий было невозможно.
- Пустое поле не отличалось от подтверждённого отсутствия. Если запись об аллергии пуста, неясно: пользователь ещё не обсуждал тему или прямо сказал «аллергий нет». Для ai ассистент медицина это критичная разница: известную аллергию нужно учитывать в рекомендациях по питанию, а «не знаю» и «не спрашивали» требуют разных следующих шагов.
Что понадобится
Если вы строите похожую систему или хотите повторить подход на своём проекте:
- LLM с поддержкой системного промпта (системный промпт, начальная инструкция, задающая модели роль и правила) и структурированного вывода (JSON mode или function calling)
- Серверная логика для валидации и хранения фактов (база данных с поддержкой версионирования записей)
- Разделение на синхронный и асинхронный контуры (очередь задач или фоновый обработчик)
- Набор правил извлечения фактов по каждому разделу памяти
- Время на проектирование: команда ASAP прошла две итерации архитектуры
Пошаговая инструкция
-
Разбейте память на предметные разделы. Команда «Я Здоров» выделила 11 разделов: лекарства, симптомы, диагнозы, хронические состояния, демографические данные, образ жизни, аллергии, операции, травмы, вакцинации, семейный анамнез. Каждый раздел хранится и обрабатывается отдельно.
-
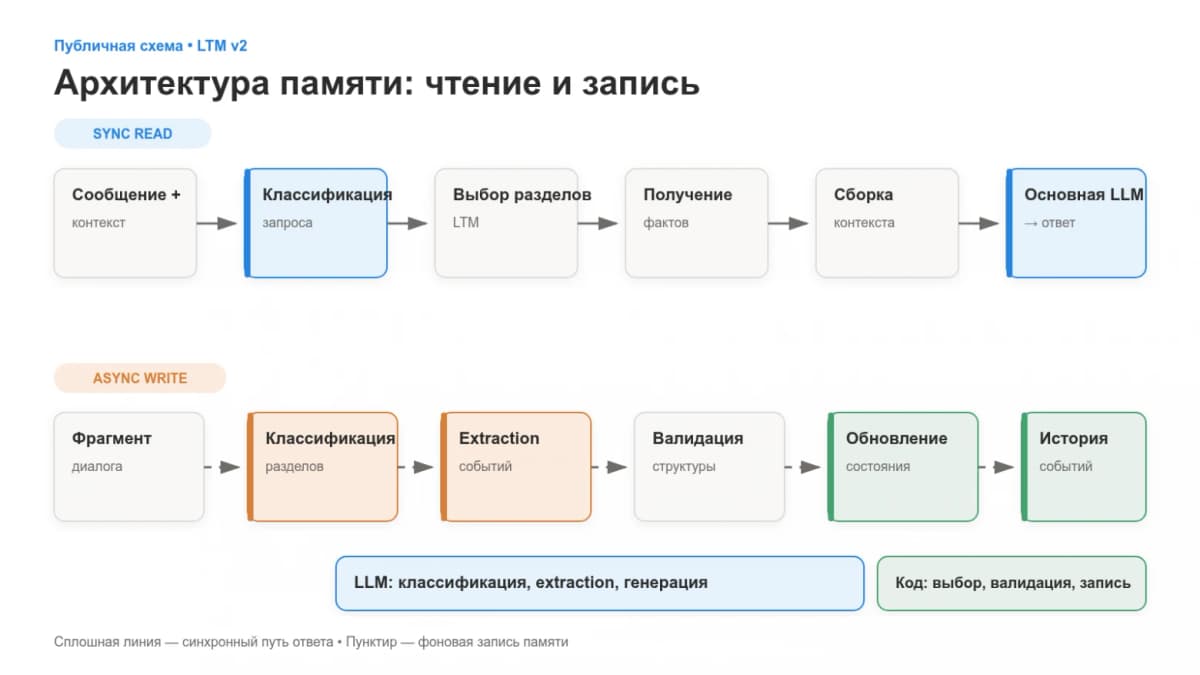
Разделите чтение и запись. Чтение (read-path) работает синхронно: когда пользователь задаёт вопрос, система определяет, какие разделы LTM нужны, достаёт из них факты и добавляет в контекст модели. Запись (write-path) работает в фоне: после завершения фрагмента диалога отдельный процесс разбирает новую информацию и обновляет память. Так извлечение фактов не замедляет ответ пользователю.
-
Используйте LLM только для понимания смысла, а состоянием управляйте кодом. Путь записи выглядит так:
- LLM-классификатор определяет, какие разделы памяти затронуты в разговоре
- Экстрактор получает правила только для выбранного раздела и извлекает структурированное событие
- Программная валидация проверяет типы полей и допустимые значения
- Код сопоставляет событие с существующими фактами и определяет тип изменения: первое упоминание, подтверждение, изменение или отрицание
Пример промпта для классификатора (упрощённо):

Определи, какие разделы медицинской памяти затронуты
в следующем фрагменте диалога.
Допустимые разделы: allergies, medications, symptoms,
chronic_conditions, demographics, lifestyle, surgeries,
injuries, vaccinations, family_history, diagnoses.
Верни только список затронутых разделов в формате JSON.
-
Фиксируйте подтверждённое отсутствие явно. Для аллергий, хронических заболеваний и семейного анамнеза «нет аллергий» записывается как отдельный факт со статусом «confirmed_absent». Пустое поле означает только одно: тема ещё не обсуждалась.
-
Храните историю изменений, а не только текущее состояние. Каждое событие (назначение препарата, смена дозировки, отмена) фиксируется отдельной записью с меткой времени. Текущее состояние вычисляется из цепочки событий, а не заменяет предыдущее значение.
Пользователь пишет в чат: «У меня аллергия на арахис». LLM-классификатор относит реплику к разделу allergies. Экстрактор извлекает структуру: аллерген «арахис», тип «пищевая», статус «активна». Код проверяет валидность, не находит существующей записи об арахисе и создаёт новый факт. При следующем обращении, когда пользователь спрашивает про диету, read-path подтягивает только раздел аллергий (а не все 11 разделов) и передаёт его в контекст модели. Ассистент учитывает арахис в ответе.
- Передавать всю память в контекст при каждом запросе. Это расходует токены и размывает точность ответа. Отбирайте только нужные разделы.
- Доверять LLM управление идентификаторами и временными метками. Модель хорошо понимает смысл, но технические поля (ID записи, тип изменения, дата) надёжнее генерировать программно. Галлюцинация (когда модель уверенно выдумывает то, чего не было) в идентификаторе приведёт к потере или дублированию факта.
- Не различать «данных нет» и «пользователь подтвердил отсутствие». Это ошибка с медицинскими последствиями: ассистент будет переспрашивать о том, что уже выяснено, или, хуже, пропустит важную информацию.
- Обновлять память после каждой реплики. Лучше анализировать связный фрагмент диалога целиком: так экстрактор видит контекст и реже ошибается.
Что делать с этим прямо сейчас, по ролям
Разработчику медицинского ИИ-ассистента: архитектура «разделённая память плюс два контура» решает три конкретных боли. Начните с малого: выделите хотя бы аллергии и лекарства в отдельные разделы, добавьте статус «confirmed_absent» и разнесите чтение с записью.
Автору Дзена, пишущему про здоровье и технологии: разбор «Я Здоров» даёт конкретный кейс для контента. Читателям интересно не абстрактное «ИИ в медицине», а именно такие детали: почему ассистент иногда забывает, что вы говорили неделю назад, и как это чинят.
Предпринимателю в РФ: приложение «Я Здоров» и команда ASAP работают на российском рынке. Описанная архитектура не привязана к конкретному провайдеру LLM и может использовать доступные в России модели, включая YandexGPT или GigaChat (по моим наблюдениям, оба поддерживают работу с системным промптом и структурированным выводом, хотя детали реализации отличаются).
Подход команды ASAP ценен не столько кодом, сколько мышлением: они чётко разделили, что делает LLM (понимает смысл), а что делает программная логика (управляет состоянием). Это правило применимо далеко за пределами медицины. Если вы строите любого ИИ-агента (программу, которая сама выполняет цепочку действий) с памятью между сеансами, запомните: модели нельзя доверять роль базы данных. Она инструмент извлечения смысла, а хранение, версионирование и валидация остаются за классическим кодом. Честная оговорка: команда описала архитектуру, но не привела метрик точности извлечения фактов и не раскрыла, какую именно LLM использует. Без этих данных оценить надёжность системы в клинических сценариях невозможно.
Узнайте, как ИИ меняет работу авторов
Подпишитесь на dzen.guru и получайте разборы практических кейсов с нейросетями каждую неделю
ПодписатьсяГлавный урок из этого кейса укладывается в одну фразу: LLM понимает смысл, а состоянием памяти управляет код. Кто усвоит это разделение, сэкономит месяцы переделок, независимо от того, строите вы медицинского ассистента или чат-бота для интернет-магазина.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Together Link подключает Claude Code AI к открытым моделям: экономия до 80% на токенах
Компания Together AI выпустила Together Link, бесплатную утилиту командной строки с открытой лицензией MIT, которая позволяет подключать шесть популярных…
Selectel протестировал AI-ускорители Zhenwu 810E: 1 536 ГБ памяти, но полная зависимость от Alibaba
Alibaba выпустила собственный AI-ускоритель Zhenwu 810E, и команда Selectel первой в России протестировала его для облачной инфраструктуры, столкнувшись с…
AI Studio от Сбера показала 5 рабочих сценариев: чем она закрывает задачи Google AI Studio в РФ
Google AI Studio здесь ни при чём: речь о российской платформе AI Studio от Сбера, и именно её сценарии стоит разобрать, потому что для команд в РФ это рабочий…
Комментарии