
88% ИИ-пилотов проваливаются без обвязки: как довести LLM в продакшене до результата
Почему это важно Восемь из десяти корпоративных ИИ-пилотов не доходят до рабочего продукта, и причина почти никогда не в самой модели: не хватает…
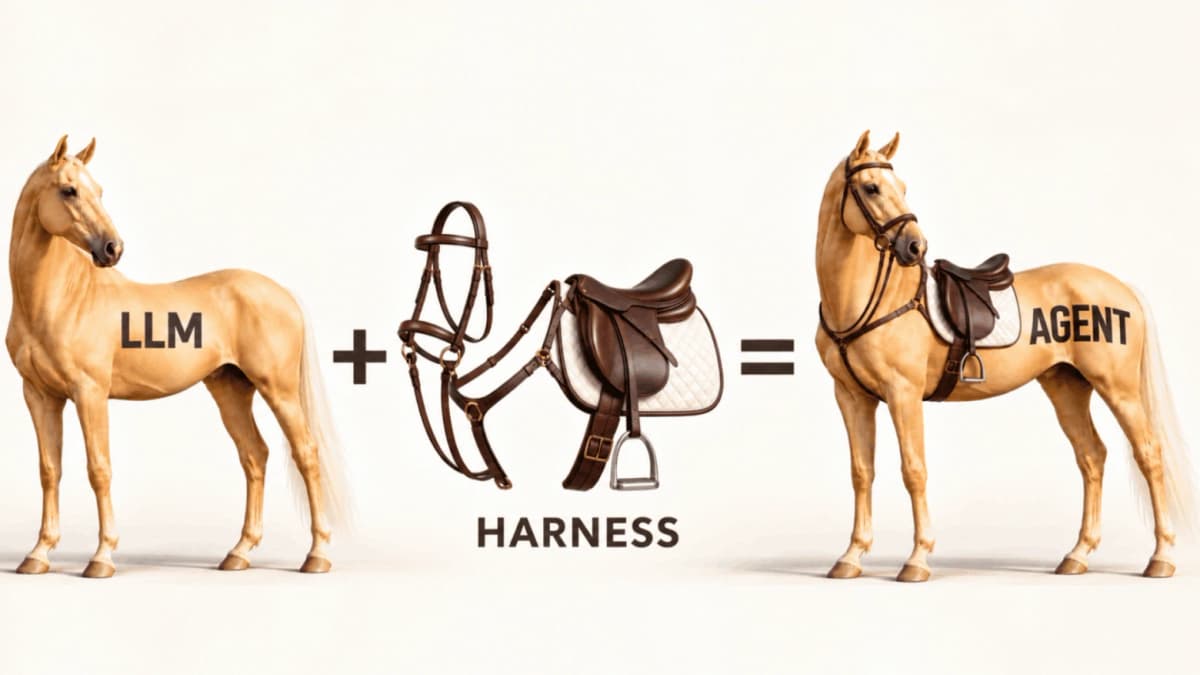
Восемь из десяти корпоративных ИИ-пилотов не доходят до рабочего продукта, и причина почти никогда не в самой модели: не хватает инфраструктуры вокруг неё, той самой «обвязки», которая превращает LLM в продакшене в управляемый сервис.
Selectel опубликовал практическое руководство по инфраструктуре, без которой большая языковая модель остаётся лабораторным экспериментом, а 2 июня материал вышел на «Хабре» и сразу затронул болевую точку: компании скачивают модель, запускают на сервере с GPU, получают первый ответ и думают, что дело сделано.
На деле между работающей моделью и готовым бизнес-сервисом лежит целый слой компонентов. Его называют обвязкой, или harness. Сюда входят интерфейс для пользователей, API для приложений, аутентификация, подключение корпоративных данных, интеграции с внутренними системами, логирование запросов и контроль расходов. Именно обвязка решает, кому доверять, что разрешать и когда передать решение человеку. Без неё LLM в продакшене не появится, останется только LLM на сервере.
| Что | Когда | Кто опубликовал | Цена |
|---|---|---|---|
| Руководство по обвязке LLM для бизнес-сервисов | Июнь 2025 | Selectel (блог на «Хабре») | Бесплатно (открытая статья) |
Из чего состоит обвязка и зачем каждый слой?
-
Интерфейс или API. Модель сама по себе принимает текст и выдаёт текст. Чтобы ею пользовались не только инженеры, нужен веб-чат, бот в мессенджере или программный интерфейс для другого приложения. Готовое решение: Open WebUI даёт веб-интерфейс и подключает модели через OpenAI-совместимый API.
-
Контекст и корпоративные данные. Базовая модель не знает ваших регламентов, каталога товаров и внутренних инструкций. Подход RAG (retrieval-augmented generation, генерация с подгрузкой нужных документов из базы знаний) добавляет актуальные фрагменты прямо в запрос. Инструменты: встроенный RAG в Open WebUI, отдельный сервис RAGFlow.
-
Интеграции и действия. Когда сервис должен не просто написать текст, а найти клиента в CRM, создать заявку или отправить письмо, модель формирует структурированный запрос к заранее описанному инструменту (tool calling), а код выполняет действие и возвращает результат. Low-code платформа n8n связывает ИИ-компоненты с CRM, ERP, почтой и чатами без написания кода с нуля.
-
Лимиты, стоимость и отказоустойчивость. Каждый запрос к модели стоит денег и занимает время. ИИ-агент (программа, которая сама решает, какие действия выполнить) может зациклиться и вызвать модель десятки раз подряд. Обвязка ограничивает число шагов и токенов (единиц текста, которыми модель считает объём) на один запрос, кэширует повторяющиеся вопросы и переключает простые задачи на дешёвую модель, а сложные направляет на более мощную.
-
Аутентификация и контроль доступа. Модель не знает, кто отправил запрос и имеет ли этот человек право видеть запрошенные данные. Без проверки прав доступа любой сотрудник может случайно получить конфиденциальную информацию.
Почему 88% пилотов не доходят до продукта?
Статья приводит показательную статистику: из 33 корпоративных ИИ-пилотов до продакшена добираются в среднем четыре. Это 12% успеха. Узкое место почти никогда не сама модель. Компании выбирают сильную LLM, получают хорошие ответы на тестовых примерах и останавливаются, потому что дальше нужно строить всё перечисленное выше.
Авторы используют аналогию: модель как двигатель, обвязка как вся машина. У двигателя нет тормозов, руля и ограничителя скорости. Без обвязки агент может зациклиться, забыть про ограничения доступа или допустить несанкционированное вмешательство в логику работы.
Даже история диалога не является встроенной «памятью» модели. Приложение само сохраняет нужные сообщения и при следующем запросе передаёт их в контексте. Для пользователя это выглядит как непрерывный разговор, но технически каждый раз модель «начинает с чистого листа».
Как попробовать?
-
Развернуть Open WebUI с Ollama. Open WebUI даёт веб-интерфейс, Ollama (инструмент для локального запуска открытых моделей) запускает LLM на вашем сервере. В статье упоминается готовый преднастроенный образ в ИИ-маркетплейсе Selectel, где всё собрано в одном контейнере.
-
Подключить корпоративные данные через RAG. Загрузите внутренние документы в хранилище, настройте поиск по ним. При запросе пользователя система сама найдёт нужный фрагмент и передаст модели вместе с вопросом.
-
Настроить интеграции через n8n или tool calling. Опишите инструменты (CRM, почта, внутренний API), которые модель может вызывать. Модель формирует структурированный запрос, код выполняет действие.
-
Установить лимиты. Ограничьте число шагов агента на один запрос, задайте потолок токенов, настройте переключение на резервную модель при недоступности основной.
Российские аналоги: что доступно внутри страны?
Для российских компаний доступны YandexGPT и GigaChat от Сбера. Оба предоставляют API для интеграции в бизнес-приложения. Принцип обвязки тот же: модель сама по себе отвечает на запросы, но без интерфейса, аутентификации, подключения к внутренним данным и контроля расходов она не станет рабочим сервисом.
Отличие в том, что Open WebUI, Ollama и RAGFlow, упомянутые в статье, представляют собой открытые модели и инструменты (опенсорс), которые разворачиваются на собственных серверах и не зависят от внешнего провайдера. YandexGPT и GigaChat работают как облачные закрытые модели с API по подписке. Для компаний, которым критична изоляция данных, опенсорс-стек на российском хостинге, например на серверах Selectel, может оказаться единственным вариантом.
Что это значит для вашей работы?
Автору Дзена. Если вы используете нейросеть для черновиков или рерайта, вы работаете через готовый интерфейс (ChatGPT, YandexGPT). Но если задумали собственного бота-ассистента для канала, одной моделью не обойтись: потребуется обвязка хотя бы из интерфейса, хранилища промптов (заранее заданных инструкций для модели) и ограничителя токенов, чтобы бот не сжёг бюджет за ночь.
Маркетологу. Автоматизация рассылок, генерация описаний товаров, ответы в чате поддержки: всё это требует интеграции модели с CRM и каталогом. Без обвязки каждый такой сценарий останется ручным экспериментом.
Предпринимателю в РФ. Статья подтверждает, что выбор модели составляет лишь малую часть затрат. Основная стоимость и сложность LLM в продакшене приходится на инфраструктуру: серверы с GPU, настройку доступов, логирование, мониторинг. Планируя бюджет на ИИ, закладывайте на обвязку минимум столько же, сколько на саму модель.
Статья Selectel полезна как чек-лист для тех, кто думает, что «подключить нейросеть» равно «скачать модель». По моему опыту, большинство авторов и малых команд застревают именно на этапе между «модель ответила» и «сервис работает каждый день без присмотра». Руководство не идеальное: конкретных конфигурационных файлов и пошаговых команд в нём нет, это скорее карта территории, чем маршрут. Но карта честная, потому что показывает масштаб задачи. Рекомендация: прочитайте и сопоставьте со своей задачей. Если вам нужен только чат-бот для ответов по базе знаний, хватит Open WebUI с RAG. Если нужны действия в CRM, придётся строить слой интеграций, и бюджет вырастет кратно.
Частые вопросы
Можно ли обойтись без обвязки, если модель уже работает?
Для личных экспериментов, да: отправляете запрос через терминал, получаете ответ. Для бизнес-сервиса, нет. Без аутентификации любой получит доступ. Без лимитов агент может зациклиться и потратить бюджет. Без логирования вы не узнаете, что пошло не так. Обвязка превращает «работающую модель» в «управляемый сервис».
Нужен ли сервер с GPU для запуска LLM в продакшене?
Зависит от сценария. Если запускаете открытую модель локально через Ollama, GPU необходим для приемлемой скорости. Если подключаете внешнюю модель по API (OpenAI, YandexGPT, GigaChat), GPU на вашей стороне не нужен, но появляется зависимость от провайдера и расходы на каждый запрос.
Чем RAG отличается от дообучения модели?
RAG (генерация с подгрузкой документов) подставляет актуальную информацию в запрос каждый раз заново: обновили документ, модель сразу «видит» новую версию. Дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу) меняет саму модель и требует повторного обучения при каждом обновлении данных. Для корпоративных баз знаний, которые часто обновляются, RAG проще и дешевле.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Claude оставляет скрытые идентификаторы на вашем ПК: как удалить их за минуту
Claude при работе с компьютером сохраняет скрытые идентификаторы, и вот скрипт, который их удаляет, чтобы защитить вашу приватность на русскоязычных машинах.…
Gemini 4 снова лидирует в 12 из 18 тестов: почему бенчмарки нейросетей не совпадают с реальностью
Gemini 4 Argon 30 сентября вышла с таблицей, где модель лидирует в 12 тестах из 18, и это дословное повторение февральского анонса Gemini 3.1 Pro, которая…
Что такое ИИ-агент в роли аналитика: кейс Mindbox, где 90% кода пишет машина
Почему это важно Российский кейс Mindbox показывает на практике, что такое ИИ-агент в роли аналитика: он не просто пишет код, а заранее находит ошибки и…
Комментарии