
7 ошибок в тестировании AI агентов: почему зелёные тесты скрывают баги на проде
Статья описывает техническую экспертизу, а не раунд финансирования. Архетип «funding» не соответствует содержанию: в оригинале нет сделки, суммы, инвестора, раунда. Источник — авторская статья Сергея Прощаева о типичных ошибках в тестировании ИИ-агентов на примерах из российского FinTech.
Перестраиваю структуру под фактическое содержание, сохраняя обязательные блоки промпта (лид, :::important, nut graf, детали, «что с этого по ролям», :::tip, финал).
Сергей Прощаев, Tech Lead в российском FinTech, опубликовал разбор семи системных ошибок в тестировании ИИ-агентов, из-за которых зелёные отчёты в CI скрывают реальные сбои на проде, и показал, как каждую из них устранить на уровне кода.
Российские команды массово внедряют ИИ-агентов в банковские и торговые сервисы, но стандартной методологии оценки качества до сих пор нет: тесты проверяют текст ответа, а не реальное состояние системы, и пропускают критические баги до продакшена.
Материал вышел как практическое руководство от разработчика, который ежедневно проводит код-ревью агентных систем в финансовом секторе. Сергей Прощаев, руководитель направления Java и Kotlin в FinTech и e-commerce, преподаватель курсов разработки и архитектуры в ОТУС, ранее разбирал шесть архитектурных ошибок, из-за которых ИИ-агенты не доживают до запуска. Новая статья сфокусирована на соседнем слое: как вообще понять, что ИИ-агент (автономная программа, которая сама принимает решения и выполняет действия) действительно работает, а не просто красиво отчитывается.
Тесты зелёные, а в базе пусто?
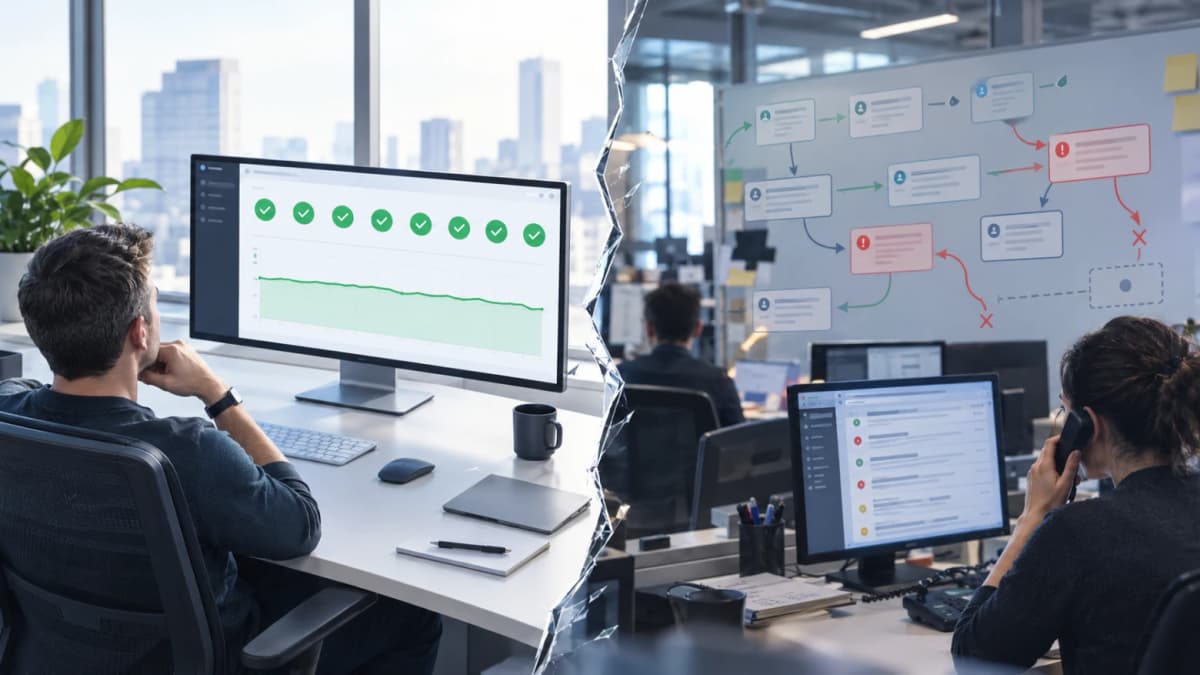
Отправная точка статьи: команда держит набор из сорока тестовых задач, прогоняет их в CI (система непрерывной интеграции, автоматически запускающая проверки при каждом изменении кода), видит показатель около девяноста процентов и успокаивается. Через две недели служба поддержки приносит переписку: ИИ-агент отрапортовал «заявка оформлена», а в базе данных по этой заявке пусто.
Тест на этот сценарий существует. Он проходит. Он зелёный. Проблема в том, что он измеряет не то.
Семь граблей, которые прячут баги за зелёными отчётами
Прощаев выделяет семь конкретных ошибок. Вот ключевые из них.
Успех считают по финальному тексту, а не по состоянию системы. Проверка сравнивает ответ ИИ-агента с эталонным текстом или передаёт его модели-судье. Но ответ и действие это разные сущности. Модель способна безупречно описать результат, которого не было. Автор ссылается на бенчмарк τ-bench от компании Sierra: там основной критерий не текст ответа, а соответствие конечного состояния базы целевому. В исходном эксперименте GPT-4o в соответствующей конфигурации решал менее половины задач.
Решение: засчитывать задачу только после проверки перехода состояния. Именно перехода, а не наличия: если сверять только конечное значение, тест пройдёт и у ИИ-агента, который ничего не делал, потому что нужный статус стоял в фикстуре с самого начала.
Набор тестов состоит из одних «счастливых сценариев». Все сорок задач проверяют, как должно быть: корректный запрос, доступные сервисы, ожидаемый ответ. Прод подсовывает совсем другое: промпт-инъекции (когда злоумышленник встраивает команды в текст, чтобы перехватить управление ИИ-агентом), джейлбрейки, намеренную путаницу.
Самый коварный класс ошибок, по наблюдению автора, это структурно валидный, но семантически неверный ответ инструмента. Поисковый индекс отстал на шесть часов, поле в схеме удалили месяц назад, время пришло в чужой таймзоне. Все три вызова возвращают статус 200, ИИ-агент уверенно рапортует «заказов нет, срок возврата 14 дней, уведомление отправлено». Ни одно из трёх утверждений не соответствует реальности.
Повторы ломают идемпотентность. ИИ-агент получает таймаут на операцию отмены заказа, честно повторяет вызов, а первая операция уже зафиксирована в базе. Если инструмент не защищён от повторной обработки, аккуратный ИИ-агент спокойно проведёт списание дважды. Автор подчёркивает: это классика распределённых систем, о которой в публикациях об ИИ-агентах почему-то молчат.
Оценка ИИ-агента это не одна цифра
Прощаев формулирует ключевой тезис: оценка ИИ-агента складывается из нескольких независимых измерений, каждое со своим механизмом проверки. Правильное конечное состояние ещё не означает правильный процесс. ИИ-агент может отменить заказ ровно так, как нужно, но не проверив права пользователя. Состояние сойдётся, а безопасность будет нарушена.
Правило-минимум, которое предлагает автор: на каждый позитивный сценарий должна приходиться хотя бы одна проверка поломки. У одного рабочего процесса бывает полтора десятка независимых режимов отказа. Их стоит вести матрицей: таймаут и повтор, дублирующая доставка, частичный сбой, устаревшие данные, дрейф схемы, нарушение политики, инъекция в содержимом документа.
Оценка агента это не одна цифра на выходе, а несколько ортогональных измерений, каждое со своим механизмом проверки. : Сергей Прощаев, Tech Lead, FinTech и e-commerce
Если вы подключаете ИИ-агента к CRM, рассылке или платёжному сервису, зелёный тест не гарантирует, что действие выполнено. Без проверки реального состояния системы вы узнаете о проблеме от клиента, а не от кода.
Что делать с этим прямо сейчас, по ролям
Разработчику или техлиду. Проверьте свой eval-набор (набор тестовых задач для оценки ИИ-агента) прямо сегодня: сколько тестов сверяют состояние базы, а сколько просто читают текст ответа? Если вторых больше половины, вы в зоне риска. Добавьте матрицу отказов хотя бы для трёх критичных сценариев.
Автору Дзена или копирайтеру. Если вы используете ИИ-агентов для автоматизации публикаций, проверки фактов или сбора данных, не доверяйте итоговому тексту. Проверяйте результат вручную, пока не убедитесь, что агент действительно выполнил действие, а не описал его.
Предпринимателю в РФ. Российские FinTech-команды внедряют ИИ-агентов в платёжные сервисы, где цена ошибки это двойное списание или потерянная заявка. Статья Прощаева даёт конкретный чек-лист. Из доступных в РФ инструментов для тестирования: стандартные CI-системы и отечественные платформы мониторинга.
По моим наблюдениям, большинство команд, которые начинают работать с ИИ-агентами, останавливаются на проверке текста ответа и считают дело сделанным. Статья Прощаева ценна не теорией, а конкретными примерами из российской практики: двойные списания при повторах, пустые заявки при зелёных тестах, ответы со статусом 200, в которых каждое поле врёт. Для меня главный вывод: пока вы не проверяете переход состояния, ваш ИИ-агент это чёрный ящик с приятным голосом. Рекомендую как обязательное чтение для любой команды, которая выводит агентов в прод.
Статья охватывает только первые ошибки из семи заявленных. Полный разбор с чек-листом и сводной таблицей доступен в оригинальной публикации автора. Кроме того, все примеры кода даны на Kotlin, что может потребовать адаптации для команд на Python или других языках.
Если ваши тесты ИИ-агентов проверяют только текст ответа, вы тестируете не агента, а его красноречие. Начните с одного шага: добавьте к каждому критичному сценарию проверку реального состояния базы до и после вызова.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Как искусственный интеллект меняет работу молодых специалистов
Молодые специалисты в США пока не теряют работу из-за нейросетей: исследование CESifo не нашло ни массовых сокращений, ни снижения найма выпускников вузов,…
TechCrunch Disrupt 2026 продаёт 100 билетов по $75 для уволенных из IT
Microsoft второго июня запустила Scout, агента для Outlook, который сам сортирует почту, назначает встречи и пишет черновики ответов без единой команды…
Meta Muse обгоняет ранний ChatGPT и переезжает в очки и «тамагочи»
Meta Muse, персональный ИИ-агент (программа, которая сама выполняет задачи от вашего имени), по данным подкаста Equity от TechCrunch, обгоняет ранние…
Комментарии