
Визуальные языковые модели видят сцену, но теряют структуру: бенчмарк MindTopo вскрыл провал в планировании
Визуальные языковые модели видят форму, но теряют структуру: новый бенчмарк MindTopo показал, где именно ИИ ломается при работе с пространственными связями, и это критично для робототехники.
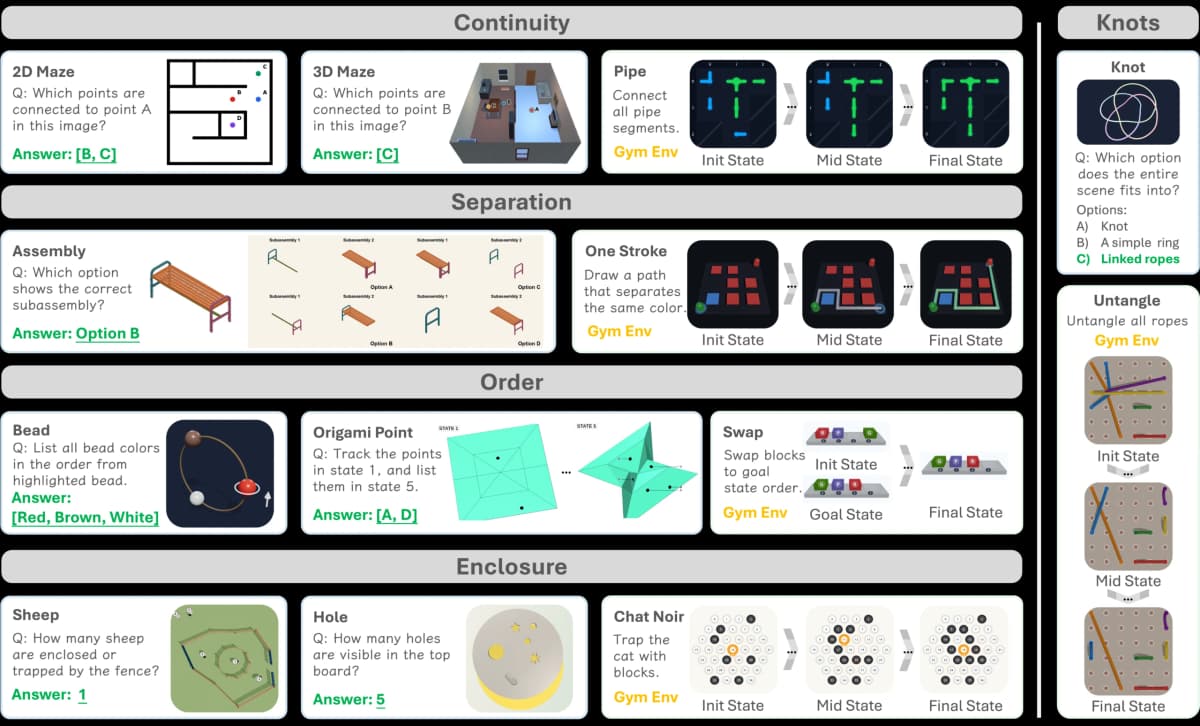
Бенчмарк впервые отделил умение распознавать пространственные отношения на картинке от умения сохранять эти отношения в цепочке действий, и оказалось, что модели проваливаются именно на втором, а это основа для любого физического взаимодействия робота с миром.
Исследователи Microsoft Research представили MindTopo, диагностический набор тестов для визуальных языковых моделей (мультимодальных моделей, которые понимают и текст, и изображения). До сих пор такие модели проверяли в основном на евклидовых задачах: расстояние, направление, размер. MindTopo проверяет другое: топологию, то есть структурные связи между объектами, которые сохраняются, даже если объекты гнутся, растягиваются или деформируются.
| Показатель | Значение | Источник |
|---|---|---|
| Название бенчмарка | MindTopo | Microsoft Research |
| Число категорий задач | 5 (непрерывность, разделение, порядок, замкнутость, узлы) | Microsoft Research |
| Число когнитивных уровней | 2 (статическое рассуждение и интерактивное планирование) | Microsoft Research |
| Главный вывод | Модели справляются со статическим распознаванием значительно лучше, чем с интерактивными задачами | Microsoft Research |
| Результаты относительно человека | Оба уровня задач значительно ниже человеческих результатов | Microsoft Research |
Что проверяли и зачем?
MindTopo устроен просто: есть пять типов пространственных отношений, и каждый проверяется на двух уровнях сложности.
Пять типов задач:
- Непрерывность. Остаётся ли путь или объект целым, не разорванным.
- Разделение. Являются ли соседние элементы одной структурой или разными частями.
- Порядок. Как элементы расположены вдоль пути и сохраняется ли последовательность после преобразований.
- Замкнутость. Создаёт ли граница «внутри» и «снаружи». Например: овцы внутри забора или снаружи?
- Узлы. Действительно ли верёвка завязана или только выглядит запутанной.
Первый уровень, статическое рассуждение: модель смотрит на одну или несколько картинок и отвечает на вопрос. Соединены ли две точки в лабиринте? Завязан ли узел?
Второй уровень, интерактивное планирование: модель должна выбирать действия в симуляции, поворачивать трубы, рисовать разделяющую линию, переставлять блоки, распутывать верёвки. Среда запрещает физически невозможные действия: нельзя протащить верёвку сквозь другую верёвку.
Все сцены генерируются в управляемых симуляторах с точными правильными ответами. Это позволяет отличить ситуацию, когда модель ошибается из-за сложной картинки, от ситуации, когда она теряет понимание структуры при изменении сцены.
Где именно ломаются модели?
Результаты протестированных моделей с закрытыми и открытыми весами (открытые веса означают, что архитектура и параметры модели доступны для изучения) показали устойчивую картину:
- Статику модели понимают лучше, чем динамику. Распознать связный путь, замкнутую область или узел на одной картинке модели способны. Но удержать это понимание через цепочку действий они не могут.
- Ошибки возникают при планировании, а не при восприятии. Модель правильно «видит» сцену, но дальше выбирает ход, который выглядит логичным локально, не отслеживая последствия через несколько шагов. Она теряет задачу на длинной дистанции или предлагает действие, нарушающее физические ограничения среды.
- Оба уровня задач значительно ниже человеческих результатов. Даже в статических задачах модели не дотягивают до человека, а в планировании разрыв ещё заметнее.
- Генерация изображений и видео не спасает. Исследователи проверили, помогает ли моделям генерировать картинку или видеоролик для «мысленного моделирования». Генерация изображений иногда помогала в задачах с одним кадром, но была ненадёжна для последовательностей. Видеосимуляции часто нарушали топологию или физику задачи.
Бенчмарк покрывает пять категорий топологических задач на двух когнитивных уровнях, но авторы не публикуют точных процентов успешности для каждой модели в открытом доступе, ограничиваясь качественными выводами. Тесты проводились на контролируемых симуляциях, а не на реальных физических сценах, поэтому результаты показывают потолок, а не пол проблемы: в реальном мире с шумом, освещением и окклюзией (перекрытием одних объектов другими) ошибок будет больше. Набор моделей включал и закрытые, и с открытыми весами, но конкретный список и сравнительные таблицы авторы раскрывают в полном тексте исследования.
Что это значит для тех, кто работает с ИИ?
Разработчикам робототехники и промышленной автоматизации MindTopo даёт конкретный инструмент: прежде чем ставить визуальную языковую модель на задачу манипуляции объектами, прогоните её через топологические тесты. Если модель не может удержать понимание «что с чем соединено» через пять действий в симуляции, она не справится с реальной сборкой, упаковкой или сортировкой, где нарушение связности означает брак или поломку.
Авторам и маркетологам на Дзене результат важен для понимания границ мультимодальных моделей. Когда вы просите визуальную языковую модель проанализировать схему, инфографику или план помещения, она может правильно назвать отдельные элементы, но ошибиться в их взаимных связях. Проверяйте пространственные выводы модели вручную, особенно если от них зависит содержание публикации.
Предпринимателям в РФ и СНГ, работающим с компьютерным зрением и автоматизацией, стоит учесть: ни одна из текущих моделей не решает топологические задачи на уровне человека. Из доступных в России мультимодальных моделей можно протестировать YandexGPT (с визуальным входом) и GigaChat, но ожидать от них устойчивого пространственного рассуждения при планировании пока не стоит.
Я вижу в MindTopo редкий случай, когда бенчмарк не просто ранжирует модели, а вскрывает конкретный тип мышления, которого у них нет. Модели научились отвечать на вопросы про картинки, но действовать в пространстве, удерживая структуру, они пока не умеют. Для всех, кто планирует использовать ИИ-агентов (программы, которые действуют автономно) в физическом мире, это холодный душ: между «модель видит» и «модель может» лежит пропасть, и MindTopo впервые её измерил. Авторы прямо говорят, что для закрытия разрыва, возможно, нужны модели с явным топологическим состоянием или «модели мира», чьи предсказания сохраняют топологию по построению. Пока таких нет, любая автоматизация с физическим контактом требует человека на проверке.
Именно разрыв между восприятием и действием делает MindTopo полезным не как академическое упражнение, а как практический фильтр: прежде чем доверять визуальной языковой модели задачу, где объекты движутся и связи между ними должны сохраняться, проверьте, проходит ли она этот тест.
По данным Microsoft Research

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Дядя Боб уместил правила для ИИ-агента в 750 слов: «готово» без теста не принимается
Роберт Мартин, автор книги «Чистый код», на днях выложил в открытый доступ ub-mode, свод правил для нейросетей, которые сами пишут код, и теперь агент обязан…
Nvidia открыла бесплатную модель распознавания речи на 40 языков: хватит одного чипа
Nvidia выпустила бесплатную открытую модель Nemotron 3.5 Transcribe для распознавания речи до 40 языков в разгар волны голосовых релизов, когда Mistral,…
Фотограф автоматизировал оцифровку плёнки 35 мм с Claude: 4 часа обработки ушли в код
Фотограф Shan выложил разбор с перепиской о том, как нейросеть Claude взяла на себя четырёхчасовую обработку плёнки 35 мм, включая аварию со сканером, и это…
Комментарии