
Удаление оригинальной речи из старого закадрового перевода: сервис DubClean делает это нейросетью
Почему это важно Впервые появился специализированный сервис, который убирает английскую речь из-под русского закадрового перевода старых фильмов, сохраняя…
Впервые появился специализированный сервис, который убирает английскую речь из-под русского закадрового перевода старых фильмов, сохраняя голос переводчика, музыку и звуковые эффекты, и это решает проблему, знакомую каждому, кто пересматривает классику с «двухголосым» звуком.
Автор-разработчик выпустил DubClean, сервис для удаления оригинальной речи из старого закадрового перевода, после серии экспериментов с нейросетями и алгоритмическим вычитанием звука. Идея родилась из личного раздражения: два голоса одновременно мешают погрузиться в фильм. Большинству зрителей это не мешает, но для части аудитории проблема реальна и до сих пор не имела готового решения.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| DubClean, сервис очистки закадрового перевода от английской подложки | дату публичного запуска автор не назвал | независимый разработчик (имя не раскрыто) | не указана |
Что умеет DubClean и как он устроен?
-
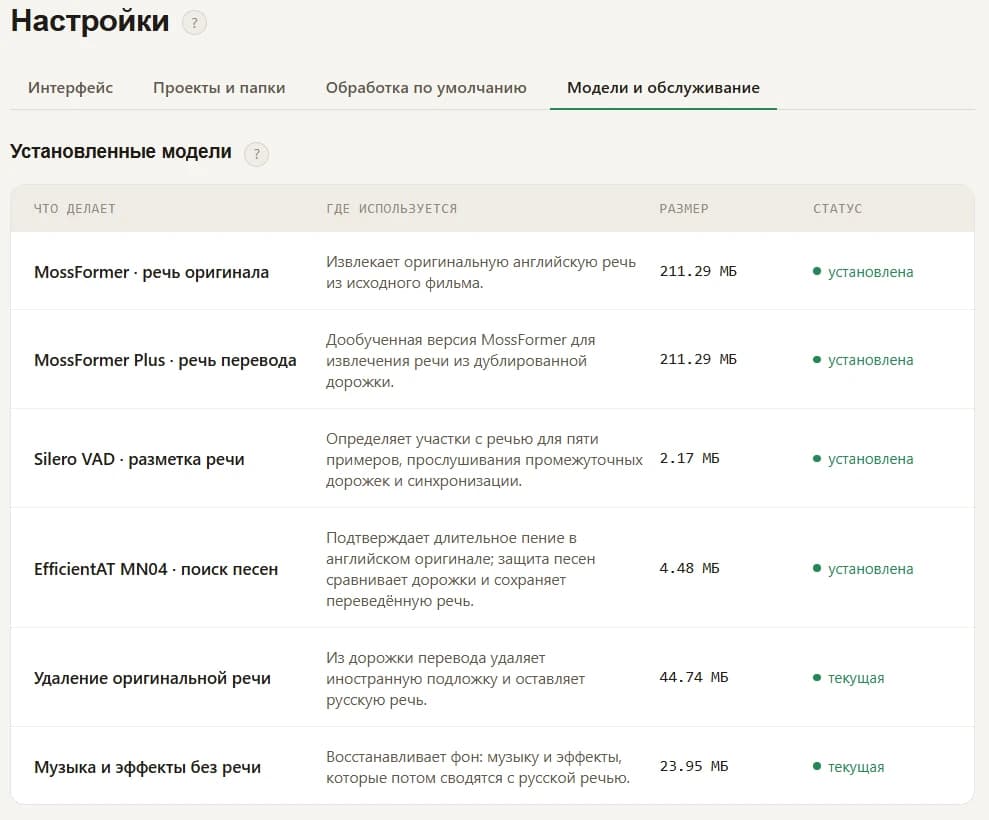
Сопоставляет две дорожки. Сервис берёт дорожку с русским закадровым переводом и оригинальную английскую дорожку того же фильма. Английский голос, который мешает в переводе, уже существует отдельно в оригинале, и система использует его как образец того, что нужно удалить.
-
Выделяет речь отдельно от фона. Внутри используется MossFormer2 SE 48K из пакета ClearerVoice-Studio для извлечения голосов из общего звука фильма. Музыка, шаги, выстрелы отделяются от речи, чтобы не повредить их при обработке.
-
Убирает английскую подложку нейросетью. Две небольшие собственные нейросети обучены именно под задачу: на вход поступает смесь голосов и английский референс (образец, от которого надо избавиться), на выходе остаётся русский перевод.
-
Собирает результат обратно. Очищенный русский голос соединяется с музыкой и эффектами. Голос переводчика остаётся прежним, без перезаписи реплик и без синтеза нового голоса.
Почему простое вычитание звука не сработало?
Автор честно описал путь к результату, и это ценнее маркетингового «всё работает идеально».
Первая попытка, модель, которая выделяла голос переводчика из одной смешанной дорожки, опираясь на громкость и запаздывание. Гипотеза была простой: переводчик обычно звучит громче и вступает чуть позже. На одном фильме получилось терпимо, но на других соотношение голосов оказалось слишком непостоянным. Оригинал бывает тише перевода, громче или почти на одном уровне. Модель путала языки прямо внутри одной фразы.
Вторая попытка, алгоритмическое вычитание с двумя дорожками. Дорожки выравнивались по времени, общая составляющая подавлялась. Результат: глухой звук, «сжёванные» слова, английская речь местами оставалась. Причина в том, что в дорожке перевода оригинал уже приглушён, сжат, пропущен через другой кодек. Образец похож, но не совпадает с сигналом внутри перевода.
Только после этого автор пришёл к обучению собственных нейросетей, которые получают на вход и смесь голосов, и английский референс, а учатся оставлять русский перевод.
Какие условия учитывает модель?
Автор собрал подробный список вариаций, на которых обучались нейросети. Это важно для понимания границ инструмента:
- Мужские, женские, детские голоса с разным тембром
- Спокойная речь, шёпот, крик, оборванные реплики
- Быстрый диалог, длинный монолог, несколько говорящих подряд
- Перевод начинается после оригинала, раньше него, перекрывает только часть фразы
- Английский тише русского, на одном уровне или громче
Каждый из этих случаев, отдельная ловушка для алгоритма. То, что автор перечислил их открыто, говорит о серьёзном подходе к обучающим данным (обучающие данные, примеры, на которых нейросеть учится различать нужный и ненужный сигнал).
Как попробовать?
- Найдите фильм, для которого у вас есть и дорожка с русским закадровым переводом, и оригинальная английская дорожка.
- Загрузите обе дорожки в DubClean. Сервис сам выровняет их по времени, выделит речь, уберёт английскую подложку и соберёт результат с музыкой и эффектами.
- Проверьте результат на слух: автор честно предупреждает, что ограничения у системы остались, небольшие остатки оригинала или отдельные артефакты возможны.
Есть ли аналоги в России?
Прямого аналога DubClean на российском рынке нет. Существуют сервисы синтеза речи и озвучки (YandexSpeechKit, звуковые инструменты в GigaChat), но они решают другую задачу: генерируют новый голос, а не очищают существующую запись. Удаление оригинальной речи из старого закадрового перевода, задача узкая и специфическая именно для постсоветского рынка, где закадровый перевод с «двухголосым» звуком существует как отдельный культурный пласт.
Из универсальных инструментов разделения звука можно попробовать опенсорс-модель Demucs от Meta или уже упомянутый MossFormer2, но они отделяют голос от музыки, а не один язык от другого. Для полноценного удаления английской подложки потребуется именно специализированное решение.
Что с этого вам по ролям?
Автору Дзена, который пишет обзоры фильмов или ведёт канал о кино. Если вы используете фрагменты старых переводов в контенте, DubClean может дать чистый звук без «каши» из двух языков. Это меняет качество аудиовставок.
Маркетологу и продюсеру контента. Закадровый перевод с двойным голосом, это боль, которую многие считают неизбежной. Инструмент показывает, что нейросети уже решают задачи, которые раньше требовали ручной работы звукорежиссёра.
Любителю кино 50+. Если вас раздражает английский голос под русским переводом в любимых фильмах 90-х и 2000-х, теперь есть способ получить чистую русскую дорожку. Нужны обе звуковые дорожки и немного терпения.
DubClean решает настоящую, а не выдуманную проблему. Да, она нишевая. Да, большинству зрителей два голоса не мешают. Но для тех, кому мешают, до сих пор не было ничего, кроме ручной чистки в аудиоредакторе, а это часы работы на каждый фильм.
Меня подкупает честность автора: он описал неудачные попытки, перечислил ограничения и не обещал «студийный дубляж». По моим наблюдениям, именно такие узкие инструменты, заточенные под одну конкретную задачу, дают лучший результат, чем универсальные «ИИ для всего».
Оговорка: сервис сделан одним разработчиком, цена и условия доступа пока не названы, об ограничениях автор предупреждает сам. Попробуйте на одном фильме, прежде чем обрабатывать всю коллекцию.
Что сделать сегодня: найдите фильм с раздражающим двойным голосом, убедитесь, что у вас есть и русская, и английская дорожка, и протестируйте DubClean на коротком фрагменте.
Частые вопросы
Нужен ли оригинал фильма для обработки?
Да. DubClean работает с двумя дорожками: русским закадровым переводом и оригинальной английской звуковой дорожкой того же фильма. Без английского образца система не сможет понять, какой именно голос убирать.
Заменяет ли сервис голос переводчика на синтетический?
Нет. Сервис сохраняет оригинальный голос переводчика без изменений. Не перезаписывает реплики и не генерирует новую речь. Задача, убрать английскую подложку, а не создать новую озвучку.
Будут ли слышны артефакты после обработки?
Автор честно предупреждает: небольшие остатки английского голоса или отдельные артефакты возможны. Система не обещает студийного качества дубляжа. Но результат, по описанию автора, принципиально лучше исходной «каши» из двух языков.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Canva ИИ впервые свой: модель Craft вошла в топ-5 и доступна бесплатно
Почему это важно Canva впервые выпустила собственную модель генерации изображений, которая планирует композицию до отрисовки, и сразу открыла доступ всем…
Искусственный интеллект в управлении проектами: +25% скорости на простом, −19% точности на сложном
Искусственный интеллект в управлении проектами пока не волшебная палочка: исследования 2025 года показывают, что на простых задачах он ускоряет работу на 25%,…
В каких сферах нейросетевой текст уместен, а в каких сразу отпугнёт читателя
Второго июня разработчик и автор блога о технологиях опубликовал разбор, который разложил по полочкам простой, но неочевидный принцип: нейросетевой текст…
Комментарии