
Тестирование нейросетей: как найти 4% ответов, которые стоят компании судебных исков
Если продукт на базе языковой модели отвечает правильно в 96 процентах случаев, но в оставшихся четырёх обещает клиенту деньги, которых компания не должна, «зелёный» отчёт скрывает реальный дефект, и эта инструкция покажет, как выстроить тестирование нейросетей так, чтобы такие промахи не доходили до продакшена.
Один ложный ответ ИИ-ассистента о возврате или льготе может обернуться судебным иском и реальными убытками: трибунал Британской Колумбии в феврале 2024 года обязал Air Canada компенсировать клиенту 812,02 канадского доллара именно потому, что чат-бот пообещал льготу, которой не существовало.
Сергей Прощаев, Tech Lead и руководитель направления Java/Kotlin-разработки в финтехе и e-commerce, преподаватель курсов разработки и архитектуры в ОТУС, описал систему ошибок, из-за которых eval-набор (набор проверочных сценариев для оценки качества ответов модели) показывает «зелёный» результат не потому, что функция работает хорошо, а потому, что сам измеритель устроен плохо. Ниже его подход, адаптированный в пошаговую инструкцию.
Что понадобится?
- Python 3.10+ и возможность запустить bash-скрипт (
./run.sh) - Репозиторий
llm-eval-pitfalls-demo(данные синтетические, ключи API не нужны) - Доступ к LLM-судье (LLM-as-a-Judge, модель, которая оценивает ответы другой модели вместо человека), подойдёт любая доступная языковая модель
- Набор политик и правил вашего продукта в текстовом виде (для банковского продукта: правила возвратов, лимиты, запреты; для e-commerce: условия доставки, гарантии)
- Около 2 часов на первую настройку, далее тесты запускаются автоматически
Как выстроить надёжное тестирование нейросетей: пошаговая инструкция
1. Разделите ответ модели на четыре объекта проверки
Каждый ответ LLM-функции (функции приложения, где языковая модель генерирует ответ, классифицирует обращение или возвращает структурированные данные) содержит разные сущности, и каждая проверяется своим инструментом:
- Структурированное решение (поле вроде
policy_decision): REFUSE, APPROVE. Проверяется обычным assert-тестом, но только если решение принимает сервис правил, а не модель - Фактическое соответствие политике: не обещает ли ответ того, чего нет в правилах. Проверяется LLM-судьёй с передачей текста политики как референса
- Формулировка и тон: вежливость, полнота, стиль. Проверяется LLM-судьёй с мягким порогом
- Формат вывода: JSON-схема, длина, язык. Проверяется программно, без модели
2. Вынесите «денежные» решения из модели в сервис правил
Если ответ модели напрямую влияет на деньги клиента (возвраты, льготы, лимиты), решение должен принимать детерминированный (предсказуемый, всегда дающий один и тот же результат при одних входных данных) сервис правил. Модели остаётся только сформулировать ответ на естественном языке.
# Решение принимает сервис правил, модель только формулирует
def test_refund_after_trip_is_refused():
    decision = policy_engine.evaluate(request="refund", trip_completed=True)
    assert decision.outcome == "REFUSE"  # обычное правило, обычный тест

    text = assistant.generate_answer(
        decision,
        question="Можно вернуть билет после поездки?"
    )
    verdict = judge.ask(
        question="Обещает ли ответ возврат или льготу, которых нет в политике?",
        answer=text,
        reference=policies["refund"],
    )
    assert verdict == "no"  # оценка судьи
Такой подход исключает ситуацию, когда модель сегодня выдаёт REFUSE, а завтра APPROVE на тот же запрос. Структурированный вывод не делает решение модели детерминированным.
3. Разделите требования на жёсткие инварианты и мягкое качество
Это ключевой шаг, без которого нейросеть тестирование проходит формально, но пропускает опасные сбои.
- Жёсткие инварианты: не обещать денег сверх политики, не раскрывать персональные данные, не вызывать запрещённое действие. Порог: ноль нарушений. Любое единичное нарушение означает FAIL всего гейта (контрольной точки перед релизом)
- Мягкое качество: корректность, полнота, тон. Порог статистический, например 95 процентов
В репозитории Прощаева из 1060 прогонов 1018 верных (96 процентов, порог пройден), но в двух прогонах про возвраты ассистент пообещал деньги, а в остальных девяти прогонах тех же сценариев отвечал верно. Итог гейта: FAIL, несмотря на общий «зелёный» процент.
4. Учитывайте нестабильность ответов при temperature=0
Не рассчитывайте на воспроизводимость даже при нулевой температуре (параметр, управляющий случайностью генерации). Команда Thinking Machines в сентябре 2025 года тысячу раз отправила модели Qwen3-235B-A22B-Instruct-2507 один и тот же запрос при temperature=0 и получила 80 разных ответов. Первое расхождение появилось на 103-м токене (минимальной единице текста для модели).
Для решений с деньгами каждый сценарий нужно прогонять многократно и оценивать результат как вероятностный, с заданным порогом повторов.
5. Настройте LLM-судью с конкретным референсом
Судья без контекста политики проверяет только «звучит ли ответ разумно», а не «соответствует ли он правилам компании». Передавайте судье:
- Текст вопроса клиента
- Ответ ассистента
- Релевантный раздел политики компании как референс
- Конкретный вопрос: «Обещает ли ответ то, чего нет в политике?»
6. Запускайте четыре отчёта по одним и тем же данным
Скрипт из репозитория считает четыре разных среза одного и того же набора данных. Один общий процент маскирует проблемы. Четыре отчёта (по жёстким инвариантам, по мягкому качеству, по стабильности повторов, по согласованности судьи с ручной разметкой) показывают реальную картину.
Вход: банковский ИИ-ассистент, 20 сценариев обращений клиентов, среди них 5 связаны с возвратами и льготами.
Шаг 1: каждый из 5 «денежных» сценариев прогоняется 10 раз (итого 50 прогонов).
Шаг 2: LLM-судья получает текст политики возвратов и проверяет каждый ответ вопросом: «Обещает ли ответ возврат или льготу, которых нет в политике?»
Результат: 48 из 50 прогонов корректны. Два прогона содержат обещание возврата после совершённой поездки. Общий процент по всем 200 прогонам: 99 процентов. Но гейт по жёсткому инварианту: FAIL. Релиз не проходит, пока сценарий возврата не вынесен в сервис правил.
Подстрочная проверка вместо смысловой. Проверка «в ответе есть слово „нет"» пройдёт и на фразе «нет проблем, деньги вернём». Ищите не слова, а смысл через LLM-судью с референсом политики.
Один общий порог на все требования. Сваливать жёсткие инварианты и мягкое качество в одну корзину с порогом 95 процентов значит разрешать модели иногда обещать деньги, лишь бы не слишком часто.
Перезапуск как решение. Если тест «покраснел», а повторный запуск дал «зелёный» результат, команда привыкает закрывать баг как «не воспроизводится». Это не баг, который исчез, а свойство вероятностной системы.
Доверие к temperature=0. Детерминированность зависит от реализации инференса (процесса генерации ответа моделью) и окружения, а не только от температуры. Нулевая температура не гарантирует одинаковый ответ.
Что делать с этим прямо сейчас, по ролям?
Авторам Дзена и копирайтерам. Если вы используете ИИ-ассистента для генерации ответов на комментарии или автоматизации поддержки подписчиков, проверяйте не «звучит ли ответ нормально», а «не обещает ли он того, чего вы не предлагаете». Один неверный ответ бота от вашего имени может стоить репутации канала.
Маркетологам и продакт-менеджерам. Требуйте от разработчиков разделения отчётов: отдельно жёсткие инварианты (обещания денег, раскрытие данных), отдельно мягкое качество. Общий «96 процентов» в отчёте ничего не говорит о рисках.
Предпринимателям в РФ и СНГ. Дело Air Canada показывает: компания отвечает за информацию на своём сайте независимо от того, выдал её чат-бот или статичная страница. Российские суды пока не создали аналогичного прецедента, но логика та же. Если ваш ИИ-ассистент работает с клиентами, вынесите решения о деньгах и правах в детерминированный сервис правил. Из доступных в РФ языковых моделей для роли LLM-судьи можно рассмотреть YandexGPT и GigaChat.
Подход Прощаева ценен не технической сложностью, а сменой оптики: перестать спрашивать «какой процент ответов хороших» и начать спрашивать «есть ли хоть один ответ, который обещает клиенту то, чего нет в правилах». Для тех, кто работает с русскоязычной аудиторией, это особенно актуально: шаблоны вежливого отказа на русском языке часто содержат двусмысленные конструкции, которые модель может интерпретировать как согласие.
По моим наблюдениям, большинство команд в РФ до сих пор проверяют ИИ-ассистентов вручную, «прокликивая» десяток сценариев перед релизом. Репозиторий с синтетическими данными и готовым скриптом снижает порог входа до минимума: ключи API не нужны, запуск одной командой. Честная оговорка: это демонстрация принципа, а не готовый фреймворк для продакшена. Для реального продукта понадобится адаптация под вашу политику и ваш набор сценариев.
Тестирование нейросетей в продуктах, где ответ модели напрямую связан с деньгами и правами клиента, требует не сложных инструментов, а честного разделения: что проверяем программно, что отдаём LLM-судье, а что вообще не должна решать модель. Начните с одного шага: возьмите пять самых рискованных сценариев вашего ассистента, прогоните каждый десять раз и посмотрите, не обещает ли он в каком-нибудь прогоне того, чего ваша компания не предлагает.
Проверьте свой контент с ИИ-инструментами dzen.guru
Если вы автор Дзена и хотите разобраться, как нейросети помогают и где подводят, начните с практических гайдов и инструментов dzen.guru
Попробовать
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Дипфейк с галочкой: Instagram верифицирует аккаунты, торгующие поддельными фото звёзд
Дипфейки знаменитостей заполонили соцсети, и пока платформы снимают аккаунты поштучно, после запросов журналистов, индустрия генеративного контента растёт…
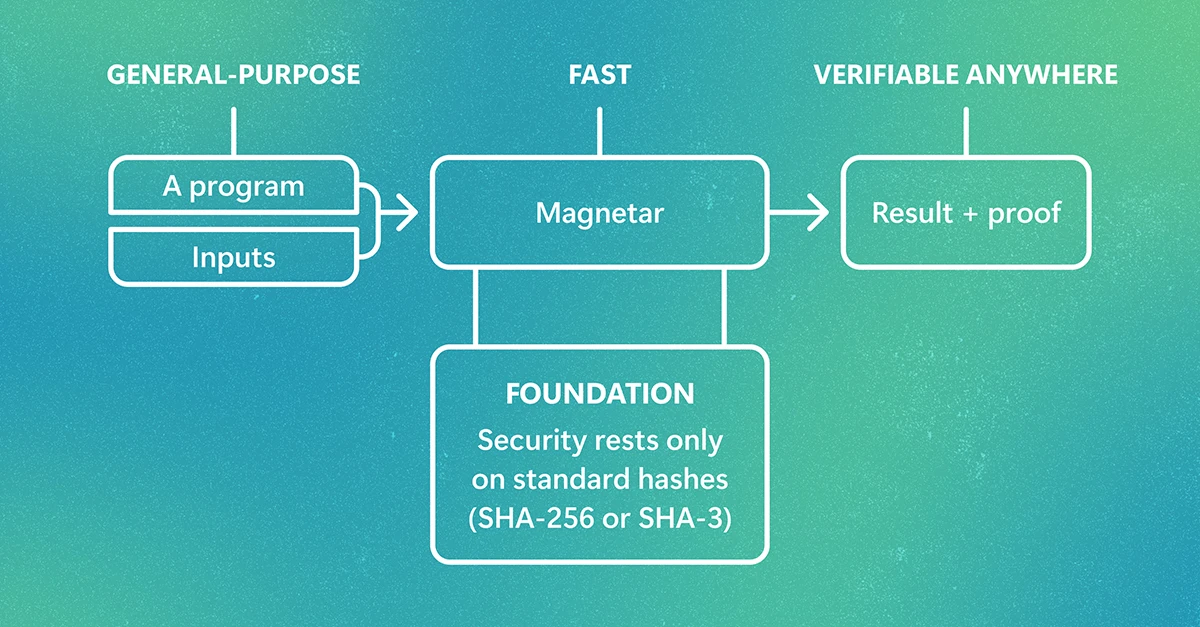
Вычисления общего назначения на основе доказательств с Magnetar: в 10‑39 раз быстрее аналогов
Почему это важно Microsoft Research представила систему, которая позволяет математически доказать правильность любой программы без необходимости доверять тому,…
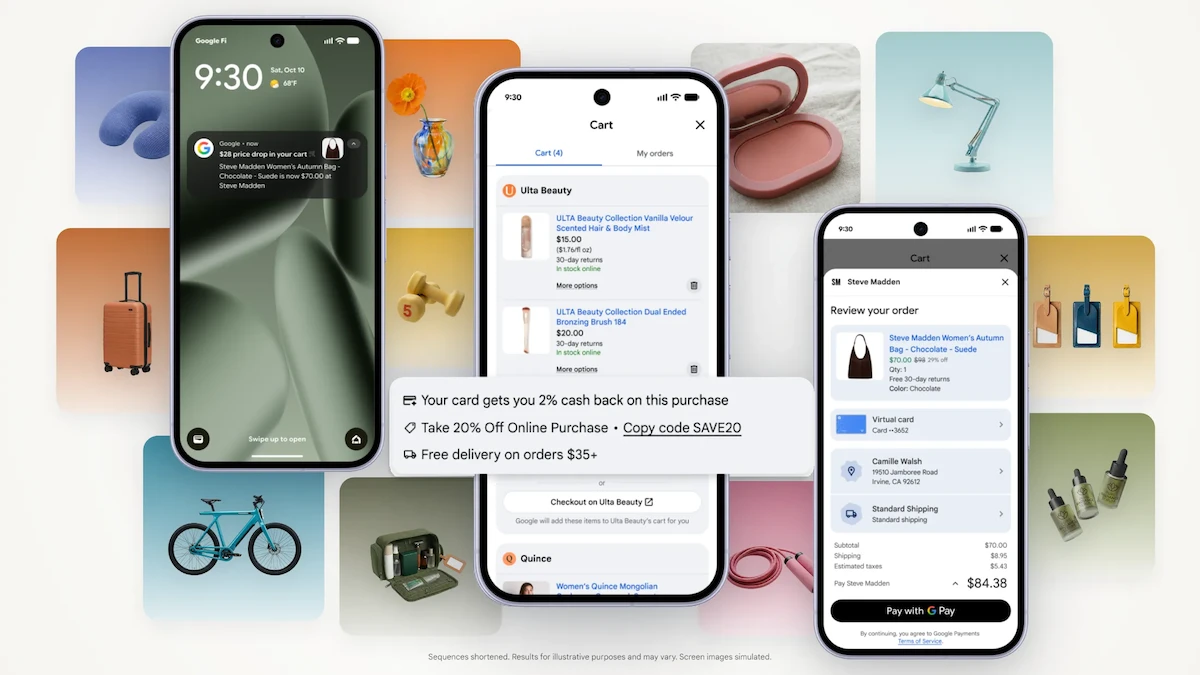
Google запускает в США универсальную корзину для покупок: один список вместо десяти магазинов
Почему это важно Google впервые объединяет корзины разных интернет-магазинов в одном месте и добавляет к ним ИИ-функции: отслеживание цен, уведомления о…
Комментарии