
Тест визуального мышления от Elorian: передовые модели ловятся на приманку, точность ниже 50%
Стартап Elorian в этом месяце выпустил свою первую модель визуального мышления Glimpse и вместе с Mercor представил тест DecoyCount, на котором передовые нейросети пока не дают и половины верных ответов.
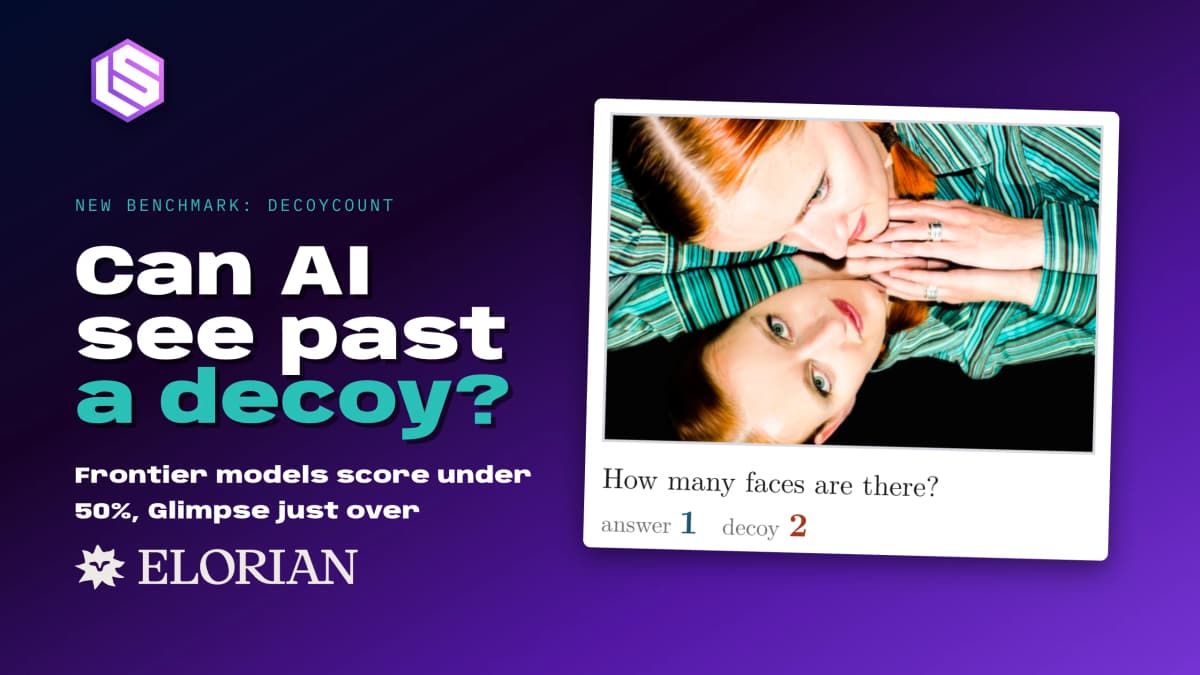
DecoyCount отдельно проверяет зрение модели и её рассуждение. Он показал, что сильные чат-боты часто не могут честно посчитать предметы на картинке. Для автора это прямое предупреждение: подписи к фото, описания товаров и подсчёты по скриншотам от ИИ нужно перепроверять своими глазами.
| Кто | Сумма | Тип сделки | Дата |
|---|---|---|---|
| Elorian (соинвесторы Striker Venture Partners, Menlo Ventures, Altimeter Capital) | 55 млн долларов | Посевной раунд | Апрель |
Посевной раунд означает первые крупные деньги стартапа на старте, до серийных раундов. С этими средствами Elorian в апреле вышел из скрытого режима. Теперь компания показывает продукт и собственную линейку для его оценки.
Что произошло?
Elorian продвигает Glimpse как «новую категорию модели визуального мышления: систему, которая рассуждает о физическом мире по тому, что видит». Вместе с моделью компания выпустила тест (бенчмарк, то есть набор заданий для сравнения нейросетей) DecoyCount. Партнёр по нему, Mercor, работает с данными для ИИ.
Название переводится примерно как «подсчёт приманок». Тест проверяет, действительно ли модель считает объекты или подменяет счёт визуальными уловками. Пример приманки: отражение в зеркале или привычная упаковка, по которой хочется угадать число.
В статье, сопровождающей релиз, передовые модели (самые сильные универсальные нейросети крупных компаний) набрали меньше 50% точности. Результаты по данным, которые привёл Эндрю Дай, генеральный директор Elorian:
- GPT-6 Astra: 43,17%;
- Gemini-3.8-flash: 32,71%;
- Qwen3.8-max: 28,31%;
- Claude-Fable-5.1: 25,22%.
Самой Glimpse в статье нет. По словам Дая, во внутреннем тесте модель набрала 50,48% на 1660 заданиях. Это единственный результат выше 50% в этом сравнении.
Есть существенная оговорка. Glimpse прошла тест один раз и без агентной обвязки и вспомогательных инструментов. Модели из статьи усредняли по трём прогонам в их заявленных настройках.
Дай также заверил, что изображения и тексты теста не попадали в обучающие данные Glimpse и проверка на пересечение совпадений не нашла. Вывод самой статьи звучит так: «более сильное общее рассуждение само по себе не переходит в согласованное визуальное рассуждение».
Почему это важно для рынка?
Большинство тестов смотрят только на итоговую цифру. Дай объясняет, почему этого мало.
Если человек видит яблоко перед зеркалом, он понимает, что яблоко одно и оно отражается. Модель же может вообще не заметить яблоко, это ошибка зрения, или посчитать яблоко и отражение как два, это ошибка рассуждения. Большинство тестов проверяют только итоговое число, поэтому обе ошибки выглядят одинаково. : Эндрю Дай, генеральный директор Elorian
Отсюда главный вопрос: могут ли передовые модели распознать приманку? Тест визуального мышления от Elorian пока отвечает «редко». Здесь есть деталь, которую стоит держать в голове: компания одновременно выпустила тест и модель, которая на нём лидирует, причём результат модели внутренний и в статье не опубликован.
Подход Elorian строится на «визуальном мышлении» из психологии. Человек, выбирая диван, мысленно ставит его в гостиную. Пересчитывая людей за столом, он мысленно вычёркивает их по одному. Компания учит модель делать так же: создавать и править изображения прямо по ходу рассуждения, вместе с текстом.
Дай отделяет свой продукт от моделей мира (систем, которые строят трёхмерную симуляцию среды, где можно перемещаться и действовать). Среди них он упоминает Atlas от World Labs, которую затем купила AMD, и Genie 4 от Google. Glimpse, по его словам, нужна для «непрямого действия»: помочь принять решение, например отклонить пользовательское видео за нарушение правил. «Для этого не нужна 3D-визуализация», говорит Дай.
Среди направлений компания называет робототехнику, инженерные задачи, оборону и проверку архитектурных проектов на соответствие строительным нормам. В двух тестах для роботов, WGO Bench и ERQA, Elorian заявляет результат на уровне передовых моделей или выше при заметно меньшей цене. Конкретных цен источник не приводит.
Дай за плечами имеет долгую карьеру. В 2015 году в Google он вместе с Куоком Ле показал раннюю версию подхода «предобучение, затем дообучение» (обучение модели на примерах под узкую задачу). Потом он работал в Google DeepMind над PaLM 2 и Gemini и ушёл в этом году, чтобы основать Elorian.
Результат Glimpse получен в одном прогоне, внутри компании, и в статье его нет. О цене, доступе и работе в России источник ничего не сообщает. Сравнивать с цифрами конкурентов стоит осторожно, пока нет независимой проверки.
Что это значит для вас?
Автору Дзена. Не доверяйте ИИ подсчёт на картинках: сколько людей на фото, сколько товаров на полке, сколько пунктов на скриншоте. Если цифра попадает в текст, пересчитайте сами. Ошибка в одной детали подрывает доверие ко всему материалу.
Маркетологу. Автоматическая проверка креативов, карточек товаров и пользовательских видео нейросетью пока ненадёжна там, где важны количество и отражения. Оставьте человека на финальной проверке, особенно в модерации.
Предпринимателю в РФ и СНГ. Glimpse пока не стоит закладывать в планы: о доступе источник не сообщает. Проверьте свою задачу на доступных ассистентах, например GigaChat или YandexGPT: дайте десяток своих фото с известным числом предметов и посмотрите, где модель ошибается.
На мой взгляд, ценность DecoyCount не в рейтинге, а в разделении ошибок на «не увидел» и «неправильно понял». Это полезная рамка и для нас, пользователей: прежде чем ругать нейросеть, стоит понять, что именно она упустила. К победе Glimpse я отношусь сдержанно, пока её не повторит кто-то, кроме самой Elorian.
Практический шаг на эту неделю простой: соберите 10 своих рабочих изображений с заранее известным ответом и прогоните их через нейросеть, которой пользуетесь. Через полчаса вы будете точно знать, где ей можно верить, а где нет.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Gemini 4 Carbon нашла уязвимости в 88,2% задач и вывела Google на первое место рейтинга
Google DeepMind представила Gemini 4 Carbon, модель для поиска и закрытия уязвимостей, которая сразу возглавила независимый рейтинг Artificial Analysis,…
11 часов бесплатного видео: как собрать reasoning модель с нуля на PyTorch
Компания Sebastian Raschka (автор книги «Build a Large Language Model (From Scratch)») 3 июня 2025 года выложила в открытый доступ восемь видеолекций общей…
Kimi AI выпустила открытую модель на 2,8 трлн параметров и обошла закрытых конкурентов
Kimi AI выпустила модель с 2,8 триллиона параметров, которая 22 октября 2026 года обошла закрытые аналоги в независимых тестах и станет доступна с открытыми…
Комментарии