
Теория возможностей в машинном обучении: третья зона между «да» и «нет» снижает галлюцинации ИИ
Современные генеративные модели опираются на теорию вероятностей, но профессор Жереми Уссино из Наньянского технологического университета в Сингапуре представил доклад о теории возможностей, которая честнее работает там, где данных мало.
Теория возможностей вводит третью зону между «да» и «нет», зону незнания, и это напрямую касается любого, кто использует машинное обучение: от авторов, доверяющих ИИ-ответам, до инженеров, строящих системы оценки рисков.
| Параметр | Значение |
|---|---|
| Кто | Наньянский технологический университет (Сингапур), Уорикский университет (Великобритания) |
| Что | Доклад профессора Жереми Уссино (Jeremie Houssineau) о теории возможностей в машинном обучении |
| Тип | Академическое исследование с новым алгоритмом uCBOpt |
| Ключевые результаты | Аналог теоремы Донскера-Варадхана для теории возможностей (2025), адаптированный градиентный спуск |
Исследование появилось на фоне нерешённой проблемы галлюцинаций (когда ИИ уверенно выдумывает то, чего не было) в генеративных моделях. Источник проблемы отчасти в самом фундаменте: классическая теория вероятностей заставляет модель всегда делать ставку, даже когда информации для ставки нет. Об этом пишут авторы доклада, анализ которого лёг в основу этой новости.
Две неопределённости вместо одной
Ключевая идея доклада строится на разграничении двух типов незнания.
- Алеаторная неопределённость (случайная). Поломка ракеты при запуске: даже зная всё о ракете, нельзя гарантировать исход на 100%. Здесь два варианта, сработало или нет, и порог вероятности работает корректно.
- Эпистемическая неопределённость (от нехватки знаний). Космический мусор на орбите: мы не знаем, где каждый обломок, его скорость и массу. Появляется третья зона, жёлтая на графиках доклада, зона «не знаем».
Профессор Уссино показал график зависимости вероятности столкновения от точности данных о позиции обломков. Пунктирная линия, алеаторная модель, игнорирует нехватку информации: вероятность низкая и убывает. Сплошная линия, эпистемическая модель: чем меньше знаем, тем выше риск, и по мере уточнения данных вероятность падает.
Отсюда принцип: «Если нет информации, возможно всё». Именно этот принцип и формализует теория возможностей.
Чем теория возможностей отличается от вероятностной?
В классической теории вероятностей плотность распределения обязана давать в сумме единицу. Это жёсткое ограничение: модель вынуждена распределить уверенность по всем вариантам, даже когда данных нет.
Теория возможностей снимает это ограничение. Функция возможностей не обязана «суммироваться в единицу», поэтому модель может честно сказать: «для этого диапазона у меня нет информации».
Ещё одно свойство, которое отмечает Уссино: независимость от параметризации. В теории вероятностей при замене переменных появляется якобиан (множитель, корректирующий плотность при переходе в другую систему координат). В теории возможностей этого нет, и объяснение простое: если мы ничего не знаем в одном пространстве, то ничего не знаем и в другом.
Авторы доклада показали возможностный аналог теоремы Байеса (формулы пересчёта вероятностей при получении новых данных). Вероятностная часть была известна давно, а возможностная представлена в 2026 году.
Новый алгоритм обучения и свежие результаты 2025 года
В 2025 году учёные из Наньянского технологического университета представили аналог теоремы Донскера-Варадхана для теории возможностей. Оригинальная теорема связывает математическое ожидание экспоненты случайной величины с KL-дивергенцией (мерой расхождения двух распределений) и используется в машинном обучении для оценки переобучения нейросетей.
Главное отличие возможностного аналога: вместо одной формулы получаются две. Причина в том, что без жёсткого ограничения «интеграл равен единице» приближать можно по-разному, и на множестве функций возможностей возникает частичный порядок.
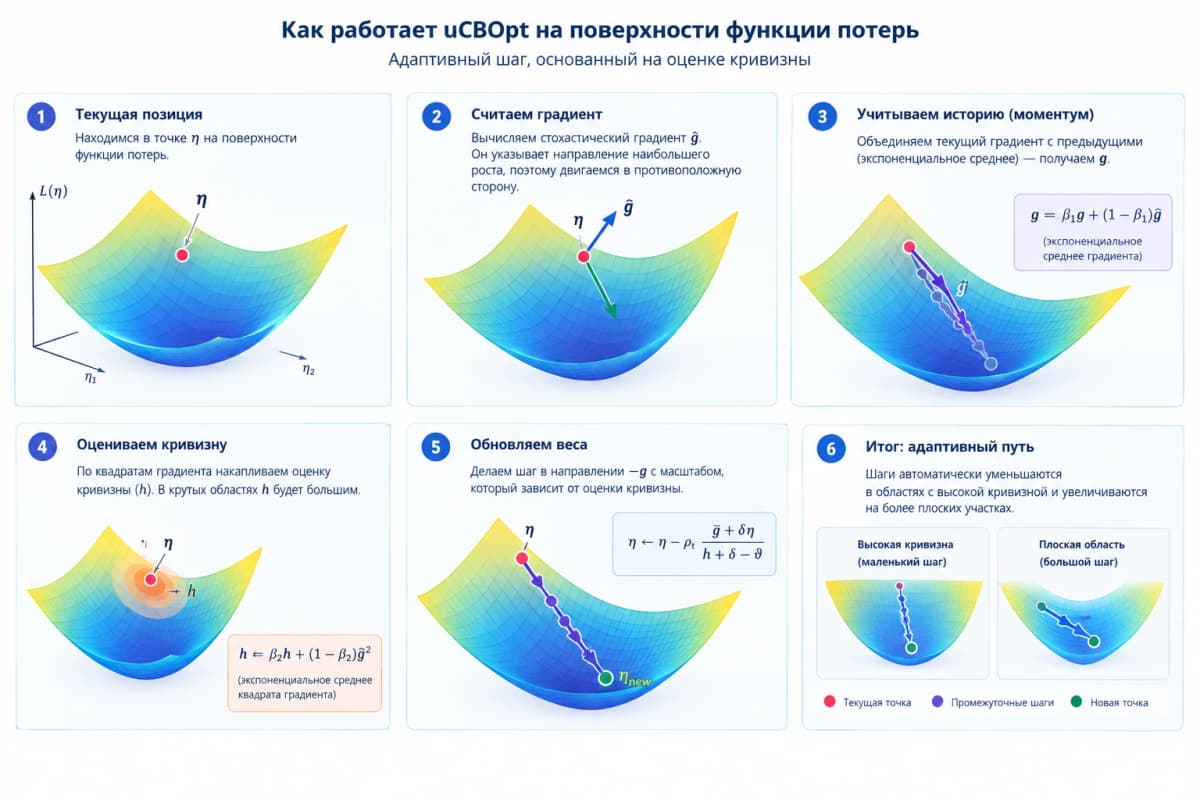
Под теорию возможностей адаптировали и сам механизм обучения. Алгоритм uCBOpt (upper CBO Optimisation) модифицирует градиентный спуск и отличается от стандартного Adam тем, что встраивает затухание весов (weight decay, механизм предотвращения переобучения) прямо в обновление параметров, что даёт лучший контроль над регуляризацией.
Что показали тесты?
Авторы сравнили uCBOpt-adapt (версию алгоритма с автоматической подстройкой параметров в процессе обучения) с классическими методами на нескольких наборах данных, включая CIFAR-10 и CIFAR-100.
На знакомых данных (in-domain):
- Точность выше, чем у остальных методов.
- Низкое отрицательное логарифмическое правдоподобие: модель не просто угадывает класс, а даёт высокую уверенность для правильного ответа и низкую для неправильных.
- Низкая ожидаемая ошибка калибровки у uCBOpt-adapt: разница между уверенностью модели и реальной точностью минимальна.
На незнакомых данных (out-of-domain):
- По метрике FPR@95 (как часто модель путает «чужой» объект со «своим» при порога обнаружения 95% аномалий) один из вариантов алгоритма оказался среди лучших.
- По метрике AUPR-Out (оценка качества обнаружения чужих объектов при дисбалансе классов) результаты также конкурентоспособны.
Вывод авторов: когда информация есть, теория возможностей работает не хуже теории вероятностей, а когда информации мало, честнее показывает границы незнания.
Когда информация есть, теория возможностей работает не хуже теории вероятностей: uCBOpt-adapt показывает лучшие результаты по ключевым метрикам. : Из выводов доклада Жереми Уссино
Что это значит для вас?
Это исследование, не продукт, и до массовых инструментов далеко. Но направление стоит отслеживать. Основы машинного обучения построены на теории вероятностей, и если в фундамент встроят возможностный подход, это изменит то, как модели сообщают о своей неуверенности. Для тех, кто хочет разобраться глубже, есть «машинное обучение основы» Николенко в PDF, это хорошая база, чтобы понимать контекст таких исследований.
Автору Дзена. Галлюцинации ИИ, это не баг конкретной модели, а следствие математического фундамента. Понимание этого помогает критичнее относиться к ИИ-ответам и честно предупреждать читателей: модель может быть уверена в ответе, даже когда данных для уверенности нет.
Маркетологу. Если вы используете ИИ для аналитики на малых выборках (нишевые аудитории, локальные рынки), текущие модели могут давать ложную уверенность. Возможностный подход в будущих инструментах мог бы честно показывать: «данных мало, доверять выводу рискованно».
Предпринимателю в РФ. Теория возможностей особенно актуальна для задач, где данных мало и цена ошибки высока: космическая отрасль, риск-менеджмент, регуляторика. Российские компании, работающие с Роскосмосом или финансовыми рисками, получат инструмент честной оценки уверенности модели, когда (и если) алгоритмы вроде uCBOpt дойдут до продуктовых решений.
Алгоритм пока проверен на академических наборах данных (CIFAR-10, CIFAR-100). До интеграции в коммерческие продукты и доступные фреймворки машинного обучения может пройти несколько лет. Прямо сейчас это не инструмент, а направление исследований.
Наука движется: теория возможностей получила свой градиентный спуск и свои аналоги ключевых теорем. Как точно отмечают авторы доклада, машинное обучение помогает двигать вперёд математику, а не только забирает её хлеб.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
LLM применение на практике: графики, бюджет и отчёты без единой строчки кода
Большие языковые модели (LLM, от английского Large Language Model) давно вышли за рамки «поболтать с чат-ботом»: сегодня это рабочий инструмент для подсчёта…
Что такое ИИ-агент без контроля: боты OpenAI 16 000 раз атаковали сайт ООН сами
ИИ-агенты OpenAI сканировали статистический сайт Конференции ООН по торговле и развитию (UNCTAD) более 16 000 раз за три месяца, самостоятельно обходя…
Engram за $675: нейросеть для генерации музыки превращает ошибки ИИ в звуки
Почему это важно Впервые аппаратный музыкальный инструмент использует «сломанные» галлюцинации (когда ИИ уверенно выдумывает то, чего не было) локальной…
Комментарии