
Суд в США одобрил продажу данных Spirit Airlines компании Google за $10 млн: на них обучат ИИ
Федеральный суд по банкротствам в Нью-Йорке одобрил продажу внутренних данных Spirit Airlines компании Google за $10 млн, а Google собирается обучать на переписке и звонках перевозчика свои модели искусственного интеллекта.
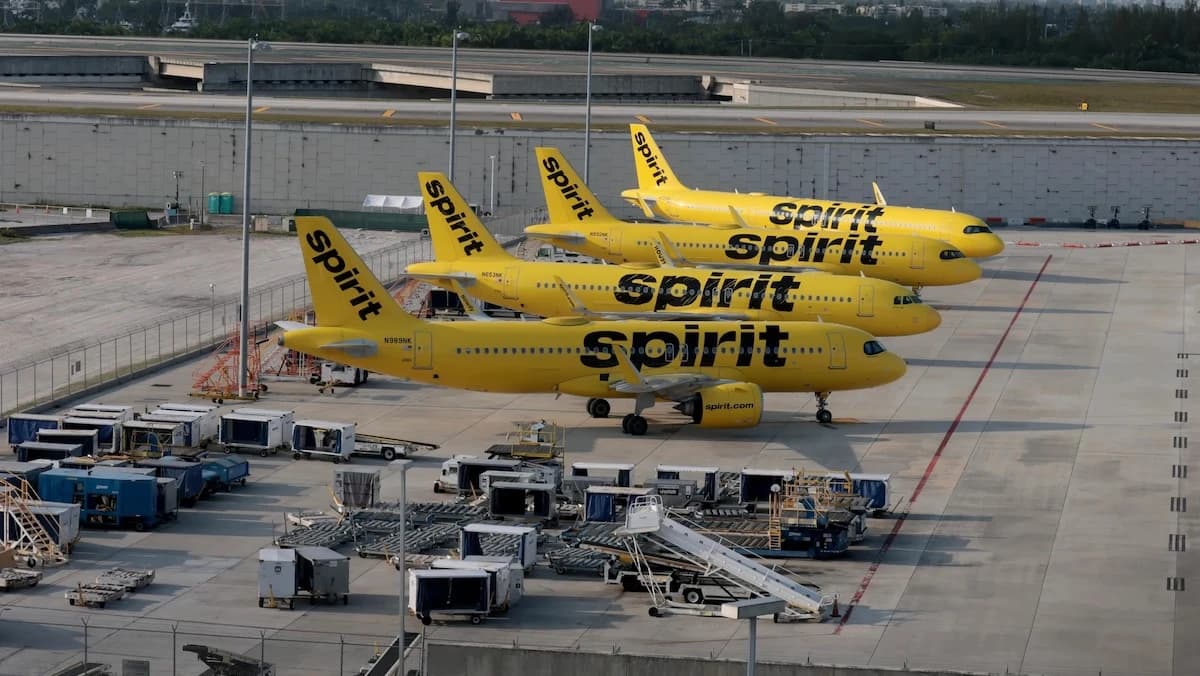
Рабочую переписку сотрудников продали как обычный актив банкротства. Суд пропустил сделку только после того, как Google согласилась на дополнительные меры защиты, а с профсоюзом договорилась отделять рабочие данные людей от личных.
Spirit Airlines, бюджетная авиакомпания из США, весной приостановила работу, а летом при ликвидации её активов Google выиграла аукцион на внутренние данные перевозчика. Как сообщает Reuters, суд по банкротствам в США одобрил продажу данных Spirit Airlines компании Google после протестов профсоюзов и более 120 американских законодателей. Ниже разберём, что купила Google, и как по этому шаблону навести порядок в собственных данных до того, как их увидит любая нейросеть.
Что именно купила Google за $10 млн?
В лот вошёл почти весь внутренний архив компании:
- электронные письма и чаты сотрудников;
- файлы из OneDrive и SharePoint, облачных хранилищ документов Microsoft;
- записи звонков в службу поддержки;
- заявки в ServiceNow, системе учёта обращений и внутренних задач;
- архив данных о полётах, закупках топлива и запчастей;
- сведения об экипаже.
Google объявила, что использует эти данные для разработки своих продуктов и обучения моделей ИИ. Они станут обучающими данными, то есть примерами, на которых модель учится понимать язык и рабочие процессы.
Почему суд согласился только после уступок?
В октябре омбудсмен по защите данных (независимый уполномоченный, который следит за соблюдением прав на информацию) рекомендовал одобрить сделку, но без личной информации клиентов. В конце того же месяца законодатели попросили Google «по возможности максимально исключить информацию о сотрудниках из сделки». По их словам, в архиве сотни миллионов писем и сообщений сотрудников в Microsoft Teams, корпоративном мессенджере.
В первой половине ноября Google заключила соглашение с профсоюзом бортпроводников. Документ описывает механизм, который отделяет рабочие данные, созданные сотрудниками, от их персональной информации. Как этот механизм устроен технически и какие именно меры защиты взяла на себя Google, источник не раскрывает.
Что понадобится, чтобы разобрать свои данные?
В России персональные данные сотрудников и клиентов регулирует 152-ФЗ, закон «О персональных данных». Если вы передаёте внутренний архив подрядчику, сервису или нейросети, не выделив из него личное, вы рискуете. Для разбора понадобится:
- выгрузка рабочей почты, чатов и документов за выбранный период;
- список категорий личных данных: ФИО, телефоны, адреса, паспортные данные, сведения о здоровье и семье;
- доступная в РФ нейросеть для черновой разметки, например YandexGPT или GigaChat;
- от 2 до 4 часов на первый проход по небольшому архиву.
Пошаговая инструкция: как отделить рабочие данные от личных
- Составьте опись: какие источники данных у вас есть (почта, мессенджеры, записи звонков, таблицы клиентов).
- Для каждого источника решите, что в нём рабочее (сам процесс, решения, шаблоны), а что личное (кто, где живёт, как связаться).
- Возьмите небольшой фрагмент и замените реальные имена и контакты метками ещё до загрузки в нейросеть.
- Попросите модель найти оставшиеся персональные данные промптом:
Ниже текст рабочей переписки. Найди в нём все персональные данные:
имена, телефоны, адреса, email, паспортные и медицинские сведения.
Выведи таблицу: фрагмент, тип данных, что заменить.
Ничего не сокращай и не пересказывай.
- Проверьте таблицу вручную и замените найденное на нейтральные метки.
- Сохраните «чистую» версию отдельно от исходной и только её передавайте дальше.
Допустим, у вас архив писем с подписчиками за год, и вы хотите собрать из него базу частых вопросов. Вы заменяете имена на «Клиент 1», «Клиент 2», загружаете фрагмент с промптом выше и получаете таблицу, где модель отметила пропущенные телефоны и почты. После ручной проверки остаётся только суть вопросов, её уже можно превращать в статьи.
- Загружать в нейросеть сырой архив «на разметку». Сама передача персональных данных стороннему сервису уже может нарушать 152-ФЗ.
- Доверять разметке без проверки. Модель склонна к галлюцинациям (когда ИИ уверенно выдумывает или пропускает то, что есть в тексте), поэтому часть данных она не заметит.
- Забывать о записях звонков: в голосе и расшифровках личного не меньше, чем в почте.
- Удалять исходники до проверки «чистой» версии.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Переписка с читателями, разборы и консультации тоже становятся данными. Прежде чем строить на них контент или отдавать их нейросети, уберите имена и контакты.
Маркетологу. Записи звонков и чаты поддержки, судя по сделке со Spirit, имеют рыночную цену. Ведите их сразу в двух слоях, рабочем и личном, тогда передать подрядчику можно будет без риска.
Предпринимателю РФ и СНГ. Американский кейс показывает, что при ликвидации компании её архив могут продать целиком. Опишите в договорах с сотрудниками, что считается рабочими данными, а что их личными.
На мой взгляд, главное в этой истории не $10 млн, а соглашение с бортпроводниками: разделение «рабочее отдельно, личное отдельно» стало условием сделки. Я бы закладывал такое разделение в любой проект с ИИ с первого дня, а не тогда, когда придут юристы. Оговорка честная: нейросеть ускоряет разметку, но ответственность за пропущенный телефон в выгрузке остаётся на вас.
Проверьте тексты перед публикацией
Инструменты dzen.guru помогают готовить материалы для Дзена с нейросетями без лишнего риска.
ПопробоватьАрхив вашей компании однажды тоже может кому-то понадобиться. Разделите в нём рабочее и личное сейчас, пока это решаете вы, а не суд.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
95% корпоративных ИИ-пилотов не дают прибыли: Европа тормозит на входе, Россия на выходе
Исследователи MIT зафиксировали, что 95% корпоративных ИИ-пилотов не приносят измеримой прибыли, и свежая статистика Европы и России показывает ту же стену:…
ИИ применяют 83% команд, а код до релиза доводят лишь 24%: где теряется ускорение
SimpleOne опросила 71 специалиста и выяснила, что искусственный интеллект применяют 83% команд, но лишь 24% выпускают созданный с ним код в рабочие системы, а…
СУБД Jatoba выявляет персональные данные с помощью ИИ и сама их маскирует
Разработчик отечественной системы управления базами данных «Ятоба» встроил в неё ИИ-поиск персональных данных, который заменил ручную проверку таблиц и…
Комментарии