
Синтез речи на длинном тексте: почему 14 тестовых фраз врут о качестве
Автору Дзена или маркетологу, который хочет озвучить длинный текст нейросетью, 14 тестовых фраз покажут идеальный результат, а на реальной книге всё развалится: пропадут целые предложения, обрежутся первые слова, поплывёт разметка.
Синтез речи на коротких фрагментах и синтез речи на полноценном тексте в два часа звучания ломаются в совершенно разных местах, и ни один стандартный тест этого не покажет.
Автор серии статей о синтезе речи для крымскотатарского языка провёл эксперимент, который редко кто повторяет: озвучил нейросетью целый роман Шамиля Алядина «Merdiven» («Лестница»), 16 глав, 15 444 слова, 1 час 58 минут звучания. Результат оказался неожиданным: сама модель держалась ровно все два часа, а ломалось всё вокруг неё.
Почему 14 тестовых фраз врут о качестве?
Проверочный набор из 14 фраз показывал CER (Character Error Rate, долю символьных ошибок при обратном распознавании) около 14 %. На реальной прозе первой главы CER оказался меньше 2 %. Модель не стала лучше за ночь. Просто тестовый набор нарочно враждебный, а обычный текст нет.
Вывод прямой: цифру с проверочного набора нельзя выдавать за качество реального чтения. Она годится только для сравнения версий модели между собой, и даже с этим справляется не всегда.
Что понадобится
- Модель синтеза речи, способная работать с нужным языком (в эксперименте использовалась многоязычная модель с опытом на казахском, уйгурском и башкирском)
- Модель распознавания речи для обратной вычитки, когда синтезированный звук прогоняется через распознавалку и результат сравнивается с исходным текстом
- Голосовой образец: несколько секунд записи с точным текстом (в эксперименте использовался семисекундный образец голоса Sevil)
- Скрипт нарезки текста на предложения и склейки звука
- Скрипт обрезки вдохов в начале фраз
- Время: озвучка романа на 16 глав заняла 18 часов синтеза, не считая отладки
Пошаговая инструкция: как не сломать синтез речи на длинном тексте
-
Проверьте текст на утечку в обучающие данные. Если текст попал в обучение, модель не читает, а вспоминает, и результат будет ложно хорошим. В эксперименте сравнивались словные шестиграммы (цепочки из шести слов подряд): 0 совпадений из 14 656 цепочек книги против корпуса на 1,38 млн слов. Обе стороны перед сравнением приводились к общему грубому латинскому скелету, такая свёртка теряет различия только в сторону лишних совпадений, поэтому ноль у неё честный.
-
Не склеивайте короткие предложения с соседними. Логика кажется железной: раз самые короткие клипы в обучающих записях длились 2,94 секунды, реплику короче 43 букв лучше приклеить к соседней. На практике склеенные фрагменты занимали 25 % символов главы и давали 43 % ошибок. Модель начинала выбрасывать целые предложения.
-
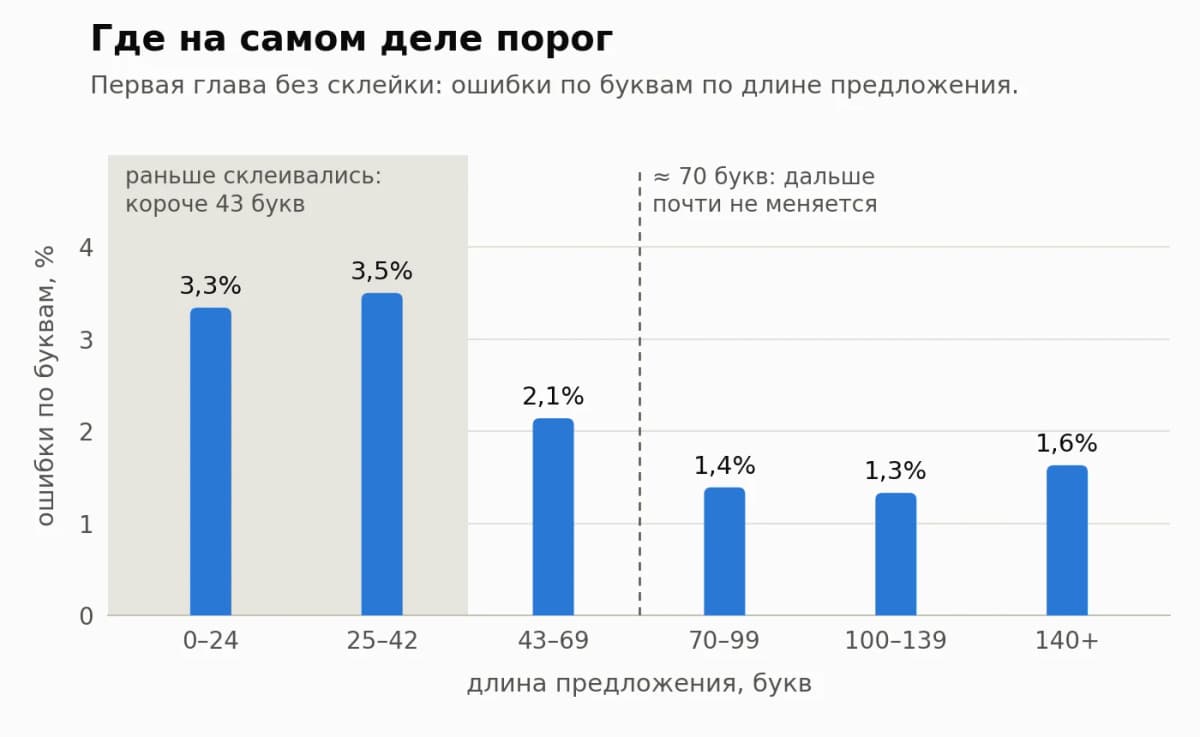
Замерьте ошибки по длине предложения без склейки. Короткие предложения действительно дают больше ошибок, примерно в два с половиной раза. Но обрыва на 43 буквах нет: корзины от 0 до 24 и от 25 до 42 букв одинаковы, а CER продолжает падать примерно до 70 букв. Штраф за короткие реплики стоит около 2 процентных пунктов CER на 15 % текста, а склейка обходилась в 3,3 пункта на 25 % текста и вдобавок теряла целые предложения.
-
Перепишите обрезку вдохов. Синтез речи иногда начинает фразу со вдоха, как живой диктор. Наивная обрезка ищет первый звонкий кадр, а глухие согласные до него считает вдохом. Результат: «Çañ qaqıldı» превращается в «Qaqıldı». В 111 предложениях из 147 срез приходился внутрь первого слова. Правильная обрезка смотрит на громкость: согласный тихий, но намного громче паузы перед ним.
-
Проверяйте голосовое сходство на длинной дистанции. Сходство голосовых эмбеддингов (числовых «отпечатков» голоса) с первой минутой главы оставалось в пределах от 0,96 до 0,98 все двенадцать минут первой главы. Темп ровный. Если у вас этот показатель падает, проблема в образце или в модели, а не в обвязке.
-
Используйте обратную вычитку как основной прибор. Синтезируйте предложение, прогоните звук через распознавание и посчитайте CER гипотезы против исходного текста. Цифру считайте корпусную: сумма правок на сумму символов эталона, а не среднее по клипам. Клипы, на которых распознавалка ушла в петлю (правок больше, чем слов в эталоне), помечайте отдельно.
-
Помните о слепых пятнах прибора. Обратная вычитка не слышит ударения и вдохов, не умеет проверять числа, и она сама модель со своими сбоями. Всё это приходится закрывать ухом, ручным прослушиванием.
Роман «Merdiven» на крымскотатарском языке: 16 глав, 15 444 слова. Модель озвучивала каждое предложение по одному семисекундному образцу голоса Sevil. На первой главе из 147 фрагментов 38 содержали больше одного предложения из-за склейки. Фраза «Я ошибся. Он, оказывается, не учитель» превратилась в «Он, оказывается, не учитель», первое предложение просто исчезло. После отключения склейки и замены обрезки вдохов CER первой главы упал ниже 2 %, а голос оставался стабильным все 1 час 58 минут. При этом ни одна из трёх найденных проблем (склейка, обрезка, нарезка) не проявилась на стандартном наборе из 14 проверочных фраз.
- Доверять тестовому набору. 14 фраз не покажут ни потерю предложений при склейке, ни обрезку первых слов, ни проблемы с разметкой времени. CER 14 % на тесте и CER 2 % на прозе живут в разных реальностях.
- Склеивать короткие реплики «на всякий случай». Граница, ради которой вводится склейка, может не совпадать с реальным порогом модели. Проверяйте распределение ошибок по длине, а не ставьте порог по длине обучающих клипов.
- Резать вдохи по звонкости. Глухие согласные (к, с, ш, ч) тише вдоха, но громче тишины. Обрезка по первому звонкому кадру съест начало большинства предложений.
- Считать CER средним по клипам. Корпусная цифра (сумма правок на сумму символов) честнее: одно длинное безошибочное предложение не компенсирует два коротких с потерей слов.
- Забывать про утечку обучающих данных. Если текст был в обучении модели, синтез речи будет подозрительно хорош, но не потому что модель читает, а потому что она вспоминает.
Что делать с этим прямо сейчас?
Авторам Дзена, которые озвучивают длинные статьи или подкасты. Если вы пользуетесь синтезом речи онлайн бесплатно или через платные сервисы, не оценивайте качество по первому абзацу. Прогоните весь текст целиком, послушайте середину и конец: именно там вылезают пропущенные предложения и обрезанные слова.
Маркетологам и продюсерам контента. Перед тем как заказать озвучку длинного материала нейросетью, попросите исполнителя показать результат обратной вычитки на полном тексте, а не на демо-фрагменте. Разница между демо и полным прогоном может быть в разы.
Разработчикам и тем, кто строит пайплайн синтеза для локальных языков. Опыт крымскотатарского романа показывает: дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу) решает проблему произношения специфических звуков, но не спасает от ошибок в обвязке. Модель, тембр и скрипты вокруг них чинятся по отдельности, и это хорошая новость: не нужно переобучать модель каждый раз, когда сломалась нарезка текста.
Этот эксперимент ценен не технологией, а методом. Большинство сервисов синтеза речи онлайн бесплатно показывают демо на коротких фразах, где всё звучит идеально. На длинном тексте ломается не голос, а инженерия вокруг него: нарезка, склейка, обрезка пауз. И это именно то, что не видно ни в одном маркетинговом демо.
По моим наблюдениям, для русского языка ситуация аналогичная. Я тестировал несколько сервисов на текстах длиннее 5 000 слов, и проблемы одни и те же: потеря предложений на стыках, съеденные первые слоги после пауз, дрейф интонации к концу. Проверочный набор из десятка фраз этого не покажет.
Честная оговорка: автор эксперимента намеренно не называет конкретную модель, параметры обучения и скрипты. Повторить эксперимент один в один не получится, но методика, обратная вычитка на полном тексте с разбивкой ошибок по длине предложений, применима к любому TTS-сервису.
Главный урок этого эксперимента укладывается в одну строку: тестируйте синтез речи на том тексте, который вам реально нужен, а не на демо-фразах, и проверяйте результат обратной вычиткой от начала до конца.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
OpenAI урезала прогноз доходов на $20 млрд: виновата разница в методологии с Anthropic
OpenAI второго июня скорректировала прогноз годовой выручки с 70 до 50 миллиардов долларов, и разница в 20 миллиардов объясняется не падением продаж, а тем,…
Gemini агент объединил все задачи в одном окне: модель сама выбирает нужный ИИ
Gemini стал единым рабочим агентом: Google Cloud объединила все задачи в одном окне промпта и впервые отдала модели право самой выбирать, какой ИИ подключить.…
Amazon и Microsoft отказались от NDA при строительстве дата центров: сотни мораториев вынудили
Почему это важно Amazon отказывается от соглашений о неразглашении при строительстве дата-центров, и это уже тенденция: Microsoft сделала то же самое ранее в…
Комментарии