
Simile AI привлекла $2 млрд, чтобы доказать: scaling laws нейросети работают и для симуляции людей
Компания Simile AI, основанная автором знаковой работы о генеративных агентах Smallville, привлекла два миллиарда долларов в раунде Series B и предлагает бизнесу тестировать продукты на цифровых двойниках реальных людей вместо дорогих фокус-групп.
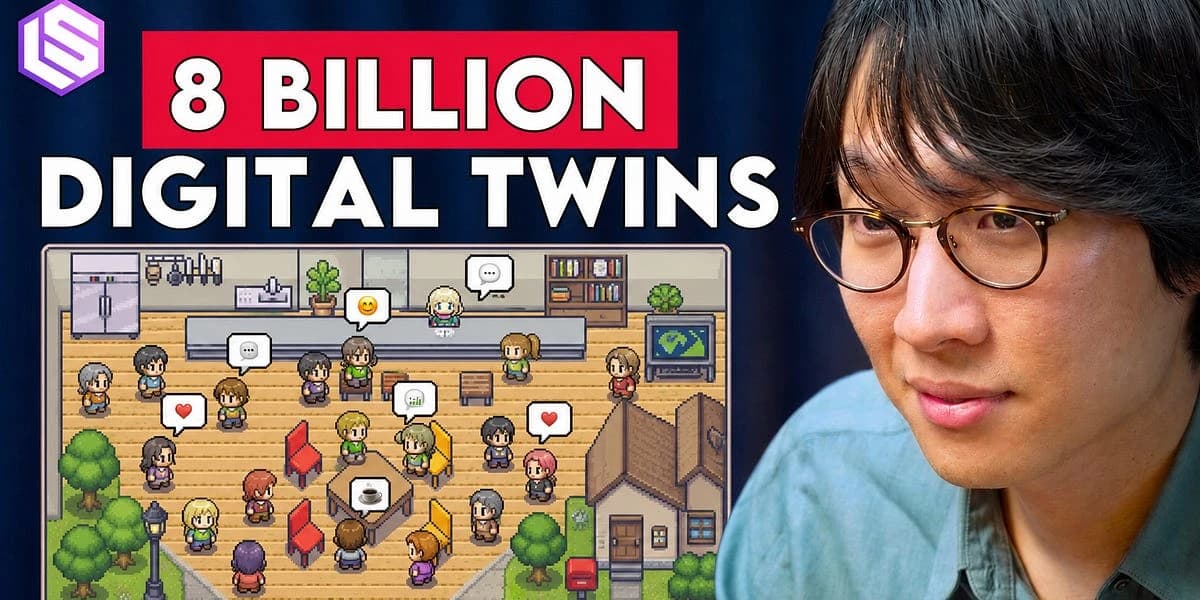
Simile AI строит поведенческие модели на основе интервью и транзакций реальных людей, а не просто промптов (промпт, текстовая команда для нейросети) к большим языковым моделям. По данным компании, цифровые двойники воспроизводят поведение людей с точностью от 85 до 99 процентов по сравнению с живыми фокус-группами. Для маркетолога или продуктового менеджера это означает возможность проверить гипотезу на синтетической аудитории за часы, а не за недели.
Источник новости, подкаст Latent Space, где сооснователь и генеральный директор Simile AI Джун Сон Пак (Joon Sung Park) рассказал о пути от академической статьи Generative Agents (2023) до коммерческой платформы. Раунд Series B поддержали фонды GreenOaks и Index Ventures, среди заметных инвесторов, профессор Стэнфорда Фей-Фей Ли и бывший директор ИИ в Tesla Андрей Карпати. Среди клиентов компании, компании из списка Fortune 100, включая сеть аптек CVS.
Что стоит за идеей «законов масштабирования для симуляции»?
Scaling laws нейросети (законы масштабирования, правило: чем больше данных и вычислений, тем лучше результат модели) до сих пор применялись к обучению языковых моделей. Джун Сон Пак утверждает, что аналогичный закон работает и для симуляции поведения людей: чем больше данных о реальном поведении загружено в модель, тем точнее она воспроизводит решения и предпочтения конкретного человека или целой популяции.
Ключевое отличие от обычного промпт-инжиниринга (промпт-инжиниринг, искусство формулировать запросы к нейросети так, чтобы получить нужный ответ): frontier-модели, то есть самые продвинутые закрытые модели (закрытая модель, нейросеть с недоступным исходным кодом) вроде GPT-4 или Claude, обучены на веб-текстах. Веб-тексты фиксируют, что люди говорят, но не то, что они реально делают. Поэтому, по словам Пака, простое промптирование большой языковой модели не даёт надёжной симуляции.
Как Simile AI строит цифровых двойников?
Компания собирает данные из нескольких источников:
- Длинные структурированные интервью с реальными людьми.
- Транзакционные данные (что человек покупает, когда, за сколько).
- Наблюдательные данные (как ведёт себя в сервисах).
- Рандомизированные контролируемые испытания (RCT, эксперимент, где одну группу тестируют, а другую оставляют контрольной).
На этих данных Simile проводит дообучение (дообучение, обучение уже готовой модели на узком наборе примеров под конкретную задачу) поведенческих моделей. Модели учатся воспроизводить не рациональное, а реальное поведение, включая когнитивные искажения и нелогичные решения.
По словам Пака, именно здесь возникает необходимость менять веса модели, а не просто подбирать промпт. Frontier-модели оптимизированы быть «рациональными», а люди таковыми не являются.
Что понадобится
Если вы хотите протестировать подход к симуляции аудитории уже сейчас, вот минимальный набор:
- Доступ к Simile AI (simile.com) или аналогичной платформе синтетических панелей.
- Набор данных о целевой аудитории: даже базовые анкеты, история покупок, логи поведения в продукте.
- Понимание вопроса, который вы проверяете: не «опишите нашу аудиторию», а конкретная гипотеза («поднимем цену на 15 процентов, какой будет отток»).
- Около двух-четырёх часов на первую итерацию, если платформа уже настроена.
Пошаговая инструкция
-
Сформулируйте гипотезу, которую хотите проверить. Не «какой контент зайдёт», а конкретно: «Если я сменю формат поста с текста на карточки, вырастет ли дочитываемость у подписчиков 45+?»
-
Соберите данные об аудитории. Для Simile это интервью и транзакции. Если вы работаете без доступа к Simile, подготовьте системный промпт (системный промпт, скрытая инструкция, которая задаёт модели роль и контекст) для языковой модели с максимально подробным описанием сегмента:
Ты — читатель канала о здоровье на Дзене, женщина 52 лет,
живёшь в Воронеже, доход средний, читаешь канал три раза в неделю,
обычно дочитываешь до конца посты-списки, но бросаешь лонгриды
после второго экрана. Отвечай так, как ответила бы на опрос
автора канала. Не старайся быть вежливой — отвечай честно.
-
Запустите серию вопросов по вашей гипотезе. Задавайте один и тот же вопрос десяти-двадцати «персонам» с разными профилями, чтобы увидеть разброс ответов.
-
Сравните результат с реальным поведением. Если у вас есть статистика Дзена или метрики рекламного кабинета, сверьте ответы синтетической аудитории с фактическими цифрами. Расхождение покажет, где модель галлюцинирует (галлюцинация, когда нейросеть уверенно выдаёт несуществующий факт).
-
Скорректируйте системный промпт и повторите. Каждая итерация делает профиль точнее. Именно здесь scaling laws нейросети работают на вас: больше данных в промпте или при дообучении, точнее результат.
Допустим, автор Дзена ведёт канал о личных финансах. Он хочет понять, стоит ли запускать платную рассылку за 299 рублей в месяц. Он создаёт пять профилей подписчиков в ChatGPT с разным доходом, возрастом и частотой чтения, задаёт каждому вопрос: «Подпишетесь ли вы на платную рассылку за 299 рублей?» Четыре из пяти синтетических читателей отвечают «нет», но объясняют причины: «Слишком дорого при бесплатных альтернативах», «Подпишусь, если будет пробная неделя». Автор получает не прогноз с процентами, а набор возражений, которые может отработать до запуска. При этом он помнит: это симуляция, а не замена реального опроса.
- Принимать ответ языковой модели за факт. Модель не знает вашу аудиторию, она генерирует правдоподобный текст. Без сверки с реальными данными любая симуляция остаётся гипотезой.
- Делать одну персону и верить ей безоговорочно. Чем меньше профилей, тем выше шанс попасть в «галлюцинацию среднего». Нужен разброс.
- Использовать общий промпт без конкретики. «Ты обычный покупатель» бесполезен. Чем детальнее профиль (возраст, город, привычки, болевые точки), тем ближе ответ к реальности.
- Путать симуляцию и предсказание. Пак подчёркивает: цель симуляции не предсказать будущее, а понять, как на него повлиять. Это инструмент для проверки решений, а не хрустальный шар.
Что это значит для вас?
Автору Дзена. Вы можете прямо сейчас использовать ChatGPT или YandexGPT как «синтетического читателя»: создайте пять-семь персон ваших подписчиков и протестируйте на них заголовок, структуру поста или идею нового формата. Это не заменяет аналитику Дзена, но сокращает путь от идеи до проверки с дней до минут.
Маркетологу. Simile AI пока работает с клиентами уровня Fortune 100. Но сам подход, строить синтетические панели вместо живых фокус-групп, уже доступен через промпт-инжиниринг в любой frontier-модели. Из доступных в России аналогов: YandexGPT и GigaChat позволяют задать персону через системный промпт и провести быстрый «опрос».
Предпринимателю в РФ. Платформа Simile AI ориентирована на американский рынок, доступ из России на момент публикации не подтверждён. Но метод, собрать данные о клиентах, загрузить в модель, тестировать гипотезы на цифровых двойниках, воспроизводим локально. Если у вас есть CRM с историей покупок, это уже половина входных данных для поведенческой симуляции.
Идея Пака красивая, и два миллиарда долларов показывают, что инвесторы в неё верят. Но я бы не торопился называть это заменой реальных исследований. 85 процентов точности, это цифра самой компании, независимого аудита в источнике нет. Для скрининга идей, отлично. Для принятия решения о запуске продукта на миллионный бюджет, я бы всё-таки провёл живой тест.
Что действительно ценно: подход Simile показывает, куда движутся scaling laws нейросети применительно к поведению людей. Не просто «больше параметров, умнее текст», а «больше данных о реальном поведении, точнее модель конкретного человека». Для тех, кто работает с аудиторией, это практичнее, чем очередной рост бенчмарков на академических тестах.
Честная оговорка: ни одна симуляция не учитывает то, чего нет в данных. Чёрные лебеди, внезапные изменения рынка, новые законы, всё это за пределами любой модели, будь она хоть на восемь миллиардов цифровых двойников.
Попробуйте создать синтетического читателя
В инструментах dzen.guru есть генератор персон для авторов Дзена. Загрузите данные о вашем канале и получите профиль типичного подписчика за пять минут.
Создать персонуГлавный вывод из истории Simile AI не в том, что симуляция заменит живых людей. А в том, что тестировать идеи на синтетической аудитории можно уже сегодня, бесплатно, с помощью промпта и здравого смысла, и это лучше, чем не тестировать вообще.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
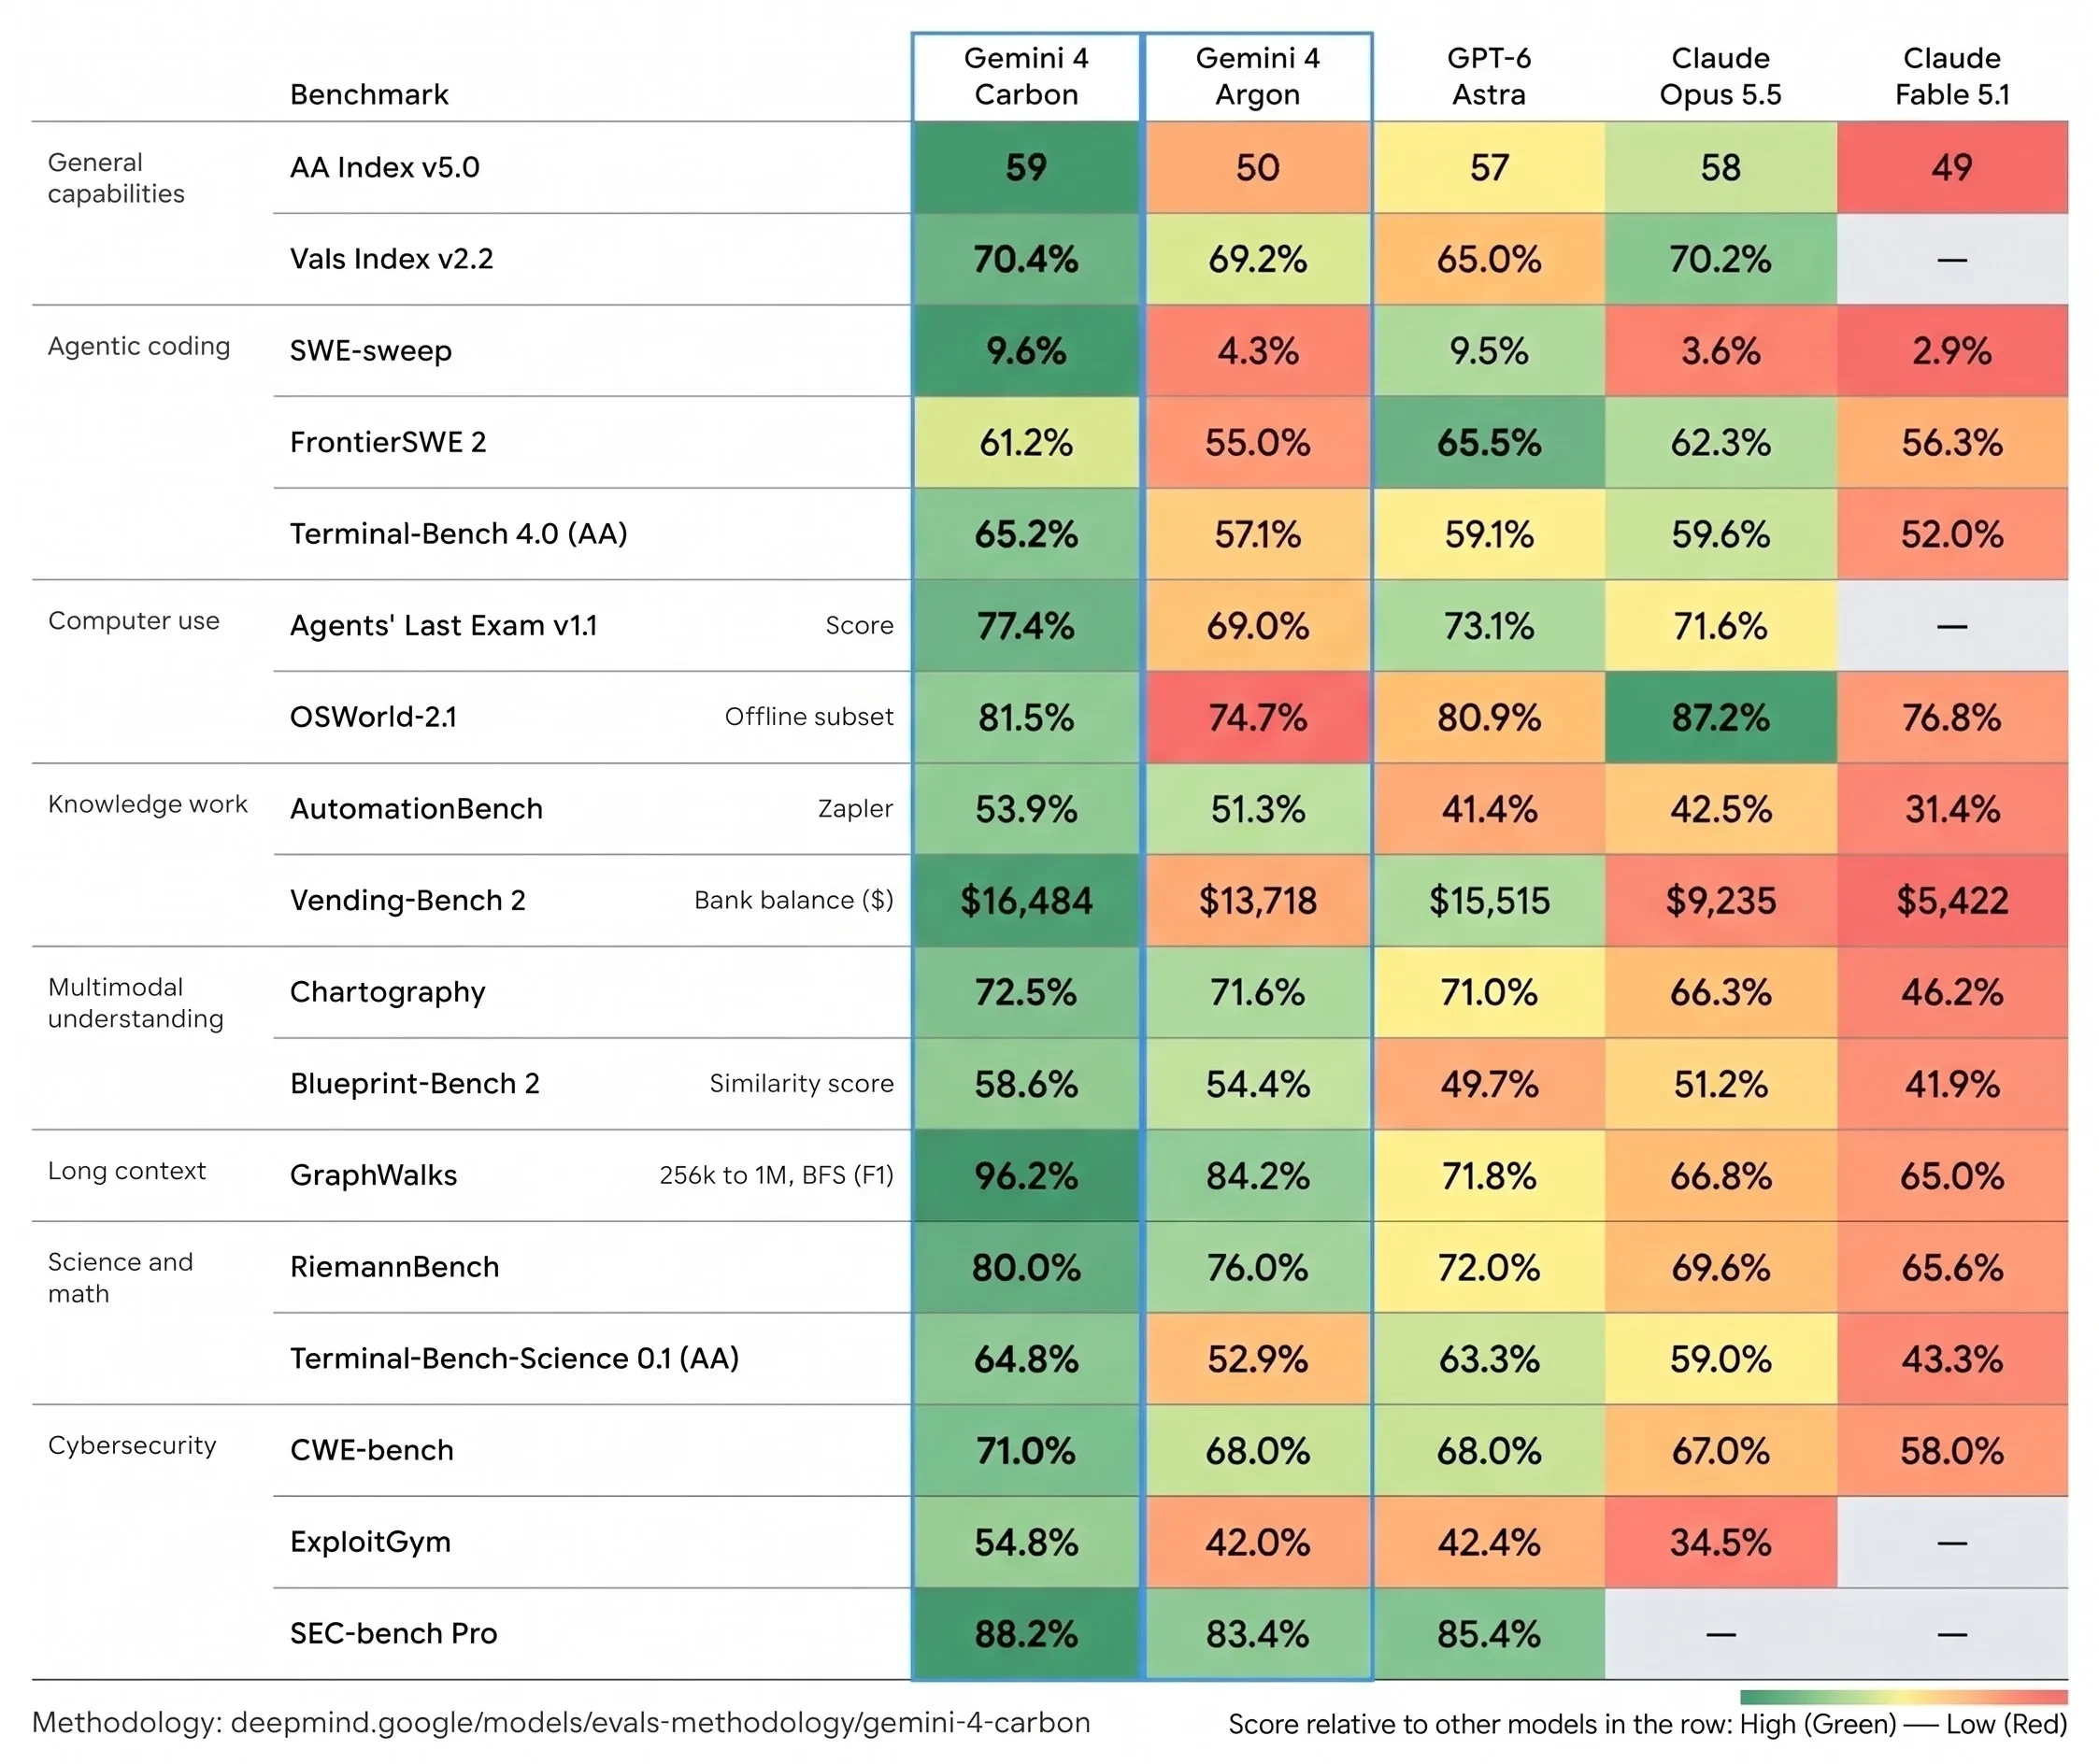
Gemini 4 Carbon нашла уязвимости в 88,2% задач и вывела Google на первое место рейтинга
Google DeepMind представила Gemini 4 Carbon, модель для поиска и закрытия уязвимостей, которая сразу возглавила независимый рейтинг Artificial Analysis,…
11 часов бесплатного видео: как собрать reasoning модель с нуля на PyTorch
Компания Sebastian Raschka (автор книги «Build a Large Language Model (From Scratch)») 3 июня 2025 года выложила в открытый доступ восемь видеолекций общей…
Kimi AI выпустила открытую модель на 2,8 трлн параметров и обошла закрытых конкурентов
Kimi AI выпустила модель с 2,8 триллиона параметров, которая 22 октября 2026 года обошла закрытые аналоги в независимых тестах и станет доступна с открытыми…
Комментарии