
Семантический поиск: как за 30 лет поисковики перешли от подсчёта слов к пониманию смысла
Почему это важно Путь поиска от буквального совпадения слов к пониманию смысла напрямую определяет, как сегодня работают и поисковики, и ИИ-чаты, и именно это…
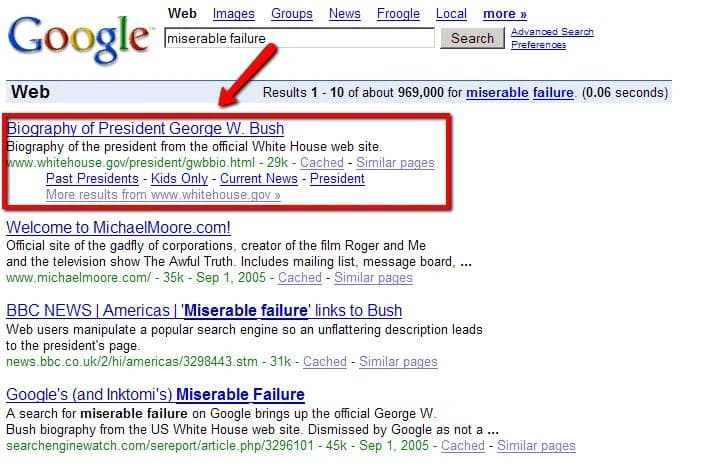
Путь поиска от буквального совпадения слов к пониманию смысла напрямую определяет, как сегодня работают и поисковики, и ИИ-чаты, и именно это влияет на то, находят ли ваш контент читатели.
Поисковые системы прошли путь длиной в три десятилетия: от слепого подсчёта совпадений слов до семантического поиска (когда система понимает смысл запроса, а не ищет буквальные совпадения), и каждый шаг этой эволюции объясняет, почему ваш текст сегодня ранжируется так, а не иначе.
Материал dzen.guru разбирает ключевые вехи этого пути с примерами на русском языке, где проблемы раннего поиска проявлялись особенно болезненно: русская грамматика с её отрицаниями, предлогами и падежами ломала логику старых алгоритмов сильнее, чем английская.
| Что | Когда | Кто описал | Цена |
|---|---|---|---|
| Лексический поиск (Bag of Words, TF-IDF, BM25) | 1990-е и 2000-е | Ранние поисковые системы | Бесплатно для пользователя |
| PageRank как сигнал авторитетности | 1998 | Google (Сергей Брин, Ларри Пейдж) | Бесплатно для пользователя |
| Семантический поиск и ИИ-чаты | 2010-е и далее | Google, Яндекс, OpenAI и другие | Бесплатно / подписки |
Что поиск не понимал и почему это бросалось в глаза на русском языке?
-
Порядок слов игнорировался. Метод Bag of Words (способ представить текст числами: система считает, какие слова встречаются и сколько раз, но не учитывает их порядок) превращал «Иван быстрее Сергея» и «Сергей быстрее Ивана» в одинаковый набор. Два противоположных факта выглядели для машины одинаково.
-
Отрицания и предлоги выбрасывались. Служебные слова «не», «без», «до», «после» попадали в список стоп-слов и удалялись при обработке. В русском языке частица «не» часто полностью переворачивает смысл, и поисковик этого не замечал.
-
Наглядный пример из источника. Запросы «парковка в центре Петербурга у порта» и «парковка в центре Петербурга, но не у порта» после удаления стоп-слов получали одинаковое представление. Человек искал парковку подальше от порта, а система показывала ровно то, чего он хотел избежать.
-
Синонимы не распознавались. Если страница описывала «стоянку», а пользователь искал «парковку», документ мог не попасть в выдачу. Приходилось вручную перебирать формулировки.
-
Опечатка обнуляла результат. До появления автокоррекции одна лишняя или пропущенная буква могла оставить пользователя без ответа.
Как поиск учился взвешивать слова?
Простой подсчёт слов быстро показал свою слабость: общеупотребительные слова встречаются везде и ничего не говорят о теме документа.
Метод TF-IDF (TF, частота слова в документе; IDF, насколько редко это слово встречается во всём интернете) стал первым шагом к тому, чтобы отличать значимые слова от фоновых. В запросе «ошибка Docker 0x80070005» именно код ошибки и слово «Docker» выделяют нужные страницы, а не общее слово «ошибка».
Следующий шаг, BM25 (вероятностный метод ранжирования), добавил учёт длины документа и эффект насыщения. Если термин повторён двадцать раз, страница не считается автоматически в двадцать раз полезнее той, где он упомянут однажды. Первые повторения поднимают оценку заметно, каждое следующее всё меньше.
Оба метода оставались лексическими: они оценивали совпадение букв, но по-прежнему не понимали ни синонимов, ни отрицаний.
PageRank: не про смысл, а про доверие
В 1998 году Сергей Брин и Ларри Пейдж описали алгоритм PageRank. Он не решал задачу понимания языка, а отвечал на другой вопрос: какие из найденных документов заслуживают доверия.
Алгоритм оценивал значимость страницы по входящим ссылкам, причём ссылка с уже авторитетной страницы весила больше, чем ссылка с малоизвестного сайта. Так появилось разграничение, которое работает до сих пор: matching (о чём документ) и ranking (насколько высоко его показать).
От прощения ошибок к семантическому поиску
В начале 2000-х поисковики научились замечать опечатки, учитывать разные формы слов и подстраивать выдачу под язык и регион пользователя. Поиск всё ещё не понимал естественную речь, но стал заметно удобнее.
Настоящий перелом наступил позже, когда появился семантический поиск. Современные системы распознают сущности, учитывают контекст, геопозицию и смысловые связи между словами. ИИ-чаты понимают разные формулировки одного намерения, работают с текстом, изображениями и голосом, используют веб-поиск и учитывают контекст предыдущих разговоров.
Разница с ранними системами принципиальная. Старый чат-бот находил во фразе знакомое ключевое слово и выбирал заготовленную реплику, любое отклонение от сценария заводило диалог в тупик. Сегодняшний ИИ-чат разбирает смысл, а не ключевые слова.
Как попробовать разницу самому?
-
Откройте любой современный поисковик (Google, Яндекс) и введите длинный разговорный запрос: «где в Петербурге припарковаться в центре, но не рядом с портом». Обратите внимание, что система учитывает отрицание «не рядом с портом».
-
Попробуйте тот же запрос в ИИ-чате (ChatGPT, YandexGPT, GigaChat). Сравните: чат даст связный ответ с учётом контекста, а не список ссылок.
-
Для наглядности введите запрос с опечаткой. Современный поисковик исправит её автоматически; поисковик 2000-х не нашёл бы ничего.
Сравнение: как это выглядит в России?
Русскоязычные пользователи могут проверить семантический поиск в Яндексе, YandexGPT и GigaChat (от Сбера). Обе системы доступны бесплатно в базовом режиме.
Яндекс давно учитывает морфологию русского языка: падежи, склонения, формы глаголов. YandexGPT и GigaChat работают как ИИ-чаты и понимают разговорные формулировки на русском.
Для автора, привыкшего к Дзену, ключевое наблюдение: если вы пишете текст для поиска, система давно не считает буквальные вхождения ключевых слов. Она оценивает, насколько текст по смыслу отвечает на вопрос пользователя.
Что это значит для вас по ролям?
Автору Дзена. Эволюция поиска от ключевых слов к семантике означает, что заголовок и текст должны отвечать на вопрос читателя, а не содержать максимум повторов одной фразы. Пишите так, как спрашивает живой человек.
Копирайтеру и маркетологу. SEO-тексты, построенные на механическом повторении ключевых слов, проигрывают материалам, которые раскрывают тему разными формулировками. Синонимы, связанные понятия, ответы на смежные вопросы работают лучше, чем плотность вхождений.
Предпринимателю в РФ и СНГ. Если ваш сайт оптимизирован под буквальные запросы из 2010-х, трафик из поиска будет снижаться. Проверьте, отвечают ли страницы на реальные вопросы клиентов. YandexGPT и GigaChat уже используют семантический поиск при генерации ответов, и ваш контент либо попадает в эти ответы, либо нет.
Примеры из источника с парковкой у порта Петербурга и ошибкой Docker точно показывают, где старый поиск ломался. По моим наблюдениям, многие авторы Дзена до сих пор пишут тексты «под ключевые слова», хотя алгоритмы давно ушли вперёд. Я бы рекомендовал перечитать свои последние пять статей и честно спросить: отвечает ли текст на вопрос или набивает плотность? Одна оговорка: семантический поиск не идеален, он тоже ошибается, особенно в узких профессиональных темах. Но направление необратимо: машина учится понимать смысл, и тексты, написанные для машины старого поколения, проигрывают тем, что написаны для человека.
Частые вопросы
Семантический поиск заменил лексический полностью?
Нет. Современные поисковые системы используют гибридный подход: лексические методы (BM25) работают вместе с семантическими. Для точных запросов вроде кода ошибки «0x80070005» буквальное совпадение по-прежнему важнее. Семантический поиск помогает там, где запрос сформулирован разговорным языком.
Нужно ли теперь убирать ключевые слова из текстов?
Не нужно. Ключевые слова остаются сигналом для поисковика. Но механическое повторение одной фразы десять раз больше не даёт преимущества. Лучше использовать естественные формулировки, синонимы и отвечать на реальные вопросы читателя.
Работает ли семантический поиск на русском языке так же хорошо, как на английском?
Русский язык сложнее для поиска из-за богатой морфологии: шесть падежей, множество форм глаголов, свободный порядок слов. Яндекс учитывает эту специфику давно. Глобальные системы вроде Google тоже адаптировались, но на редких и узкоспециальных запросах русскоязычный семантический поиск может работать менее точно, чем англоязычный, просто потому что обучающих данных (текстов, на которых модель училась понимать язык) на английском значительно больше.
Если ваши тексты до сих пор написаны «для поисковика из 2010-х», самое время переписать хотя бы три самые посещаемые страницы так, как вы объясняли бы тему живому собеседнику.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Подписка Meta Verified выросла в Meta One: ИИ-генерация от $7,99 и тарифы для бизнеса до $499
Meta второго июня добавила к своим приложениям подписки на пару долларов, а теперь, 9 сентября, расширила систему до полноценного набора тарифов Meta One, где…
Бот «Мигалка» обрабатывает 1000 каналов за секунды: LLM, векторные базы данных и PostGIS
Телеграм-бот «Мигалка» собирает сообщения примерно из тысячи телеграм-каналов и за секунды превращает их в адресные оповещения об опасности для конкретной…
Meta открыла WhatsApp Business для ИИ-агентов: как мультимодальность влияет на развитие ИИ-агентов
Почему это важно Meta впервые позволила подключать сторонних ИИ-агентов напрямую к настройке WhatsApp Business, и теперь владелец малого бизнеса может…
Комментарии