
Robots.txt теперь читают ИИ-боты: одна неверная строка убирает сайт из выдачи и ответов нейросетей
Файл robots.txt теперь читают не только поисковые роботы, но и ИИ-агенты с ИИ-поисковиками, поэтому одна неверная строка может убрать ваш сайт из выдачи или из ответов нейросетей.
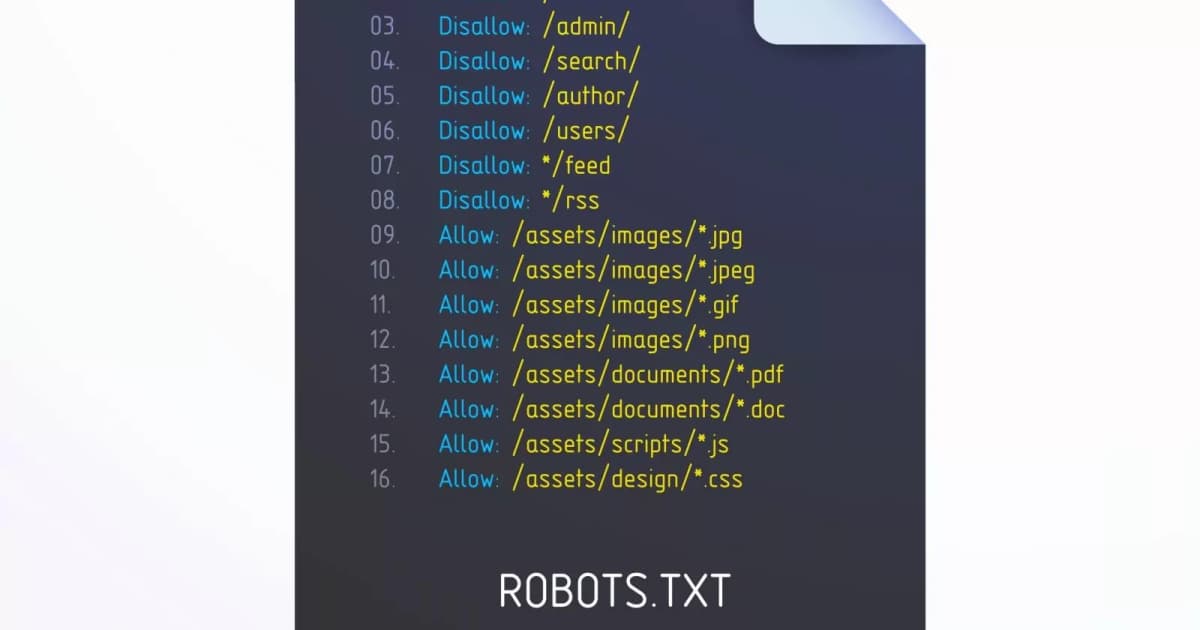
Раньше robots.txt настраивали под Google и Яндекс, теперь в списке гостей появились боты нейросетей, и у каждого свои правила. Закроете не того робота, и материалы пропадут из ответов больших языковых моделей или из поисковой выдачи. Оставите лишнее открытым, и большой сайт растратит краулинговый бюджет впустую.
ИИ-агент (agent) это программа, которая сама ходит по сайтам и выполняет задачу по поручению человека. Большая языковая модель, или LLM, это нейросеть уровня ChatGPT, которая пишет ответы на основе прочитанных текстов. Англоязычное SEO-руководство, на котором основан этот материал, называет главную задачу так: знать, каким правилам следует каждый бот, и закрывать только то, что действительно не нужно.
Что понадобится для настройки?
- Доступ к корневой папке сайта, то есть к самой верхней папке, где лежат главные файлы. Обычно это хостинг или админка CMS (системы управления сайтом, например WordPress).
- Список разделов сайта и ответ на вопрос, зачем каждый раздел нужен поисковику.
- Документация ботов, которых вы хотите пустить или закрыть.
- От 30 минут до часа на небольшой сайт. Магазину с сотнями тысяч страниц понадобится больше.
Пять шагов к robots.txt, который не навредит
-
Найдите файл. robots.txt это простой текстовый файл в корне сайта, адрес выглядит как
site.ru/robots.txt. Он подсказывает краулерам (поисковым роботам, которые обходят страницы), что сканировать. -
Составьте список кандидатов на закрытие. Руководство называет такие разделы:
-
результаты внутреннего поиска;
- страницы фильтров и сортировки (фасетная навигация), если они не входят в вашу SEO-стратегию;
- ссылки-действия вроде «добавить в корзину» и «в избранное»;
- личный кабинет (данные в нём защищайте паролем, robots.txt защитой не служит);
- скрипты отслеживания, которые не влияют на содержимое страницы;
-
боты для обучения ИИ, если вы хотите ограничить их доступ.
-
Закройте внутренний поиск. На WordPress он обычно работает через параметр «s», адрес выглядит как
example.com/?s=google. Правило из руководства:
User-agent: *
Disallow: /*?s=
Disallow: /*?*&s=
Первая строка Disallow ловит «s», когда он стоит первым параметром. Вторая ловит его после другого параметра. Строка User-agent: * задаёт общие правила для всех ботов, у которых нет своей группы.
- Проверьте, какое правило победит. Если для бота написана отдельная группа, он подчиняется ей и игнорирует общую:
User-agent: *
Disallow: /private/

User-agent: Googlebot
Allow: /
Здесь Googlebot спокойно зайдёт в /private/. Чтобы закрыть папку и для него, допишите Disallow: /private/ под строкой Allow: / в его группе.
- Отдельно решите вопрос с ИИ-ботами. Руководство советует разделять три вида доступа: сбор данных для обучения моделей, поиск и обращения по прямому запросу пользователя. Закрыв всё одной строкой, вы рискуете исчезнуть и из ИИ-поиска.
Внутри одной группы Google применяет два принципа. Побеждает самое конкретное правило, то есть совпадающее с большим числом символов адреса. Если два правила одинаково конкретны, Google выбирает менее строгое.
Ввели:
User-agent: *
Disallow: /downloads/
Allow: /downloads/free/
Получили: Google сканирует /downloads/free/, потому что это правило конкретнее, а всё остальное в /downloads/ закрыто. А в руководстве 2024 года есть скриншот статистики сканирования: после закрытия внутреннего поиска робот стал реже обходить несуществующие адреса поиска.
- Регистр. Пути чувствительны к регистру: правило для
/?s=не сработает на/?S=, а «filter=» не равно «Filter=». Названия директив и имена ботов к регистру нечувствительны. - Регулярные выражения. Полноценных регулярок нет. Есть только два символа-заменителя: звёздочка (любое число любых знаков, включая ноль) и знак доллара (конец адреса).
- Ожидание чуда с бюджетом. Google предупреждает: закрытые страницы не передают краулинговый бюджет другим автоматически, если сайт не упирается в предел сканирования.
- Закрыто не значит скрыто. Google может проиндексировать заблокированную страницу, если на неё ведут ссылки.
Что делать с robots.txt прямо сейчас, по ролям
Автору Дзена. Файлом платформы вы не управляете, так что инструкция нужна тем, у кого есть свой сайт или блог на WordPress. Проверьте, не закрыт ли он целиком от нейросетей, иначе ваши тексты не попадут в ИИ-ответы.
Маркетологу. Сверьте правила с SEO-стратегией: фильтры, которые приводят трафик, закрывать нельзя. Отдельной строкой согласуйте с клиентом, пускать ли ИИ-ботов для обучения.
Предпринимателю с интернет-магазином. Корзина, избранное и бесконечные фильтры съедают ресурсы сервера. Гэри Иллис из Google не раз предупреждал, что из-за таких ссылок робот может бесконечно обходить даже несуществующие адреса. Google в 2024 году отдельно напоминал именно про корзину и избранное.
На мой взгляд, самая частая беда российских сайтов в том, что robots.txt написан один раз под Яндекс и забыт. Разобранное руководство описывает логику Google, а у Яндекса для параметров в адресах есть своя директива Clean-param, её стоит сверить со справкой Яндекс Вебмастера. Честная оговорка: robots.txt это просьба, а не замок. Как поведёт себя конкретный ИИ-бот, смотрите в его документации, а не в общих советах.
Начните с одного действия: откройте ваш-сайт.ru/robots.txt и посмотрите, не закрываете ли вы лишнее строкой со звёздочкой. Эти пять минут скажут о судьбе вашего трафика больше, чем любой прогноз про ИИ-поиск.
Разберитесь, как ИИ-поиск видит ваш контент
Практические разборы для авторов и владельцев сайтов: что открыть нейросетям, что закрыть и как не потерять трафик.
Перейти на dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Microsoft выпускает крупнейшее за десятилетие обновление системы ставок: включится само
Microsoft Advertising 18 ноября объявила о запуске новых моделей ставок, по её словам крупнейшем обновлении за десятилетие, и подключает их автоматически, так…
ИИ-поиск как маркетинг: колумнист призвал мерить продажи, а не упоминания в ответах нейросетей
Автор отраслевой колонки о поиске предложил перестать гоняться за цитированием в ответах нейросетей и строить ИИ поиск как маркетинг, пока индустрия тратит…
Проверка микроразметки для ИИ-поиска: разметка должна описывать бизнес, а не страницу
Микроразметка schema.org получает новую работу: не только приносить расширенные сниппеты, но и объяснять ИИ-поиску ваш бизнес, ведь нейросети собирают ответы о…
Комментарии