
Разработчик показал, как локально запустить нейросеть на MacBook с 24 ГБ без облака
Разработчик за полгода собрал голосового помощника для macOS, который сам открывает папки, ищет файлы и читает почту, и дообучил для него большую модель на ноутбуке с 24 ГБ памяти, без облака и подписок.
Автор прошёл весь путь от схемы до дообучения на обычном MacBook. Лучший результат дала не тренировка с нуля, а ремонтный проход длиной около 70 минут.
Помощник не просто отвечает, а выполняет действия: открывает папки, ищет файлы, включает фильмы, читает почту. Главное условие автор поставил себе сам: языковая модель работает на том же Mac. Его опыт пригодится всем, кто ищет, как локально запустить нейросеть и поручить ей настоящие дела, а не только разговор.
Что понадобится для сборки?
- MacBook на Apple Silicon с 24 ГБ общей памяти, которую делят процессор и видеочип.
- Electron, оболочка для настольных приложений, в которой живёт окно помощника.
- Python для «слуха». Он запускает VAD, детектор речи, который замечает, что человек заговорил, и Whisper, нейросеть распознавания речи. Whisper нужен в сборке под MLX, библиотеку для чипов Apple.
- llama.cpp с сервером llama-server, программа для запуска языковых моделей на своём компьютере.
- Модель Gemma 4 26B A4B. В ней 26 млрд параметров, то есть внутренних настроек, из которых состоит модель. Её берут в 4-битной квантизации: веса сжимают, чтобы модель влезла в память, примерно как фото сжимают в архив.
- Qwen-TTS для синтеза речи по эталонной записи голоса.
- Небольшой помощник на Swift, языке программирования Apple. Он отвечает за звук, микрофон и эхо.
- Время. Один проход обучения длится около трёх часов, поэтому автор учит модель ночью.
Как собрать помощника по шагам?
- Разделите систему на процессы. Слух, мозг, голос и системный помощник работают отдельно и обмениваются с окном сообщениями. Если процесс падает, сторож перезапускает его: голос, например, поднимается заново примерно за 7 секунд.
- Научите модель выбирать действие, а не писать ответ. По сути это ИИ-агент, то есть программа, которая сама выполняет действия. На каждую реплику модель возвращает один шаг в фиксированном формате с полями think (рассуждение), tool (инструмент: папки, поиск файлов, видео, почта, браузер, заметки), args (параметры), say (фраза вслух) и next (нужен ли следующий шаг).
- Защитите файлы. Всё, что меняет или удаляет файлы, выполняется только после голосового подтверждения.
- Замерьте модель без дообучения. Автор давал Gemma системный промпт, скрытую инструкцию перед диалогом, примерно на 5 тысяч токенов. Токен здесь означает кусочек слова, которым считает модель. Результат: 89% верных шагов при медиане 1,94 секунды на ответ, но с системными ошибками. Модель путала «поставь» фильм и музыку, забывала параметры и переспрашивала там, где всё ясно.
- Соберите стенд до обучения. Это набор фраз с правильными шагами, на котором модель никогда не учится. У автора в нём 766 разговоров, файл заморожен, и любые две версии сравниваются только на нём.
- Дообучите насадку. LoRA работает как небольшая насадка поверх модели: она меняет поведение, не переписывая все веса. QLoRA делает то же самое на сжатой модели. Автор обучает через mlx-lm, и цель простая: перенести правила из промпта в веса и обойтись коротким промптом.
- Уложитесь в память. Gemma 4 26B устроена как MoE, «смесь экспертов»: на каждом шаге работают около 4 млрд параметров из 26. Пример должен быть не длиннее примерно 1400 токенов, иначе Metal, графическая система Mac, падает от нехватки памяти. Длинные примеры заранее отсекает отдельный скрипт.
- Не давайте Mac уснуть и продолжайте с последней точки. Вся цепочка (обучение, перевод в GGUF, проверка на стенде) идёт под одной командой caffeinate, которая не даёт Mac уснуть. После срыва обучение продолжают с последней сохранённой точки:
caffeinate -i -s <скрипт всей цепочки>
--resume-adapter-file
- Переведите насадку в GGUF, формат файлов для llama.cpp. Для этого автор завёл отдельное окружение с torch, библиотекой для нейросетей. Под Gemma 4 ему понадобились ещё две небольшие правки в mlx-lm.
- Настройте слух. Команды выполняются только после имени помощника, а фильм приглушается уже по началу речи. Если голос громче «плавающего пола», то есть медленного среднего уровня громкости без речи, на 6 дБ и это не эхо самого помощника, звук стихает. Если за 2,5 секунды имя не прозвучало, громкость возвращается.
В версию v4 автор добавил новые разделы: вопросы к документам, чертежи, английский язык, цепочки команд. На них модель выросла, а на старых командах просела: «включи фильм» запускало музыку, «найди фильм» теряло тип поиска, «свою папку» путалось с папкой заметок.
Автор собрал 416 примеров ровно на эти случаи и добавил к ним случайную выборку старых и новых данных, всего около 1100. Затем он доучил v4 ещё примерно на 1000 шагов. Шаг обучения, то есть то, насколько сильно модель меняется за раз, он снизил с 3e-5 до 1,5e-5 и отключил валидацию. Ушло около 70 минут, и получился лучший результат за всё время.
- Проверка по отдельным репликам. У автора из такой проверки выпадало больше 400 примеров с цепочками, и картина получалась слишком радужной.
- Обучение на ошибках стенда с проверкой на нём же. Оценка завышается. Нужен свежий набор, которого не видели ни модель, ни автор примеров.
- Шаги цепочки по отдельности. Однажды Mac уснул после обучения, и проверка растянулась на шесть часов.
- Тяжёлые соседи по памяти. Браузер и индексация Spotlight, поиска по Mac, раздували подкачку на диск до 6 или 7 ГБ. Срывы совпадали с валидацией, которая шла каждые 200 или 400 шагов.
- Правка сценария команд на ходу. Bash читает файл по мере выполнения, и правка уронила цепочку на строке, которой при запуске ещё не было.
- Обучение с нуля. Модель забывает старое, ремонтный проход надёжнее.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Возьмите идею стенда: соберите 20 или 30 своих типовых запросов к нейросети и проверяйте на них каждый новый промпт. Так вы увидите, что правка улучшила, а что сломала.
Маркетологу. Фиксированный формат ответа (действие, параметры, фраза) подходит для любой автоматизации, где нейросеть должна выдавать решение, а не текст. Автор подключает и внешние модели, ChatGPT, Claude, Gemini, в том же формате. В этом режиме локальный сервер останавливается и освобождает около 13 ГБ памяти.
Предпринимателю в РФ и СНГ. Локальная модель не зависит от облака и подписок, но потребует Mac на Apple Silicon с 24 ГБ и человека, который пишет код. Если собирать своё пока рано, из доступных в РФ облачных аналогов есть YandexGPT и GigaChat.
На мой взгляд, главная ценность разбора не в выборе модели, а в стенде и ремонтном проходе. Сам автор называет стенд главным, что он сделал, и я с ним согласен: без замороженной проверки любое дообучение превращается в гадание. Честная оговорка: это проект для тех, кто пишет код, 24 ГБ памяти хватает впритык, а итоговую точность дообученной версии автор в описанной части не называет. Начните с малого: сначала стенд и промпт, насадка потом.
Освойте нейросети на практике
Разбираем, как применять ИИ в работе автора и бизнеса, без лишней теории.
Перейти на dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-агент Claude на VPS банит сам себя в 7 прогонах из 60, отрезая доступ владельцу
Автор открытого навыка vps-forge провёл 120 прогонов Claude Opus 5.5 на виртуальных серверах и показал, что без подсказок агент банит сам себя в 7 прогонах из…
Дашборд Битрикс24 за 20 минут: ИИ-агент собирает загрузку отдела без разработчиков
Руководитель отдела в Битрикс24 теперь может за 20 минут собрать экран загрузки команды через ИИ-агента Коворк/Код, не заводя заявку на разработку и не собирая…
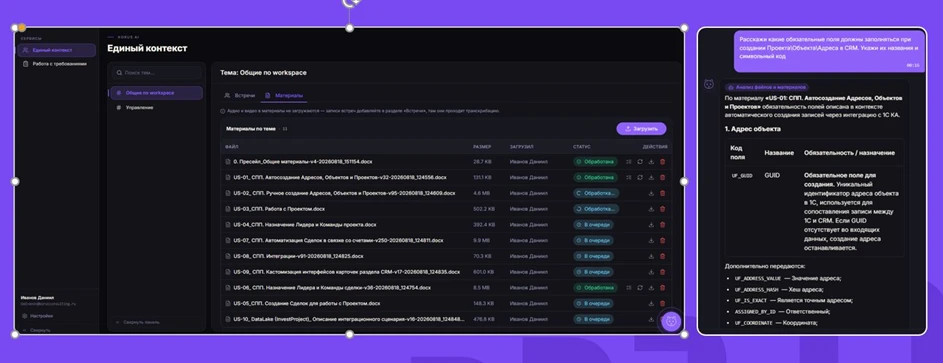
ИИ за два года из помощника аналитика стал инструментом тимлида: протоколы без лотереи
Даниил Иванов, руководитель группы аналитики КОРУСа, спустя два года после первых опытов с ChatGPT показал, как библиотека промптов превращает протокол встречи…
Комментарии