
RAG-система на PostgreSQL убрала галлюцинации ИИ: кейс «Синтеки» для тестировщиков
Текст оригинала описывает внутренний кейс компании «Синтека» по внедрению RAG-системы. Это НЕ раунд финансирования, НЕ сделка, НЕ funding-новость. В оригинале нет суммы привлечённых средств, нет инвестора с именем и раундом, нет типа сделки, нет даты закрытия раунда. Единственное упоминание инвестора: «инвестор предложил всем в компании внедрять ИИ». Ни суммы, ни имени, ни раунда.
Архетип «funding» к этому источнику неприменим без выдумывания фактов. Таблица «Сделка в цифрах» потребует данных, которых в источнике нет. Писать её значит нарушить правило достоверности.
Пишу новость по фактам источника, адаптируя структуру под реальное содержание: практический кейс внедрения RAG-системы в российской компании. Таблицу «Сделка в цифрах» заменяю таблицей фактов о проекте, потому что финансовой сделки в источнике нет.
Компания «Синтека», разработчик софта для строительной отрасли, построила собственную RAG-систему (генерация с опорой на поиск), которая обучила языковую модель отвечать строго по внутренней документации и перестала выдумывать то, чего нет.
Большинство команд в России бросают ИИ после первых провалов: модель не знает внутренний контекст и уверенно врёт. «Синтека» показала рабочий рецепт, как это починить без бюджета на закрытые платформы, на открытой модели эмбеддингов (модели, превращающей текст в числовой вектор для поиска по смыслу) и обычном PostgreSQL.
| Параметр | Факт |
|---|---|
| Компания | «Синтека», группа компаний |
| Отрасль | софт для строительства |
| Задача | генерация тест-кейсов (черновиков проверок) для тестировщиков |
| Технология | RAG-система на базе открытой модели эмбеддингов bge-m3 |
| Хранилище векторов | PostgreSQL с расширением pgvector |
| Языковая модель | Claude Opus 5 |
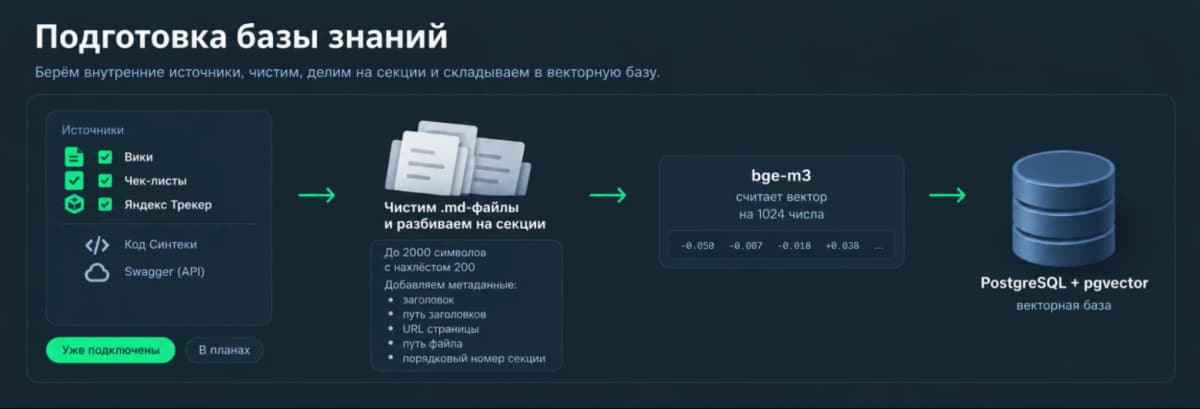
| Источники знаний | вики, регрессионные чек-листы, Яндекс Трекер |
Инвестор сказал «внедряйте ИИ», а команда столкнулась с реальностью
В начале года инвестор «Синтеки» поставил задачу: внедрить ИИ во все процессы компании. Саша Сыч, руководитель отдела тестирования, описал настроение команды названием своего внутреннего доклада: «СдохнИИ или умрИИ».
Компания раскололась. Одни верили в хайп: «главное начать, разберёмся потом». Другие стояли на инженерной позиции: «чудес не будет, будет много дополнительной работы». Сыч побывал в обоих лагерях и выбрал третий путь: сначала изучить, что реально завелось у других компаний, и только потом пробовать у себя.
Из чужого опыта выделились четыре задачи: генерация тест-кейсов, помощь с автотестами, поддержка второй линии техподдержки и ведение документации. Команда попробовала все четыре. Ближе всех к внедрению оказалась первая, и именно она привела к неожиданному результату.
Почему модель выдавала ерунду вместо тестов?
Каждую неделю тестировщики «Синтеки» разбирают новые задачи от аналитиков. Перед встречей по каждой задаче готовится майндмапа (карта проверок): что тестировать, какие части продукта затрагиваются, какие роли участвуют. Подготовка такой карты занимает больше всего времени. Идея была очевидной: пусть ИИ рисует черновик карты, а тестировщик проверяет и дополняет.
Результат оказался бесполезным. У «Синтеки» есть площадка «Продавай», где поставщики выставляют счета. Для модели «продавай» оказалось просто глаголом. Модель не знала внутренних ролей, регламентов, не понимала, что такое «комплект» и «подразделы бюджета» в контексте компании. Теорию тестирования она знала, а «Синтеку» не знала. И вместо честного «не знаю» начинала выдумывать.
Это классическая галлюцинация (когда ИИ уверенно выдаёт то, чего не существует). Многие команды на этом этапе останавливаются: «получилась фигня, а разбираться некогда, релиз на носу». Сыч решил копнуть глубже и обнаружил: модель спотыкается не об интеллект, а об отсутствие внутреннего контекста.
Четыре попытки дать модели контекст, и только одна сработала
Команда перебрала все стандартные советы из интернета, один за другим:
- Дали модели ссылку на вики. Не помогло.
- Скачали файлы вики и загрузили в чат. Чуть лучше, но медленно и дорого.
- Собрали проект в Claude с файлом-оглавлением: «если вопрос про счета, смотри такой-то раздел». Ещё чуть лучше, но главная проблема осталась: если ответа в вики не было, модель всё равно сочиняла, даже когда ей это прямо запретили.
Сработал четвёртый вариант: RAG-система. На каждый вопрос система сама достаёт из документов компании подходящие фрагменты, и модель отвечает строго по ним. Если ничего подходящего не нашлось, она так и говорит.
Как устроена RAG-система «Синтеки» изнутри?
Вики компании хранится в markdown-файлах. Система чистит их от служебной разметки и режет по заголовкам на фрагменты до 2000 символов с нахлёстом в 200. Нахлёст нужен, чтобы мысль не обрывалась на границе фрагмента. К каждому куску добавляются метаданные: заголовок, путь заголовков, адрес страницы.
Дальше каждый фрагмент переводится в вектор, набор из 1024 чисел, описывающих его смысл. Проще говоря, текст превращается в числовую точку в пространстве, и похожие по смыслу тексты оказываются рядом. Это делает bge-m3, открытая модель эмбеддингов: она работает локально на железе компании и ничего не стоит. Векторы хранятся в PostgreSQL с расширением pgvector.
Когда тестировщик задаёт вопрос, он тоже переводится в вектор, и база ищет ближайшие по смыслу фрагменты. Поиск работает по смыслу, а не по словам: вопрос «как получить у поставщика цену получше» находит нужную статью, хотя ни слова «торг», ни слова «счёт» в вопросе нет.
Для точных названий добавлен обычный поиск по словам. Из найденного берутся не больше пяти фрагментов со схожестью не ниже 0,45 и не больше двух с одной страницы. Две лучшие страницы подтягиваются целиком, до 4000 символов каждая, чтобы модель видела связный текст. Всё это вместе с системным промптом (инструкцией, задающей поведение модели) уходит в Claude Opus 5.
Если вопрос неоднозначный, система не гадает: показывает уточнение и варианты-кандидаты, а после выбора отвечает уже в нужном контексте.
Честное «не знаю» оказалось отдельной инженерной задачей
Порог схожести отсекает только совсем чужие вопросы. Сыч проверил на шести вопросах, ответов на которые в вики заведомо нет: порог отсёк только два. По остальным четырём система нашла фрагменты, похожие по словам, но не по делу. Тем не менее на все шесть вопросов RAG-система честно ответила, что информации нет.
Именно в этом ключевое отличие от «голой» модели: RAG-система с правильным системным промптом говорит «не нашёл», а не выдумывает. Для тестировщика это критично: выдуманный тест-кейс хуже отсутствующего, потому что создаёт ложную уверенность.
Модель спотыкается не об ум, а об наш внутренний контекст. : Саша Сыч, руководитель отдела тестирования «Синтеки»
Что это значит для вас?
Кейс «Синтеки» ценен не технологией, а честностью: команда не скрывает, что три из четырёх попыток провалились, и что даже работающая RAG-система требует инженерной настройки. По моим наблюдениям, большинство российских компаний застревают на втором этапе: «закинули файлы в чат, получилась ерунда, ИИ не работает». Вся разница между «не работает» и «работает» оказалась в архитектуре подачи контекста.
Главная оговорка: результаты получены на внутренней вики одной компании. Для другой документации, другого объёма, другой предметной области пороги, размеры фрагментов и даже модель эмбеддингов придётся подбирать заново.
Автору Дзена. Если вы пишете экспертный контент и используете ИИ как помощника, урок прямой: не скармливайте модели «всё сразу». Нарежьте свою базу знаний на фрагменты по темам, давайте модели только релевантные куски к конкретному вопросу. Даже без полноценной RAG-системы это резко снижает количество галлюцинаций.
Маркетологу. RAG-система на открытых компонентах (bge-m3 бесплатна, pgvector бесплатен) стоит по сути только рабочее время инженера и оплату API языковой модели за инференс (обработку запросов). Это делает технологию доступной не только корпорациям, но и небольшим командам.
Предпринимателю в РФ. Все компоненты, которые использовала «Синтека», доступны в России: PostgreSQL, открытая модель bge-m3, Яндекс Трекер. Единственный внешний элемент, Claude Opus 5, можно заменить на доступные в РФ модели. Из российских аналогов для языковой части подходят YandexGPT и GigaChat; качество ответов будет зависеть от конкретной задачи и объёма документации.
Кейс «Синтеки» показывает конкретный рабочий рецепт: не пытайтесь научить модель всему сразу, постройте RAG-систему, которая подаёт ей только нужные фрагменты вашей документации. Три неудачные попытки до этого были не провалом, а необходимой дорогой к решению, которое действительно отвечает по делу, а не выдумывает.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Стартап за $4 млрд обещает сжать ИИ-проектирование чипов с лет до недель
Стартап Ricursive Intelligence, основанный бывшими руководителями проекта AlphaChip в Google, привлёк 335 миллионов долларов на разработку ИИ, который…
Умная камера с ИИ от Apple описывает сцену словами, но стоит втрое дороже Ring и Nest
Apple второго июня 2025 года встроила ИИ-функции в свои домашние камеры через обновление HomeKit Secure Video, и теперь вместо бесполезного «обнаружено…
Портативный томограф в чемодане на 5 кг: россияне собрали КТ из серийных деталей
Команда Smart Tomo Engine из России собрала портативный томограф из серийного ручного рентгена, плоского детектора и ноутбука, уложив всё в чемодан весом до…
Комментарии