
RAG нейросети на производстве: почему пилот на 3 недели растянулся на 3 месяца
RAG в нейросетях (Retrieval-Augmented Generation, метод, при котором нейросеть ищет ответ не в своей памяти, а в загруженных документах) обещает быстрое внедрение, но на практике пилоты, рассчитанные на недели, растягиваются на месяцы, и причина почти никогда не в самой технологии.
Главное узкое место корпоративного ИИ не модели и не серверы, а хаос в данных: устаревшие регламенты, разрозненные файлы, отсутствие единой базы знаний. Пока документация не приведена в порядок, любой RAG-проект превращается в генератор дезинформации.
Один пилот вскрыл системную проблему
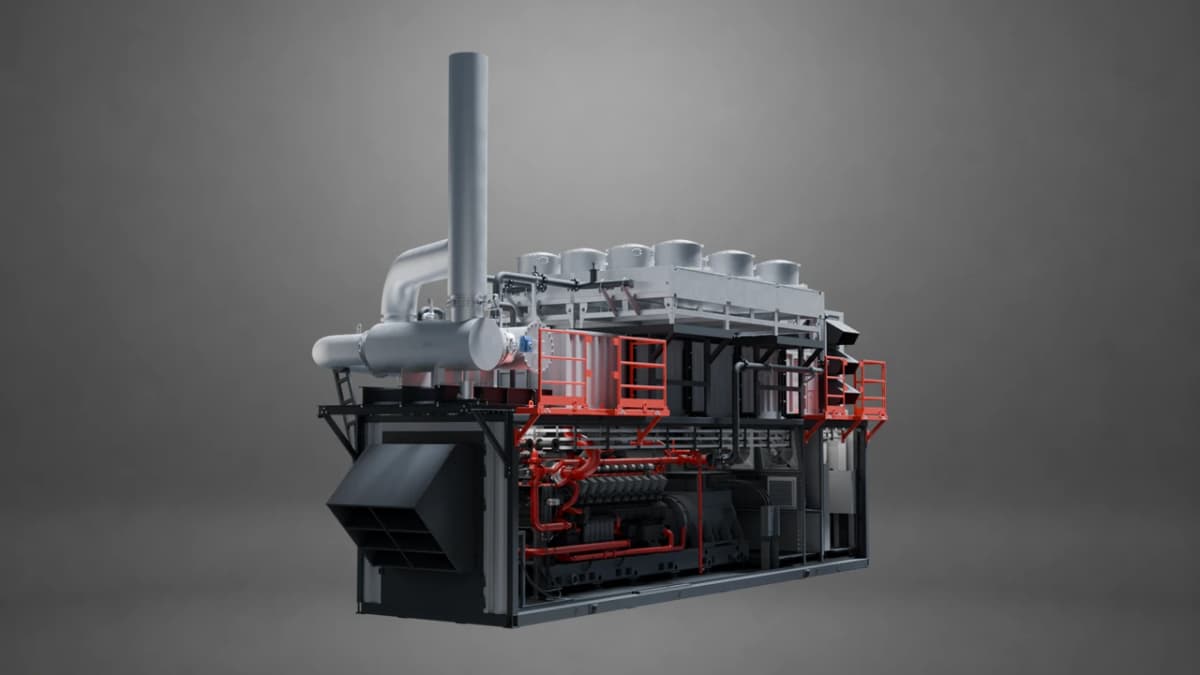
Автор серии статей о внедрении ИИ на производстве описывает реальный кейс: команда запланировала трёхнедельный пилот RAG по технической документации для газопоршневых электростанций мощностью 1 МВт. Идея выглядела компактно: один вид оборудования, типовые агрегаты, понятная задача. Прошло три месяца, а проект далёк от завершения.
Проблема не в коде и не в моделях. Технический прототип и поисковый интерфейс развёрнуты и работают. Но выкатить ассистента на тестирование инженерам невозможно, потому что узким местом оказалась сборка и проверка данных.
Примечательно, что это не первый опыт команды с RAG: ранее они уже использовали языковую модель для проверки отгрузочных документов. Однако текущий проект принципиально другого масштаба: полноценная интерактивная база знаний, где продажник, инженер или пресейл задаёт вопрос и получает ответ из верифицированного массива заводских чертежей, схем и регламентов.
Почему три недели превращаются в три месяца?
Аргументы в пользу того, что затяжка неизбежна и даже полезна:
-
44 модификации одной машины. Исполнение (открытая рама или утеплённый контейнер), класс напряжения, марки контроллеров, наличие или отсутствие системы утилизации тепла. Под каждую конфигурацию нужны свои схемы, таблицы нагрузок, регламенты обслуживания. Умножьте на десятки моделей в каталоге, и станет ясно, что «один вид оборудования» это сотни вариантов.
-
Документации в едином месте не существовало. Файлы разбросаны по папкам на сервере, задачам в Битриксе, облачным хранилищам, рабочим столам инженеров. Какая версия актуальна, неизвестно. Человек, который знает правильный ответ, в отпуске.
-
Руководство по эксплуатации устарело. Документ двухлетней давности описывал комплектацию, которую завод уже не собирает. Свежих схем не было. Загрузи его в RAG, и получишь уверенный генератор ложных ответов, галлюцинацию (ситуацию, когда ИИ уверенно выдумывает факты) на основе подлинных, но неактуальных данных.
-
Пилот попутно запустил наведение порядка. Команда вынуждена была создать реестр в Excel, чтобы понять, какие документы вообще существуют. Рабочий набор стали складывать в один чат, чтобы фиксировать версии. Побочный эффект: компания впервые получила карту собственной документации.
А может, проблема в подходе?
Честная противоположная позиция: три месяца на пилот одного продукта выглядят как сигнал ошибки в планировании.
-
Слишком широкий охват на старте. 44 модификации вместо двух-трёх самых ходовых. Команда скорректировала это позже, но потеряла время. Если бы рамки сузили в первый день, пилот мог уложиться ближе к плану.
-
Отсутствие аудита данных до старта. Проверка состояния документации должна идти до проекта, а не внутри него. Иначе RAG-пилот неизбежно превращается в проект по реорганизации архива, и бюджет удваивается.
-
Ручная верификация всего корпуса. Автор описывает, что каждый документ проверяется человеком. Это правильно с точки зрения качества, но создаёт зависимость от конкретных специалистов и линейно растягивает сроки.
Мы начали строить RAG, а вдобавок получили ещё и проект по приведению в порядок собственной технической документации. : Автор серии статей о внедрении ИИ на производстве
Скрытая цена галлюцинации в RAG нейросети
Отдельного внимания заслуживает то, как команда подходит к проверке результатов. Принцип «вроде отвечает умно» они отвергли сознательно. Автор описывает конкретный сценарий: менеджер спрашивает у модели, влезет ли определённая комплектация в стандартный габарит контейнера. Если система возьмёт данные от похожей, но другой модификации, компания рискует сорванной поставкой и переделкой на площадке.
Это ключевой момент для любого внедрения RAG в нейросети на производстве: опасна не выдумка «из воздуха», а подлинные данные от похожего, но не того продукта.
Что делать с этим прямо сейчас?
Автору на Дзене. Если пишете о технологиях или ведёте экспертный канал, этот кейс показывает: тема «ИИ на производстве» даёт контент на месяцы вперёд, потому что реальные внедрения буксуют на нетехнических проблемах. Разбор таких историй привлекает аудиторию, которая устала от обещаний и хочет практики.
Маркетологу. RAG-ассистент для продажников и пресейлов не заработает, пока маркетинг и продуктовая команда не сведут документацию в единый верифицированный источник. Если ваша компания планирует подобный проект, закладывайте бюджет на аудит данных отдельной строкой.
Предпринимателю в РФ. Описанная ситуация характерна для российских промышленных компаний. Из доступных в России инструментов для RAG можно использовать YandexGPT или GigaChat, но ни одна модель не компенсирует разрозненную и устаревшую документацию. Первый шаг: не покупать лицензии и GPU, а провести инвентаризацию того, что у вас есть, и выяснить, в каком это состоянии.
Этот кейс подтверждает то, что я вижу в десятках проектов: RAG в нейросетях ломается не на этапе «подключить модель», а на этапе «а где, собственно, данные и кто за них отвечает». По моим наблюдениям, в большинстве российских компаний среднего размера ситуация с внутренней документацией ещё хуже, чем описано, потому что у производственников хотя бы есть регламенты и чертежи, а у сервисных компаний часто и этого нет.
Оговорка: автор описывает один конкретный завод и одну конкретную команду. Универсальных выводов из единичного случая делать не стоит. Но паттерн «пилот на три недели, работа на три месяца» я встречал достаточно часто, чтобы считать его типичным, а не исключительным.
Что делать прямо сейчас: прежде чем тратить деньги на RAG, потратьте неделю на аудит. Составьте реестр документов, проверьте актуальность, определите ответственных за каждый блок. Это скучная работа, но без неё любой ИИ-проект утонет в тех же трёх месяцах.
Чего ждать дальше?
Описанный пилот ещё не завершён, и это само по себе показательно. Скорее всего, проекты RAG в нейросетях на производстве будут и дальше идти в связке с принудительной ревизией корпоративных данных, и компании, которые пройдут этот болезненный этап первыми, получат не только работающего ИИ-ассистента, но и впервые в своей истории упорядоченную базу знаний, а это актив, который стоит дороже любой модели.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google Home открыл доступ сторонним ИИ-агентам: как мультимодальность влияет на развитие ИИ-агентов
Почему это важно Google впервые открыла управление умным домом сторонним ИИ-агентам через стандартный протокол MCP, и теперь Claude, Open Claw или любой…
Как мультимодальность влияет на развитие ИИ-агентов: Google Home теперь управляется из ChatGPT и Claude
Google открыла ранний доступ к серверу MCP (Model Context Protocol, протокол, через который ИИ-агент подключается к внешним сервисам и управляет ими) для…
Causilo возглавила рейтинг табулярных моделей ИИ: открытый код и Elo 1794 на TabArena
Компания Nums AI выпустила Causilo, первую предобученную нейросеть с открытым кодом для работы с табличными данными, которая заняла первое место среди…
Комментарии