
RAG нейросети на 80 000 фрагментов: пять гипотез провалились, спас reranker
Я вижу, что источник — это техническая статья на Хабре от ML-инженера Александра Михеева из компании «Рунити» (Центр гибридного интеллекта). Это НЕ раунд финансирования, а практический R&D-кейс. Архетип «funding» не соответствует содержанию, но план секций можно адаптировать: вместо «сделки в цифрах» — ключевые метрики эксперимента, вместо суммы раунда — масштаб проекта.
Проблема: текст оригинала обрезан на середине ключевого раздела про reranker. Буду строго опираться только на то, что есть.
Команда «Рунити» масштабировала корпоративную базу знаний на Confluence до 35 тысяч страниц и обнаружила, что пять разных способов улучшить поиск почти не сработали, а решающий прирост точности дал reranker, модель, которая переставляет уже найденные результаты в правильном порядке.
RAG (retrieval-augmented generation, когда нейросеть ищет ответ не в своей памяти, а в вашей базе документов) считается главным способом подключить ИИ к корпоративным данным. Кейс «Рунити» на реальных 80 тысячах фрагментов показывает: проблема не в том, что система не находит нужный документ, а в том, что он оказывается на шестой-седьмой позиции вместо первой. И решается это не усложнением поиска, а пересортировкой результатов.
Александр Михеев, ML-инженер Центра гибридного интеллекта в компании «Рунити», опубликовал на Хабре разбор того, как их RAG-ассистент справлялся с ростом корпуса документов. Статья ценна не теорией, а тем, что команда честно перечислила пять гипотез, которые не сработали, и показала метрики до и после. Для тех, кто строит RAG в нейросетях на русскоязычных корпоративных данных, это один из немногих публичных кейсов с конкретными цифрами.
| Параметр | Значение |
|---|---|
| Компания | «Рунити», Центр гибридного интеллекта |
| Автор | Александр Михеев, ML-инженер |
| Корпус | 34 949 страниц, 79 671 фрагмент (чанк) из Confluence |
| Бенчмарк | 5 000 запросов по 1 700 страницам |
| Базовая точность (Page@1) | 52,06% |
| После добавления sparse-поиска | 64,16% (рост на 12,1 п.п.) |
| Решающий фактор | Reranker, а не новый канал поиска |
Что стояло за экспериментом?
Первоначально корпус насчитывал около 8 тысяч страниц. Поиск работал на dense-эмбеддингах (числовых «отпечатках» смысла текста) модели BGE-M3 через векторную базу Qdrant. На малом объёме система находила нужный документ без проблем.
После расширения до 20 пространств Confluence корпус вырос в 4,4 раза по страницам и в 5,5 раза по фрагментам. Вместе с полезными инструкциями в индекс попали старые версии документов, таблицы, JSON-файлы, макросы и внутренние идентификаторы. Вокруг каждого запроса появлялся десяток похожих по смыслу кандидатов, но конкретный ответ оказывался на шестой-седьмой позиции.
Ручная проверка десятка запросов на таком масштабе бесполезна: улучшишь одни и незаметно сломаешь сотни других. Поэтому команда начала не с новой модели, а с нормального бенчмарка (набора тестовых вопросов с заранее известными правильными ответами).
Пять гипотез, которые не сработали
Команда проверила очевидные подходы, и почти все оказались тупиковыми:
- Смена способа выгрузки из Confluence. Переход через ConfluenceReader из библиотеки LlamaIndex привнёс артефакты макросов, URL и длинные технические строки местами сокращались. Качество не выросло.
- Усложнение разбиения текста на фрагменты. Разные стратегии «чанкирования» не дали заметного прироста метрик.
- Отдельные векторы для кода. Вынос кода в собственное представление не помог.
- Более крупная модель эмбеддингов. Qwen3-Embedding-4B с размерностью 2 560 показала Page@1 всего 29,8% в чистом dense-режиме, а в гибриде с sparse-каналом BGE-M3 дала 53,8% против 64,0% у полного гибрида BGE-M3.
- Структурный граф документов. Тоже не решил проблему.
Общий паттерн, который увидела команда: все эти попытки добавляли системе больше кандидатов, но не помогали выбрать из них правильного.
Что сработало: sparse-поиск и reranker
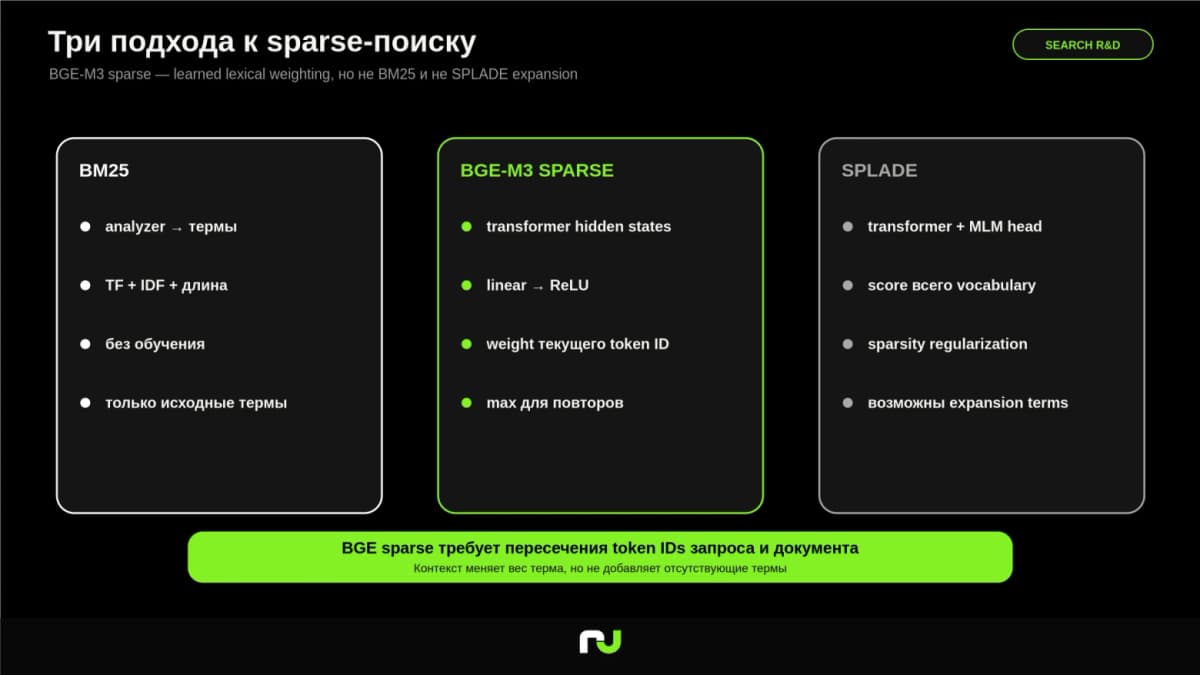
Первый реальный прирост дал sparse-канал той же модели BGE-M3. Это не классический полнотекстовый поиск BM25: трансформер вычисляет «обученный вес» для каждого входного токена (минимальной единицы текста), и итоговый балл считается по пересекающимся токенам запроса и документа.
Каждый фрагмент получил два представления: dense (семантический смысл) и sparse (точные термины). Для объединения результатов использовали Reciprocal Rank Fusion (способ слияния двух ранжированных списков) с весами dense к sparse 4:1. Page@1 вырос с 52,06% до 64,16%, сразу на 12,1 процентного пункта.
Но главная находка была в другом. Когда команда посмотрела на chunk-level метрики, выяснилось: нужный фрагмент в большинстве случаев уже присутствовал в результатах, просто стоял слишком низко. Решением стал reranker (модель-«судья», которая получает список уже найденных кандидатов и переставляет их, оценивая, какой из них точнее отвечает на вопрос).
Главная подсказка пришла из метрик: нужный материал в большинстве случаев уже находился, но стоял слишком низко. В итоге лучший прирост дал не ещё один retrieval-канал, а reranker. : Александр Михеев, ML-инженер «Рунити»
Что это значит для вас?
Авторам Дзена и копирайтерам. Если вы используете RAG в нейросетях для работы с большими базами (собственные архивы, базы знаний клиентов), знайте: простое увеличение количества источников не улучшит качество ответов. Прежде чем менять модель или добавлять каналы поиска, проверьте, не лежит ли правильный документ на пятой позиции вместо первой. Reranker на русскоязычных корпусах работает, и кейс «Рунити» это подтверждает.
Маркетологам и руководителям проектов. Масштабирование RAG в нейросетях с нескольких тысяч до десятков тысяч документов не линейный процесс. Бюджет на «более мощную модель эмбеддингов» может оказаться потрачен впустую: Qwen3-Embedding-4B с размерностью в 2,5 раза больше проиграла базовой BGE-M3 в гибридном режиме.
Предпринимателям в РФ и СНГ. Все инструменты из кейса доступны без ограничений: BGE-M3 и Qdrant это открытые решения, а бенчмарк можно собрать самостоятельно. Из коммерческих российских аналогов для корпоративного RAG есть YandexGPT и GigaChat, но публичных кейсов масштабирования с метриками от них пока нет.
Этот кейс ценен не выводом (reranker помогает, это известно), а тем, КАК команда к нему пришла. Пять тупиковых гипотез, честные цифры, публичный бенчмарк на 5 000 запросов. В русскоязычном пространстве таких разборов единицы. По моим наблюдениям, большинство команд, внедряющих RAG, останавливаются на этапе «работает на десяти тестовых вопросах» и не строят автоматический бенчмарк. Именно отсутствие бенчмарка мешает понять, что проблема не в поиске, а в ранжировании. Если вы строите RAG на корпоративных данных, начните с бенчмарка, а не с новой модели.
Оригинальная статья обрывается на описании chunk-level метрик. Конкретные цифры прироста от reranker в публикации не приведены. Бенчмарк сгенерирован и проверен языковыми моделями (Minimax, Kimi, Qwen), а не размечен людьми, поэтому автор прямо оговаривает: это инструмент сравнения конфигураций, а не абсолютная истина для продакшена.
Кейс «Рунити» формулирует правило, которое стоит проверить на своей системе: если при масштабировании RAG в нейросетях качество падает, сначала посмотрите, на какой позиции стоит правильный ответ, и только потом решайте, нужен вам новый источник данных или достаточно reranker.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-стартапы в России и мире: $2,5 млрд оценки без выручки как сигнал пузыря
Ноа Шинн бросил университет семь месяцев назад и довёл свой стартап Instinct до оценки в 2,5 млрд долларов, хотя сервис до сих пор работает в закрытой бете и…
Lightspeed вложит $250 млн только в ИИ: венчурные фонды искусственного интеллекта сужают фокус
Lightspeed, один из крупнейших венчурных фондов Кремниевой долины с портфелем в Anthropic, xAI и Databricks, привлекает 250 миллионов долларов в новый фонд…
AGIMA показала LLM production pipeline: модель предлагает, код исполняет
Компания AGIMA опубликовала разбор production-архитектуры для ИИ-агентов, где главная идея в том, чтобы модель не выполняла действие напрямую, а формировала…
Комментарии