
RAG, LLM и RandomForest на одной видеокарте выдают торговый сигнал с доказательствами
Разработчик новостного скрапера по российским акциям научил систему выдавать торговые сигналы с доказательствами, когда база выросла до 37 тысяч статей и обрабатывать всё подряд стало слишком дорого.
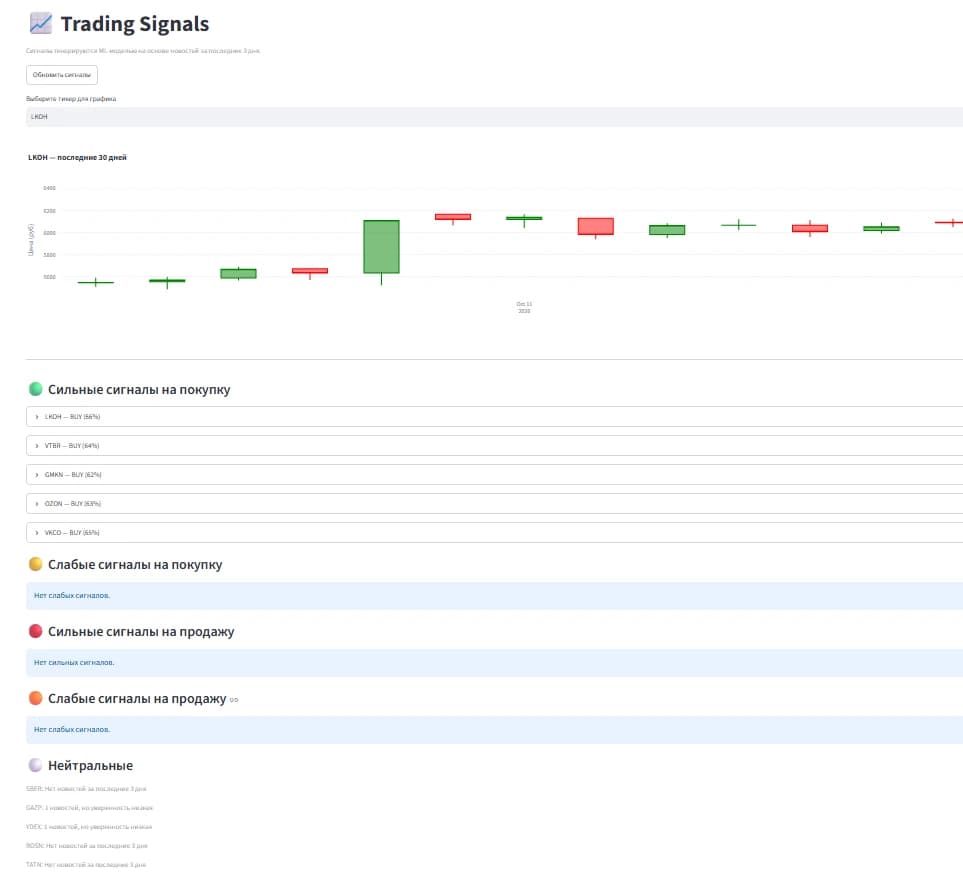
Система больше не только читает новости. Она привязывает их к тикерам Мосбиржи и превращает в сигнал «покупать, продавать или ждать». Всё это работает на одной видеокарте и учитывает русские особенности, вроде «Альфа-банка», которого нет на бирже.
В первой части цикла автор собрал RAG-систему (ИИ, который сначала ищет нужные документы в базе и только потом отвечает) с ИИ-агентом на LangGraph и локальных LLM. LLM расшифровывается как large language model, то есть большая языковая модель, вроде той, что стоит за чат-ботами. Вторая часть, «Как я скрестил RAG, LLM и RandomForest: архитектура торгового сигнала с доказательствами», описывает следующий шаг: от чтения новостей к предсказанию.
На выходе система выдаёт сигналы BUY, SELL или NEUTRAL (покупать, продавать, нейтрально). К каждому сигналу прилагаются доказательства, которые показывает Explainable UI, то есть интерфейс с объяснением, почему модель так решила.
Что понадобится для повторения?
- Стек автора: Scikit-learn, Plotly, FastAPI, Streamlit, PostgreSQL, Ollama. Ollama нужна, чтобы запускать языковые модели на своём компьютере.
- Видеокарта с 16 ГБ видеопамяти (VRAM). У автора Tesla P100.
- Две модели в памяти одновременно: Qwen 14B для текста и BGE-M3 для эмбеддингов. Эмбеддинг переводит смысл текста в набор чисел, по которому удобно искать похожее.
- Доступ к API Мосбиржи для словаря тикеров.
- Новостная база. У автора 37 268 статей из 24 источников.
Пошаговая инструкция: от заголовка новости до сигнала
- Соберите единый конвейер. Раньше классификация, NER и обогащение шли тремя независимыми фоновыми задачами. Они мешали друг другу и по очереди грузили модели в видеопамять. Теперь каждая статья проходит одну цепочку: классификация, фильтр мусора, оценка влияния на рынок, NER, краткое изложение, эмбеддинг. NER означает извлечение сущностей: модель находит в тексте названия компаний.
- Отсекайте нерыночные новости. Спорт, культура и происшествия получают пометку
skipped, и на них не тратятся ресурсы видеокарты. По словам автора, именно этот переход от «обрабатываем всё» к «обрабатываем только важное» позволил добавить ML-сигналы без взрыва нагрузки. - Привяжите компании к тикерам. NER находит «Сбер» или «Лукойл», но не знает, что на бирже это SBER и LKOH. Эту задачу решает Entity Linking, то есть сопоставление названия с биржевым кодом. Для неё автор завёл словарь синонимов
tickers.yaml, который сам пополняется из API Мосбиржи. Сейчас новости привязываются к 50+ ликвидным акциям. - Посчитайте признаки за каждый день и тикер. Признаки здесь означают числа, по которым модель учится:
market_pressure, сумма направлений новостей: плюс 1 за позитивную для акции, минус 1 за негативную;news_count, число новостей;has_summary, делалось ли краткое изложение, это косвенный признак важности новости;vol_5dиvol_20d, волатильность, то есть насколько сильно скачет цена;adv_20d, средний объём торгов за 20 дней.- Заложите аномальный объём. Если дневной объём торгов втрое и больше превышает средний, это часто предшествует движению цены. Признак
volume_ratioуже встроен в архитектуру, но на истории его пока не проверяли. - Обучите RandomForest и настройте Ollama. RandomForest, или «случайный лес», это классический алгоритм, который принимает решение голосованием множества простых деревьев решений. Настройки Ollama, на которых остановился автор:
OLLAMA_MAX_LOADED_MODELS=2
OLLAMA_NUM_PARALLEL=6
OLLAMA_KEEP_ALIVE=-1
CUDA_VISIBLE_DEVICES=0
Значение 6 подобрали опытным путём. При 8 параллельных запросах видеокарта упиралась в потолок памяти, и запросы обрывались по таймауту.
Сначала новости про «Альфа-банк» привязывались к тикеру SVCB, то есть к Совкомбанку. Разбор показал, что NER корректно нашёл в тексте оба банка. Ошибка была в другом: в словаре просто не оказалось Альфа-банка. Автор добавил фиктивный тикер ALFAMOCK. Новости о банке копятся уже сейчас, а когда он выйдет на биржу, заглушку заменят реальным тикером. В западных разборах такого кейса не найти.
Не усложняйте модель на малых данных. Автор ввёл затухание по времени, чтобы свежие новости весили больше. Давление рынка стало дробным, например 0,85 вместо 1, и точность (accuracy, доля верных прогнозов) упала с 0,52 до 0,36. На 55 записях это добавило шум, а не сигнал. Внедрение отложили до 200+ записей.
Не раскидывайте модели по двум картам. Когда модели не хватает 16 ГБ, Ollama делит её слои между видеокартами. Данные начинают ходить по шине PCIe, которая соединяет карты с материнской платой, и скорость падает от 3 до 5 раз. Поэтому автор работает на одной карте из двух и держит запас около 6,3 ГБ памяти.
После настройки пайплайн ускорился от 1,5 до 2 раз, и система стабильно работает на одной карте. Автор отдельно признаёт, что выборка пока мала. Поэтому цифры точности здесь говорят о методе, а не о готовой торговой стратегии.
Что делать с этим прямо сейчас, по ролям
Автору Дзена про финансы: забирайте сам принцип «сигнал плюс доказательство». Разбор акции, где каждый вывод подкреплён конкретными новостями, вызывает больше доверия, чем голое «покупайте».
Маркетологу: фильтр мусора до дорогой обработки годится для мониторинга упоминаний бренда. Сначала отсеять нерелевантное, потом тратить ресурсы на анализ оставшегося.
Предпринимателю в РФ и СНГ: весь стек работает локально и не зависит от зарубежных облаков. Если нужен облачный вариант для текстовой части, из доступных в РФ есть YandexGPT и GigaChat.
На мой взгляд, главная ценность проекта не в сигнале, а в дисциплине. Автор режет нагрузку, не трогает вторую видеокарту без нужды и откладывает красивые идеи, пока не накопятся данные.
Честная оговорка: точность 0,52 на 55 записях почти не отличается от подброшенной монетки. Используйте такую систему как помощника для чтения новостного фона, а не как кнопку «заработать». Торговать по ней живыми деньгами я бы не стал, пока выборка не вырастет хотя бы до тех 200 записей, о которых пишет сам автор.
Хотите собрать свою ИИ-систему без лишних трат?
На dzen.guru разбираем нейросети на практике: что запускать локально, что брать в облаке и как применять это в контенте.
Перейти на dzen.guruНачните с самого дешёвого шага, фильтра мусора. Он один экономит больше ресурсов видеокарты, чем любая тонкая настройка модели.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Экс-техдиректор Rockstar: неофициальный ИИ-порт GTA 6 может ускорить версию для ПК
Бывший технический директор Rockstar Обби Вермей накануне скорого релиза GTA 6 заявил, что угроза неофициального ИИ-порта на ПК может заставить студию быстрее…
ИИ-обвязка рабочего места аналитика: 14 бизнес-требований за 8 дней вместо двух недель
Архитектор ИИ-систем Николай Карпов показал рабочее место аналитика, на котором после обновления регуляторных источников 14 бизнес-требований к платёжному…
Muse от Meta собирает мини-приложения по описанию, а Meta AI научится помнить контекст
Meta открыла всем пользователям приложения Muse функцию «пространства», в которой ИИ-ассистент по одному описанию собирает мини-приложение под задачу и сам…
Комментарии