
Qwen3.8 от Alibaba активирует 6 из 180 млрд параметров: обучение дешевле в 9 раз
Alibaba Qwen выпустила Qwen3.8-Flash-Next, открытую мультимодальную модель на 180 миллиардов параметров, которая активирует при обработке каждого токена (минимальной единицы текста) всего 6 миллиардов, что, по данным разработчиков, сократило стоимость обучения примерно в 9 раз.
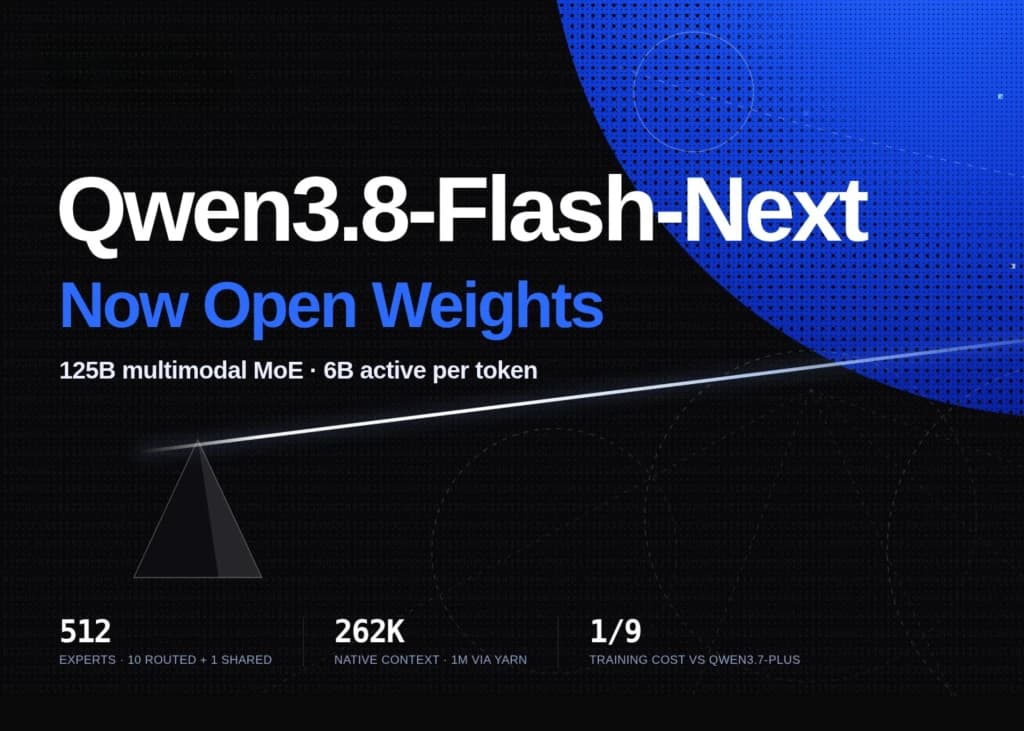
Qwen Alibaba показала, как архитектура MoE (Mixture-of-Experts, смесь экспертов, когда модель использует лишь малую часть своих «мозгов» на каждый запрос) позволяет получить результаты уровня топовых закрытых моделей при радикально меньших затратах на обучение. Для команд с ограниченным бюджетом на GPU это прямой путь к работе с большими моделями.
Модель опубликована командой Qwen Alibaba как предварительная версия архитектуры, которая ляжет в основу будущего поколения Qwen4. По информации Marktechpost, Qwen3.8-Flash-Next повторяет роль, которую ранее сыграла Qwen3-Next для линейки Qwen3.5: публичный тест новых решений перед основным релизом. Лицензия не Apache-2.0, а qwen-community-1.0, и перед коммерческим использованием её условия нужно проверить отдельно.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Qwen3.8-Flash-Next, открытая мультимодальная MoE-модель (открытые веса) | Июль 2025 (точную дату разработчик не назвал) | Команда Qwen, Alibaba | Открытые веса, лицензия qwen-community-1.0 (не Apache-2.0) |
Четыре архитектурных решения, которые отличают модель
- Гибридное внимание GDN + QSA. Три из каждых четырёх слоёв используют Gated DeltaNet, линейный слой внимания, который сжимает историю контекста в компактное состояние фиксированного размера. Четвёртый слой работает на Qwen Sparse Attention (QSA), выбирая контекст не по отдельным токенам, а блоками. Всего 48 слоёв, 12 повторяющихся блоков по схеме «3 GDN + 1 QSA». По данным Qwen, ядро QSA ускоряет обработку входного контекста (prefill) до 7,6 раза и декодирование до 4,9 раза на миллионе токенов.
- Gated Residual. Остаточный поток расширен до 4 параллельных веток с поэлементным чтением и побранчевой записью. Ранг узкого места составляет 320.
- N-gram Embedding. Таблица из 20 миллионов биграмм и триграмм на втором слое добавляет ёмкость через детерминированные подстановки. Таблицу можно выгрузить в оперативную память хоста с асинхронной предзагрузкой, но пока эта функция работает только на устройствах NVIDIA.
- Оптимизатор Muon. Применяется вместе с AdamW к определённым категориям весов. Прогрев размера батча убран, законы масштабирования пересчитаны.
MoE-слой содержит 512 экспертов. На каждый токен активируются 10 маршрутизируемых плюс 1 общий при промежуточной размерности эксперта 640.
Бенчмарки: где модель сильна, а где уступает?
По данным команды Qwen, модель набирает 91,9 на LiveCodeBench v6, 81,0 на SWE-bench Multilingual, 62,5 на SWE-bench Pro. В агентных задачах (где ИИ-агент самостоятельно выполняет цепочку действий): 73,9 на CoWorkBench, 73,5 на Toolathlon Verified. Мультимодальные результаты: 84,5 на AndroidWorld, 95,7 на MathVision с интерпретатором кода.
При этом модель не лидирует везде. Claude Opus 4.6 (Max) обходит её на бенчмарке HLE: 40,0 против 35,9. DeepSeek-V4-Flash-0731 ведёт на NL2Repo-Bench: 54,2 против 48,1. Фронтирное рассуждение (frontier reasoning) остаётся слабым местом.
Все цифры приведены командой Qwen и пока не подтверждены независимыми измерениями.
Контекст 262 тысячи токенов и требования к железу
Нативное контекстное окно (сколько текста модель «видит» за один раз) составляет 262 144 токена с возможностью расширения до 1 000 000 через метод YaRN. По данным Qwen, при 90%-м попадании в кеш префиксов пропускная способность на входе в 8,6 раза выше, чем у Qwen3.7-Plus.
Контрольная точка в формате FP8 весит 172,78 ГиБ, в BF16 составляет 335,28 ГиБ. Это означает, что запустить модель на рабочей станции не получится: минимальная валидированная конфигурация для FP8 требует двух GPU (TP2) на узле GB300, рекомендуется четыре (TP4). На узле 8×H200 нужен режим TEP8, обычный TP8 несовместим с 128-битными блоками квантизации.
Как попробовать?
- Через облако. Модель уже работает в режиме «Standard» на платформе QwenWork и совместима с Qwen Code. Режим рассуждения включён по умолчанию (параметр reasoning_effort: xhigh, medium или low).
- Локально, если есть мощный сервер. Модель поддерживается через vLLM, SGLang, TokenSpeed, transformers serve и llama.cpp (для GGUF-квантов). Рекомендуемые настройки для режима рассуждения: temperature 1.0, top_p 0.95. Для режима инструкций: temperature 0.7, top_p 0.80.
- Дообучение. Поддерживается через Unsloth, Swift и LLaMA-Factory.
Сравнение с российскими аналогами
Прямого аналога Qwen3.8-Flash-Next с открытыми весами среди российских моделей нет. YandexGPT и GigaChat от Сбера работают как закрытые модели (доступ только через API), не публикуют веса и не дают возможности локального запуска или дообучения на своих данных.
| Qwen3.8-Flash-Next (Alibaba) | YandexGPT / GigaChat | |
|---|---|---|
| Открытые веса | Да (qwen-community-1.0) | Нет |
| Локальный запуск | Да, но нужен многопроцессорный сервер | Только через API |
| Дообучение на своих данных | Да (Unsloth, Swift, LLaMA-Factory) | Ограниченно (API дообучения у Яндекса) |
| Контекстное окно | 262 тысячи токенов (до 1 миллиона) | До 32 тысяч (YandexGPT) |
Для российских разработчиков и предпринимателей, у которых есть доступ к GPU-серверам, модель Qwen Alibaba позволяет работать с большими моделями без зависимости от API и без передачи данных наружу.
Кому это полезно и что делать прямо сейчас?
Автору Дзена и копирайтеру. Попробовать QwenWork в режиме «Standard» для генерации черновиков. Режим рассуждения помогает модели давать более продуманные ответы, но потребляет больше токенов, поэтому стоит начать с reasoning_effort: low.
Маркетологу. Если вы работаете с мультимодальным контентом (текст + изображения + код), эта модель закрывает все три задачи в одном инструменте. Но результаты бенчмарков ещё не подтверждены независимо, для продакшен-задач пока рискованно.
Разработчику и предпринимателю в РФ. Снижение стоимости обучения в 9 раз (по данным Qwen) при архитектуре MoE с активацией 6 миллиардов параметров из 180 миллиардов делает эксперименты с большими моделями доступнее. Но нужен сервер с несколькими GPU уровня H200 или GB300. Перед коммерческим использованием обязательно проверьте лицензию qwen-community-1.0.
Qwen Alibaba продолжает выдавать открытые модели, которые по бенчмаркам подбираются к уровню Claude и GPT. Архитектура с активацией 6 миллиардов параметров из 180 выглядит как реальный способ снизить порог входа для тех, у кого нет бюджета OpenAI. По моим наблюдениям, для русскоязычных задач модели Qwen пока уступают GPT-4o и Claude в качестве стилистики, но в кодовых и агентных сценариях работают сопоставимо. Оговорка: все бенчмарки самодекларированные, независимых замеров нет. Рекомендую сегодня зайти на QwenWork, протестировать на своих типовых промптах и сравнить с тем, чем вы пользуетесь сейчас. Потратите полчаса, зато поймёте, стоит ли копать глубже.
Частые вопросы
Можно ли запустить Qwen3.8-Flash-Next на обычном компьютере?
Нет. Контрольная точка FP8 весит почти 173 ГиБ. Нужен сервер с несколькими GPU уровня H200 или GB300. Для знакомства с моделью проще начать через QwenWork в браузере.
Чем отличается от предыдущей Qwen3.7-Plus?
По данным команды Qwen, стоимость обучения снижена примерно в 9 раз за счёт MoE-архитектуры с активацией лишь 6 миллиардов параметров на токен. Добавлены четыре новых архитектурных решения: гибридное внимание GDN + QSA, Gated Residual, N-gram Embedding и оптимизатор Muon. Контекст расширен до 262 тысяч токенов нативно.
Лицензия позволяет коммерческое использование?
Модель выпущена под лицензией qwen-community-1.0, а не под привычной Apache-2.0. Команда Qwen рекомендует проверить условия перед использованием в коммерческих проектах. Точные ограничения изложены в карточке модели на Hugging Face.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Gemini создаёт и правит документы прямо в чате: копировать в редактор не нужно
Google открыла в приложении Gemini создание, просмотр и правку документов, презентаций, таблиц и других файлов прямо в окне чата, причём сразу для всех…
Microsoft Research: ИИ-агенты буксуют в чужом коде, ForkPilot срезает до 59% вычислений
Microsoft Research теперь выпускает дайджест Research Focus не только в LinkedIn, но и на YouTube и в подкастах, а свежий выпуск показывает, что ИИ-агентам…
Разведка США год следила за топ-менеджером Megaspeed: под подозрением контакты главы Nvidia
Разведка США около года следила за Элис Хуан, топ-менеджером сингапурской Megaspeed, подозревая, что она могла собирать для Китая сведения о планах Nvidia и её…
Комментарии