
Qwen на двух DGX Spark выдала 117 токенов в секунду: замена Claude Code на своём железе
Разработчик после блокировки аккаунта Claude Code развернул модели с открытыми весами на паре компьютеров DGX Spark и нашёл кандидата на замену: Qwen 3.8 Flash Next обогнала GLM 5.3 Flash по всем замерам.
На двух DGX Spark модель Qwen 3.8 Flash Next нашла и исправила реальный баг, написала регрессионный тест и показала лучшую скорость из четырёх проверенных конфигураций. Для тех, кто работает через Claude Code AI, это проверенный запасной путь, который не зависит от чужого аккаунта.
Автор технического блога продолжает серию заметок о переходе на модели с открытыми весами (open weights). Так называют нейросети, которые можно скачать и запустить на своём компьютере, а не арендовать через чужой сервис. Поводом стала блокировка его аккаунта в Claude Code, ИИ-агенте для программирования. Тесты шли на DGX Spark, отдельном компьютере для запуска нейросетей; автор объединил два таких в кластер.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Запуск GLM 5.3 Flash и Qwen 3.8 Flash Next на кластере из двух DGX Spark | Точную дату источник не называет: GLM автор проверял неделю, Qwen развернул в день публикации | Тесты провёл автор блога, разработчиков моделей источник не называет | Стоимость железа и моделей источник не приводит |
Что нового?
- GLM 5.3 Flash развёрнута по рецепту GLM-5.3-Flash-DGX-Sparks-1104. Автор пишет, что впервые «смакует каждое предложение»: у Qwen и DeepSeek он замечал путаницу в окончаниях, выдуманные слова и смешение языков.
- GLM исправно отмечает выполненные пункты в списке задач (TODO) на уровнях рассуждения high и max. На уровне low она дважды застревала на первом пункте.
- Главный минус GLM: она засоряет контекст, то есть объём текста, который модель держит в памяти за сессию. По наблюдению автора, комментарии занимали 90% вывода в командной строке (Bash).
- GLM зациклилась на первой же задаче и создала 119 копий служебного файла. Автор заметил это только потому, что его плагин показывает вызовы инструментов.
- При контексте от 130 до 150 тысяч токенов GLM путается в собственных действиях. Токен, это кусочек слова, в котором модель считает текст.
- Qwen 3.8 Flash Next запущена в квантизации INT4-AR, то есть в сжатом до 4 бит виде. Рецепт Qwen3.8-Flash-Dual-DGX-Sparks-TensorFold подсказал читатель с ником @Ka463.
- Автор расширил плагин Pi для PhpStorm: добавил удалённые сессии, уведомления в Telegram и инструмент ask_question.
Qwen на двух Spark быстрее всех четырёх конфигураций
Три метрики простыми словами. Генерация (TPS), это скорость печати ответа в токенах за секунду. Prefill, это скорость чтения вашего запроса до начала ответа, а TTFT, время ожидания первого слова.
| Конфигурация | Генерация, токенов в секунду | Prefill, тысяч токенов в секунду | TTFT на 128 тысячах токенов, секунд |
|---|---|---|---|
| GLM, два Spark | от 65 до 72 | от 1,5 до 1,8 | 75 |
| DeepSeek, два Spark | от 99 до 109 | от 1,7 до 2,3 | 73 |
| Qwen, один Spark | от 70 до 80 | от 2,3 до 2,5 | 57 |
| Qwen, два Spark | от 97 до 117 | от 3,1 до 3,8 | 39 |
Второй Spark ускорил генерацию Qwen на 34–59%, а prefill на 47–62%. На 256 тысячах токенов Qwen отвечает через 86 секунд, GLM через 154. Удвоения скорости нет: второй компьютер даёт прибавку, но не вдвое.
Методика: по 10 замеров на каждом размере контекста, уникальные промпты без кэша и один прогревочный запрос перед серией. Автор сам оговаривает, что одиночный Spark работал в другой квантизации (NVFP4), поэтому сравнение показывает порядок величин, а не точную разницу.
С Qwen на двух Spark автор поработал мало, минусов он «пока не обнаружил». Цифры сняты на коротких ответах длиной 256 токенов без режима рассуждения, в долгой сессии картина может отличаться.
Есть ли российский аналог?
Российские модели в исходном материале не тестировали, поэтому прямого сравнения скорости нет. Из доступных в РФ аналогов есть YandexGPT и GigaChat. Если вам не нужна модель на собственном железе, начинать стоит с них.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Сюжет «у меня заблокировали сервис, и вот что я собрал взамен» хорошо читается, потому что в нём есть личная история и цифры. Если пишете про ИИ, повторите формат: одна задача, две модели, честные плюсы и минусы.
Маркетологу. Своя модель на своём железе снимает риск внезапной блокировки, но переносит расходы на покупку оборудования. Посчитайте, сколько стоит простой команды, если облачный сервис отключат завтра.
Предпринимателю в РФ и СНГ. Модели с открытыми весами работают локально и не требуют иностранного аккаунта. Прежде чем покупать железо, проверьте, где у вас реальная потребность в коде, а где хватит YandexGPT или GigaChat.
Правило, которое автор добавил в файл с инструкциями для агента после случая с 119 файлами:
Одинаковый результат 3 раза подряд при разных пробах: стоп, переформулировать гипотезу или вернуться к спеке, не запускать четвёртую. : Автор блога, строка из файла AGENTS.md
На мой взгляд, главная ценность этой заметки не в победе Qwen, а в истории со 119 файлами. Агент, оставленный на ночь без присмотра, мог забить диск, и никакая скорость этого не окупит. Оговорка: выводы сделаны за несколько дней работы одного человека. Что сделать сегодня: если вы пользуетесь любым ИИ-агентом, пропишите ему стоп-правило против зацикливания, как в цитате выше.
Частые вопросы
Нужны ли два DGX Spark, чтобы повторить опыт?
Нет. Qwen запускается и на одном Spark, но там генерация медленнее: от 70 до 80 токенов в секунду против 97–117 на двух.
Почему автор не выбрал GLM, если её ответы приятнее читать?
GLM оказалась самой медленной из четырёх конфигураций, засоряет контекст и зацикливается. Для кодинга на постоянной основе автор её пока не берёт.
С чего начать, если хочется уйти от Claude Code AI?
Начните с одной реальной задачи, которую вы уже решали в Claude Code, и дайте её локальной модели. Сравните результат, время и то, сколько раз пришлось вмешаться. Эти три цифры скажут больше любого обзора.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Model ML привлёк 250 млн долларов, чтобы ИИ-агенты делали работу младших банкиров
Лондонский стартап Model ML привлёк 250 млн долларов при оценке 1,5 млрд, более чем втрое больше раунда годичной давности, чтобы ИИ-агенты брали на себя работу…
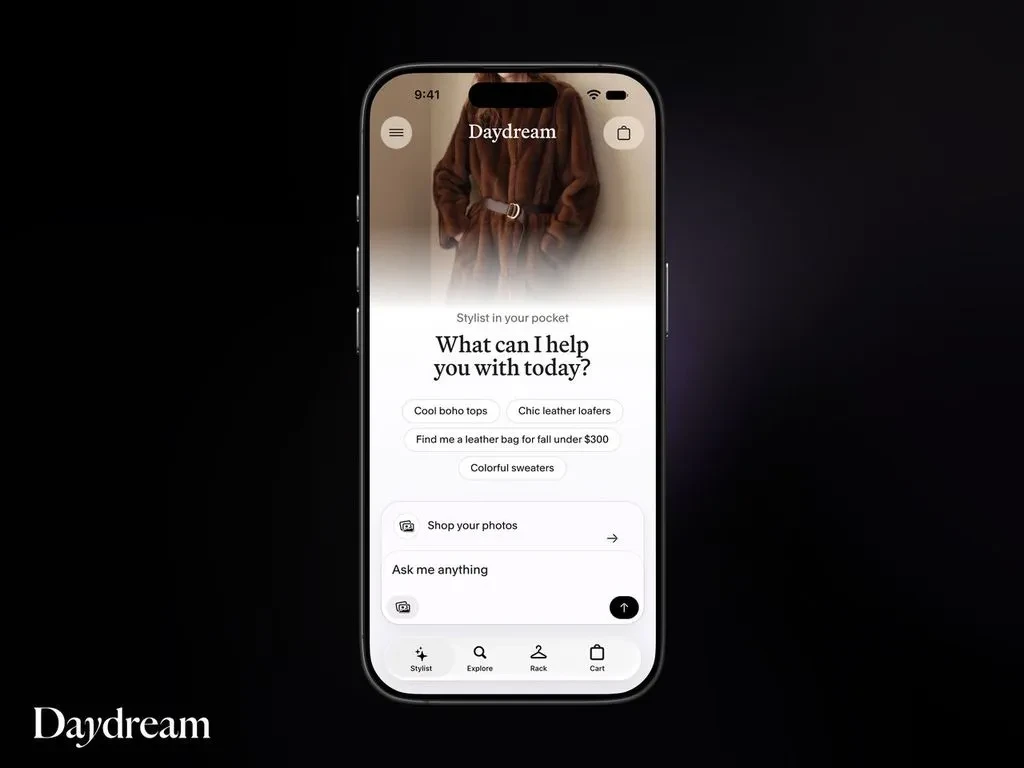
ИИ-стилист с виртуальным гардеробом от Daydream сам покупает вещи из 10 000 брендов
Стартап Daydream во вторник запустил Daydream Agent, ИИ-стилиста с виртуальным гардеробом и примеркой по фото, на фоне слов Meta, что покупки стали одним из…
Что такое ИИ-агент на практике: Pedestal привлёк $4,7 млн и сократил недоставки на 20%
Стартап Pedestal AI во вторник впервые публично заявил о себе и привлёк $4,7 млн на ИИ-агентов для доставки, когда ИИ для цепочек поставок за последние месяцы…
Комментарии