
Qwen модели обошли GPT в SQL-бенчмарке: в 17 раз дешевле и работают на ноутбуке
Qwen 3.8 27B, модель с открытыми весами (open weights) от Alibaba, в агентном SQL-бенчмарке DABstep обошла GPT 5.6 Luna Max от OpenAI при стоимости запуска менее 0,50 доллара против более 8 долларов у конкурента.
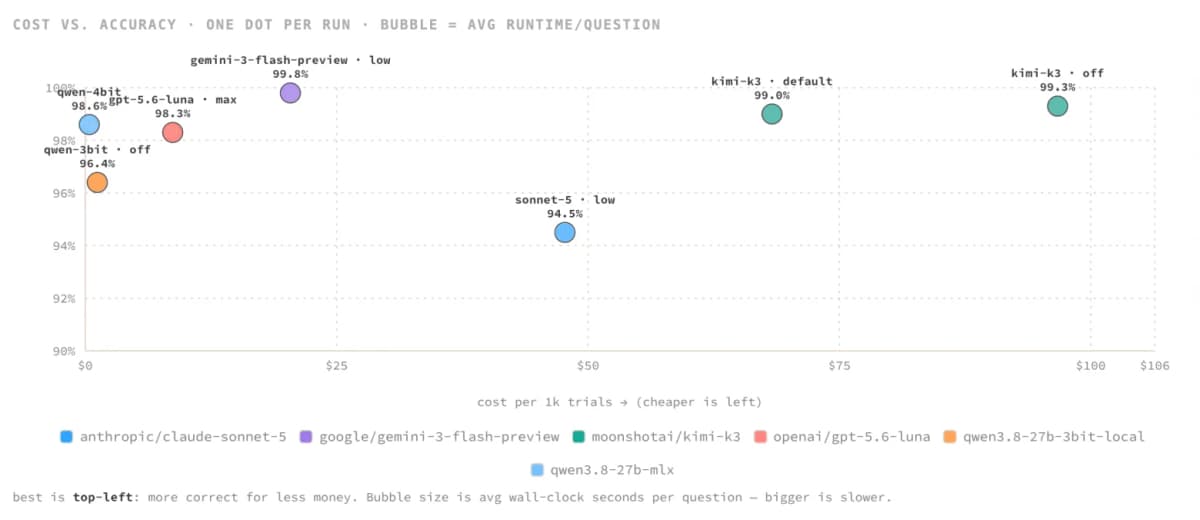
Модель, которая работает локально на ноутбуке с 16 ГБ памяти и тратит электричества как одна лампочка, показала точность выше, чем платная облачная модель с разницей в стоимости больше чем в 17 раз.
До сих пор для серьёзной аналитической работы с данными через SQL нужны были либо дорогие облачные модели, либо мощные серверы. Автор бенчмарка из MotherDuck протестировал Qwen 3.8 27B локально на двух MacBook и сравнил результаты с ведущими закрытыми моделями (closed-source, то есть моделями, код которых недоступен пользователю). Qwen модели этого семейства оказались на графике «точность и стоимость» в зоне, где раньше не было ни одного локального решения.
Что показал бенчмарк DABstep?
DABstep проверяет, как модель отвечает на аналитические вопросы по реальным данным: понимает бизнес-контекст, пишет SQL-запросы и возвращает правильный ответ.
- Qwen 3.8 27B обошла GPT 5.6 Luna Max по точности при стоимости менее 0,50 доллара за прогон (у Luna Max более 8 долларов)
- Gemini-3-Flash осталась самой точной моделью, но стоит в 2,3 раза дороже Luna Max
- Sonnet 5 показал более высокую цену при заметно худшей точности
- Kimi K3, ещё одна модель с открытыми весами, продемонстрировала высокую точность, но дорого обходится через API
Автор бенчмарка отметил, что небольшая доработка промптов (prompt, текстовая инструкция для модели) может ещё сильнее сократить разрыв в качестве между Qwen и лидером.
Что понадобится
- MacBook с 16 ГБ унифицированной памяти (M1 Pro и старше) или 32 ГБ для более комфортной работы. Альтернатива: ПК с дискретной видеокартой на 16 ГБ видеопамяти
- LM Studio для запуска модели локально с OpenAI-совместимым API-эндпоинтом (точкой подключения, через которую программы общаются с моделью)
- Квантованная версия Qwen 3.8 27B (квантование, это сжатие модели с небольшой потерей точности, чтобы она поместилась в память ноутбука)
- DuckDB, встраиваемая база данных для аналитических запросов (работает без сервера, прямо на вашей машине)
- Агентная обвязка: OpenCode или аналогичный инструмент
- Примерно 10 минут на настройку, если следовать инструкции ниже
Пошаговая инструкция
- Скачайте нужную версию модели. Для 32 ГБ памяти берите 4-битную квантованную версию:
Qwen3.8-27B-MLX-4bit
Для 16 ГБ памяти нужна 3-битная, например из семейства unsloth:
IQ3_XXS
-
Установите LM Studio и загрузите в него скачанную модель.
-
Настройте параметры сервера в LM Studio:
Контекст: 16384 токена
MTP (предсказание нескольких токенов): включить, если скачали
Режим рассуждений: low или off
-
Запустите OpenAI-совместимый сервер в LM Studio. После запуска модель будет доступна по локальному адресу, к которому подключается агентная обвязка.
-
Подключите агентную обвязку (OpenCode или вашу собственную) к локальному серверу.
-
Подключите DuckDB к данным и задайте вопрос на естественном языке. Модель сама напишет SQL-запрос и вернёт ответ.
Вы открываете агентную обвязку, подключённую к локальному серверу Qwen, и пишете: «Покажи топ-10 клиентов по выручке за последний квартал из таблицы orders». Модель генерирует SQL-запрос, выполняет его через DuckDB и возвращает таблицу с результатом. Всё происходит на вашем ноутбуке, без отправки данных в облако и без оплаты токенов (token, единица текста, по которой облачные провайдеры считают стоимость). По данным автора бенчмарка, MacBook Air с M5 при этом потребляет около 30 Вт, то есть примерно как одна лампочка.
- Не хватает памяти. Если у вас ровно 16 ГБ, берите только 3-битную версию. 4-битная не поместится и вызовет зависание или аварийное завершение. Автор тестировал 3-битную IQ3_XXS именно на MacBook Pro с M1 Pro и 16 ГБ.
- Режим рассуждений на high. Для SQL-задач в бенчмарке хорошо сработали режимы low или off. Высокий режим замедляет генерацию и не даёт прироста точности в этом типе задач.
- Слишком большой контекст. 16 384 токена хватает для большинства аналитических вопросов. Увеличение контекста сверх необходимого замедляет инференс (inference, процесс генерации ответа моделью) и может привести к нехватке памяти.
- Данные в облаке, модель локально. Если данные лежат на удалённом сервере, вы получите задержку сети. DuckDB работает с локальными файлами, для полной автономности держите данные рядом с моделью.
Что делать с этим прямо сейчас, по ролям
Авторам Дзена и копирайтерам. Qwen модели семейства 3.8 запускаются локально и бесплатно. Если вы работаете с таблицами, аналитикой для статей или собираете данные для материалов, можно задавать вопросы на русском языке и получать ответы без подписок. Из доступных в РФ облачных аналогов для SQL-задач можно попробовать YandexGPT, но он пока уступает Qwen 3.8 27B по результатам агентных бенчмарков (прямого сравнения в источнике нет, это мой вывод по открытым данным).
Маркетологам. Экономия становится ощутимой при регулярных задачах: по оценке автора бенчмарка, локальная модель может приносить более 100 долларов пользы в месяц при затратах на электричество в считаные центы. Когда исчезает страх получить огромный счёт за ночной прогон, можно ставить аналитические задачи в фоновом режиме.
Предпринимателям в РФ и СНГ. Qwen 3.8 27B, модель с открытыми весами. Скачать и запустить можно из России без VPN. Данные не покидают ваш ноутбук, что снимает вопросы о конфиденциальности. Дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу) тоже возможно, хотя для SQL-задач в бенчмарке модель справилась и без него.
Я проверил: Qwen модели 3.8 действительно запускаются на не самом новом железе. Разница в 17 раз по стоимости при сопоставимой точности, это не маркетинг, а результат конкретного бенчмарка DABstep. Честная оговорка: бенчмарк тестирует агентную работу с SQL, а не универсальные способности модели. Для сложных задач с длинным контекстом, мультимодальных запросов или генерации текстов на русском результаты могут отличаться. Gemini-3-Flash по-прежнему точнее, а облачные модели удобнее, когда нужен мгновенный ответ без настройки. Но если вы регулярно работаете с данными и готовы потратить 10 минут на установку, локальный запуск Qwen окупится за первую же неделю.
Попробуйте генератор промптов dzen.guru
Подготовьте точные промпты для работы с Qwen и другими моделями, чтобы получать качественные SQL-запросы с первого раза
Попробовать бесплатноГлавный вывод прост: держать ноутбук включённым без локальной модели теперь значит переплачивать за каждый аналитический запрос, который можно было бы получить бесплатно.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент в мессенджере: $1 млрд Instinct и ещё 7 стартапов, заменяющих приложения
Компания Instinct в сентябре 2026 года привлекла 1 млрд долларов при оценке в 10 млрд долларов, и этот раунд стал самым заметным вложением в категорию…
Что такое ИИ-агент и почему он опаснее чат-бота: утечки, слежка, доступ к картам
Почему это важно Каждый крупный разработчик ИИ-агентов обещает «новый стандарт приватности», но на практике ни один пока не доказал, что данные пользователей в…
Студент МФТИ выиграл соревнование FLARE по медицинскому ИИ: опухоль на КТ за 11 секунд
Студенческая команда из России выиграла международное соревнование FLARE 2026 по медицинскому ИИ, обойдя конкурентов со всего мира моделью PANTHER, которая…
Комментарии