
ПСМ тестировала RAG на 188 вопросах: ассистент нашёл документ, но всё равно ошибся
Команда ПСМ, производителя энергетического оборудования, по итогам замеров 12 сентября 2026 года довела ИИ-ассистента по заводской документации до 84% верных ответов и показала, почему найденный документ ещё не гарантирует правильного ответа.
Разберём, как проверять ИИ-ассистента, который отвечает по вашим документам, до того как ему поверят сотрудники или клиенты. Речь про RAG: модель сначала ищет нужные куски в вашей базе документов, а потом пересказывает найденное, как стажёр со справочником. На выходе у вас будет план проверки из восьми шагов и список ловушек, на которые наступила команда ПСМ.
Высокий общий процент не означает точности. Ассистент ПСМ мог найти нужный документ, верно достать из него число и всё равно ошибиться. Мог и отказаться отвечать, хотя все данные лежали в базе.
В прошлом материале автор из ПСМ рассказывал, как трёхнедельный пилот растянулся на три месяца. Команде пришлось сначала разбираться в собственных документах. Теперь у неё есть база знаний, настроенный поиск и сотни контрольных вопросов, а разбор «Как мы тестировали RAG: нашли документ, но всё равно ошиблись» показывает, где система промахивается на инженерных запросах.
94% текста на английском, а вопросы задают по-русски
Пилот построили на газопоршневой электростанции AGBa1000 мощностью 1 МВт. Команда проверяет гипотезу: возьмёт ли ассистент на себя рутинный поиск по десяткам разнородных заводских спецификаций и станет ли меньше вопросов к инженерам по типовым параметрам оборудования.
Что вошло в тестовую базу:
- 44 документа: руководства по эксплуатации, описания систем, технические листы, инструкции производителей комплектующих;
- 29 файлов PDF, 12 Word и 3 Excel;
- половина документов на русском, половина на английском;
- 27 007 поисковых фрагментов, то есть кусков текста, на которые система режет документы, чтобы быстро находить нужное место.
Здесь важнее не 44, а 94. Файлов на двух языках поровну, но 94% фрагментов английские: объёмные руководства производителей комплектующих написаны на английском. Инженер спрашивает по-русски, а ответ лежит в англоязычном паспорте двигателя, в таблице на 150-й странице или в файле, в названии которого нет даже обозначения установки.
Команда пошла двумя путями. Она встроила RAG-поиск в уже работающий корпоративный ассистент, чтобы сотрудники тестировали его и давали обратную связь. Параллельно она строит отдельную платформу с более строгой проверкой источников.
Что понадобится для такой проверки?
- Документы по одному изделию или теме, а не весь архив сразу.
- Специалисты, которые знают, где в документах правильный ответ. В ПСМ это профильные специалисты завода.
- Контрольный набор вопросов с эталонными ответами. У ПСМ основной набор состоит из 188 вопросов.
- Вторая, независимая модель, которая сверяет смысл ответа с найденными фрагментами.
- Запас времени: пилот ПСМ планировали на три недели, а он занял три месяца.
Пошаговая инструкция: как проверить RAG на своих документах
- Разметьте документы. Отметьте, какой файл к какому изделию и комплектации относится. Иначе система не поймёт, какие данные применимы к вашему вопросу.
- Посчитайте язык по фрагментам, а не по файлам. Двуязычная база с перекосом вроде 94 на 6 требует, чтобы поиск сопоставлял русские и английские термины.
- Соберите вопросы на конкретные факты. Вместо «расскажи о станции» спрашивайте то, где в ответе есть число: режимы работы, электрические параметры, комплектация, регламенты технического обслуживания. Каждый вопрос записывайте по шаблону:
Вопрос: Сколько опор требуется для генератора станции AGBa1000 на 1000 кВт в режиме COP на газовом топливе?
Эталон: 2 опоры
Источник: техническое письмо производителя генераторов, таблица применяемости
- Проверьте сами эталоны. Специалисты ПСМ выборочно сверили часть эталонов с первоисточниками. В 19 случаях ошибся не ИИ, а эталонный ответ, составленный при подготовке теста.
- Сравнивайте автоматически, но помните о пределах. ПСМ сопоставляет извлечённые числа с эталоном, а смысл проверяет независимой моделью. Автор прямо оговаривает: это автоматический тест, а не экспертная приёмка.
- Режьте таблицы по строкам. Рост результата дал переход от крупных кусков текста к индексации строк таблиц как отдельных фактов.
- Подберите окно контекста. Это число найденных фрагментов, которые модель получает перед ответом. В ПСМ лучше сработали 10 фрагментов вместо 5.
- Сравнивайте «до» и «после» по каждому вопросу. После доработки на 26 вопросов система стала отвечать правильно, а на 14 ответила хуже, чаще всего из-за необоснованного отказа искать данные. Отказы считайте отдельной строкой.
Генератор станции может стоять на одном опорном подшипнике с жёстким фланцем к маховику или на двух собственных опорах с упругой муфтой. Тестировщик спросил, сколько опор нужно генератору на 1000 кВт в режиме COP на газе. COP здесь обозначает режим работы в таблице производителя.
В базе было техническое письмо производителя генераторов с таблицей применяемости. Для мощностей от 800 до 1120 кВт, газового привода и режима COP там указано исполнение «2 опоры». Ассистент ответил: «В предоставленной технической документации нет информации о количестве опор для генератора мощностью 1000 кВт».
Тогда пользователь прислал в чат скриншот страницы. По картинке модель распознала нужную строку и исправила ответ.
Документ в базе был, строка в таблице тоже была, а ассистент сообщил, что данных нет. Именно такие ошибки скрывает общий процент.
- Верить общему проценту. За ростом результата прячутся 14 вопросов, на которых система стала отвечать хуже.
- Считать эталон безошибочным. В ПСМ ручная сверка нашла 19 ошибок в самих эталонах.
- Судить по гладкости ответа. Модели говорят убедительно, и в одном из десяти красивых ответов может оказаться перепутанное напряжение генератора.
- Выдавать автоматический тест за приёмку. Независимая модель проверяет сходство ответа с фрагментами, а не правоту по существу.
- Не проверять сам вопрос. По опыту ПСМ, ассистент может не заметить, что задача поставлена неверно.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена. Если вы пишете статьи по своим заметкам через ИИ-ассистента, сверяйте с первоисточником каждое число в тексте. Отказ «данных нет» тоже проверяйте вручную.
Маркетологу. Когда подрядчик продаёт бота по документам компании, спрашивайте не общий процент. Попросите контрольный набор, список ошибок и долю необоснованных отказов.
Предпринимателю в РФ и СНГ. Начните с одного изделия и пары сотен вопросов, как ПСМ. Среди доступных в России моделей есть YandexGPT и GigaChat, и проверять их на своей базе стоит той же методикой, особенно если документы двуязычные.
На мой взгляд, главное в этом кейсе не 84%, а 19 ошибочных эталонов. Большинство команд, которые я вижу, проверяет модель и не проверяет свой тест. Начинайте с ручной сверки эталонов: это самый дешёвый способ не обвинить ассистента в чужой ошибке.
Честная оговорка: цифры получены на одной станции, 188 вопросах и автоматической проверке. Переносить их на свою базу нельзя. Ваш процент покажет только ваш собственный контрольный набор.
Научитесь проверять ответы нейросетей
На dzen.guru разбираем, как работать с ИИ так, чтобы в тексты не попадали выдуманные цифры.
Перейти на dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
OpenAI купила ИИ-планировщик поездок Odessia: сервис закрыт, основатель Sonder в команде
OpenAI купила Odessia, годовалый стартап с ИИ-планировщиком поездок, и взяла на работу его основателя Фрэнсиса Дэвидсона, ведь путешествия входят в число…
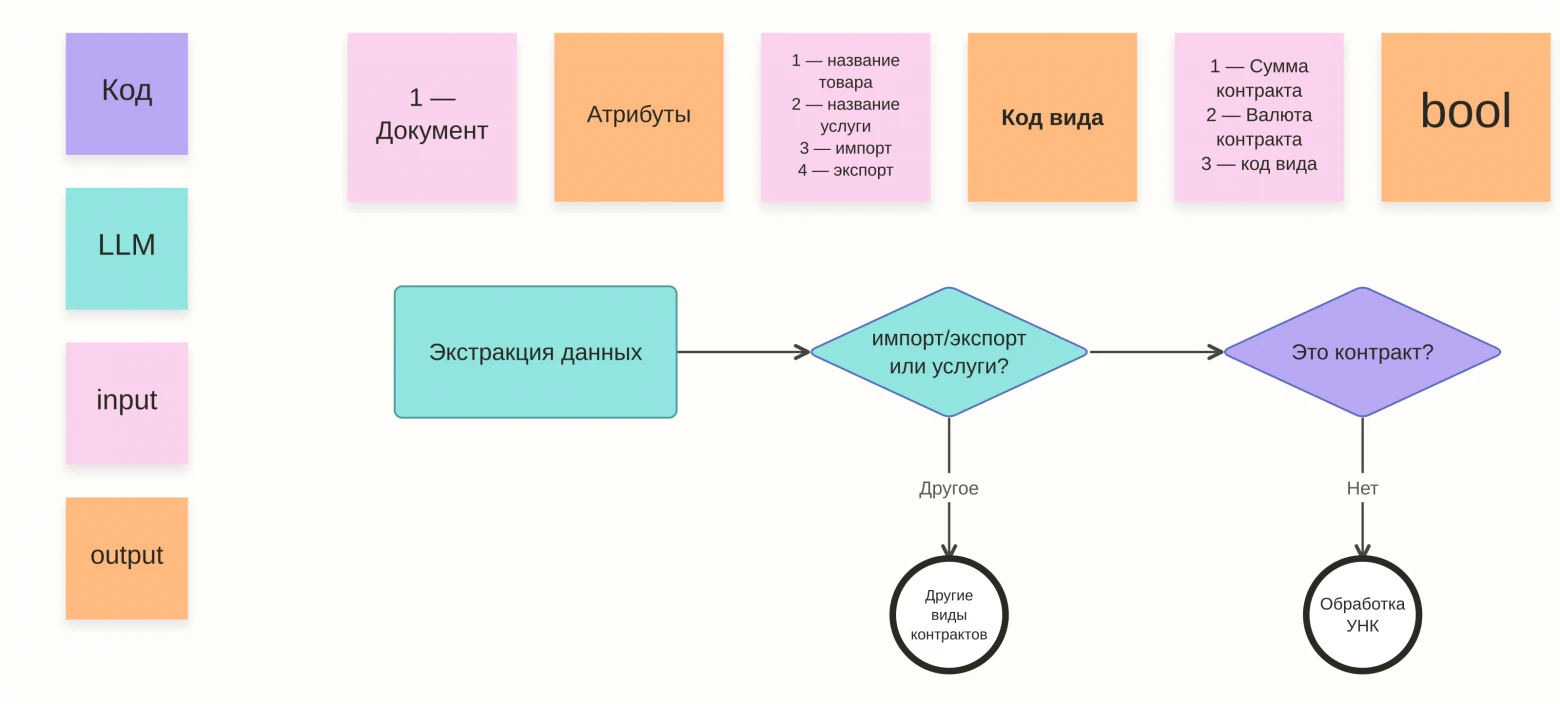
BPMN-диаграмма с нейросетью: в Альфа-Банке всё, что можно кодом, отдают коду
Сотрудник Альфа-Банка поделился приёмами разметки схем бизнес-процессов для проектов с языковыми моделями, которые его команда отработала на оптимизации…
Acrobat встроят в Gmail и Gemini, расширение Adobe Flash Player для Google Chrome ни при чём
Google на конференции Adobe MAX объявила о расширении партнёрства с Adobe. Скоро Acrobat и творческие инструменты компании встроят прямо в Gmail, Google Диск,…
Комментарии