
Пайплайн в n8n отсекает 90% нерелевантных вакансий: ИИ вместо фильтров по словам
Мониторинг вакансий с ИИ-оценкой собирают прямо в n8n: открытый пайплайн забирает RSS Habr Career, прогоняет каждую позицию через языковую модель и отсекает до 90 % нерелевантного шума, а релевантное отправляет в Telegram.
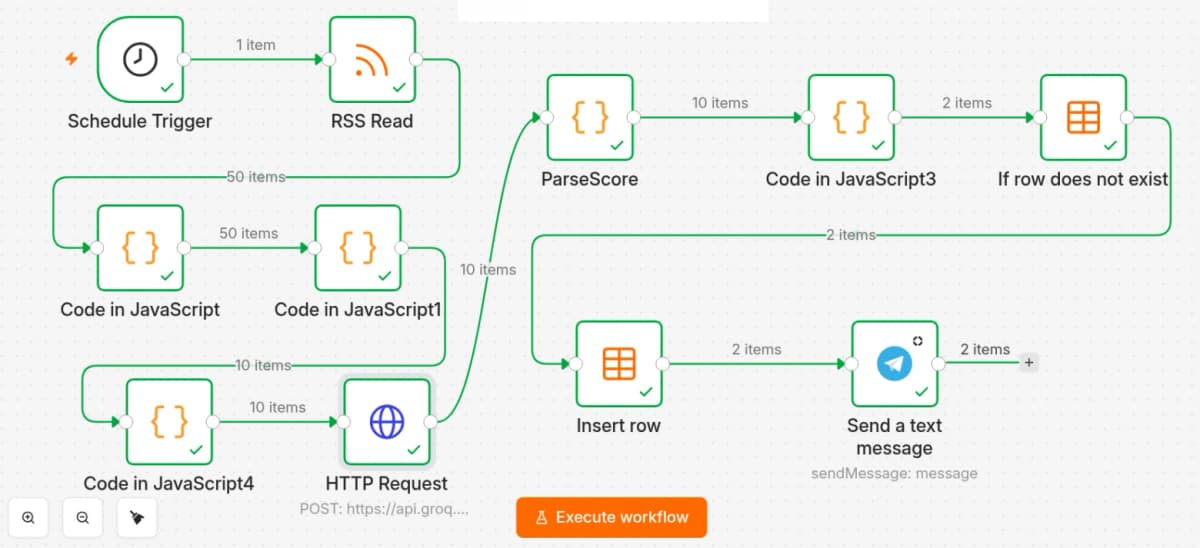
Текстовые фильтры по ключевым словам не различают контекст: слово «автоматизация» ловит и n8n-инженера, и менеджера по автоматизации продаж. Языковая модель работает как строгий рекрутер и оценивает смысл, а не совпадение букв.
Что произошло?
Разработчик опубликовал готовую архитектуру пайплайна (pipeline, цепочка последовательных шагов обработки данных) в n8n, платформе автоматизации с визуальным редактором. Пайплайн решает конкретную боль: поиск узкопрофильных вакансий вроде «n8n-инженер» или «специалист по интеграциям» через RSS даёт массу ложных срабатываний, а ручная проверка отнимает часы.
Вместо текстовых фильтров автор подключил LLM (большую языковую модель, то есть нейросеть, которая понимает смысл текста) через бесплатный тариф Groq API и модель qwen3.8-27b. Модель получает жёсткий промпт со шкалой оценки и обязана вернуть ответ строго в формате JSON (структурированный текст, который машина разбирает без ошибок). Вакансии с оценкой ниже 7 из 10 отсекаются автоматически.
Пайплайн запускается раз в час и проходит девять шагов: таймер, чтение RSS, очистка HTML, сборка промпта, запрос к Groq, разбор оценки, фильтр по порогу, проверка дубликатов через встроенную таблицу данных, отправка в Telegram.
Три грабли, на которых ломаются самодельные мониторы
Автор описал конкретные проблемы и их решения.
Лимит бесплатного Groq API. Бесплатный тариф даёт 7 000 входных токенов (токен, минимальная единица текста для модели, примерно три четверти слова) в минуту. Пятьдесят вакансий за один запуск съедают свыше 30 000 токенов, и API возвращает ошибку 429, «слишком много запросов». Решение: ограничить выборку до 10 вакансий за цикл функцией slice(0, 10) и выставить размер пакета равным единице. Потребление падает до 3 000-4 000 токенов за запуск.
Парсинг ответа модели. Даже при явном требовании вернуть JSON модель периодически оборачивает ответ в markdown-блоки, добавляет пояснения или вставляет пробелы в ключи. Наивный разбор через JSON.parse ломался на каждом третьем ответе. Решение: отдельная нода ParseScore с обёрткой try/catch. При сбое парсинга система подставляет нулевую оценку вместо остановки, и такая вакансия просто не проходит порог.
Размытые оценки. Первая версия промпта просила «оцени релевантность» и получала расплывчатые пятёрки-семёрки на всё подряд. Рабочим стало сочетание трёх элементов: жёсткая шкала с конкретными критериями отклонения, принудительный формат ответа и запасной разбор при ошибке.
Что с этого вам, по ролям?
Автору Дзена и копирайтеру. Принцип «LLM как фильтр вместо ключевых слов» работает не только для вакансий. Тот же подход переносится на мониторинг упоминаний бренда, отслеживание тем для статей или фильтрацию входящих писем. На n8n официальном сайте есть шаблоны, которые можно адаптировать без кода.
Маркетологу. Пайплайн показывает, как выжать пользу из бесплатного тарифа LLM при жёстких лимитах. Для мониторинга конкурентов или парсинга отзывов логика та же: маленькие пакеты, принудительный JSON, обработка ошибок без остановки.
Предпринимателю в РФ. Русскоязычная адаптация здесь особенно ценна: Habr Career и российский рынок вакансий дают свой поток для мониторинга. Можно сразу настроить фильтр под русские формулировки: «специалист по интеграциям», «автоматизация процессов». n8n разворачивается на своём сервере, данные не уходят за периметр.
Это не продукт и не стартап с раундом, это открытая инструкция, и именно поэтому она ценна. Автор показал не результат, а путь: три версии промпта, конкретные ошибки парсинга, точные цифры лимитов. На мой взгляд, подход «LLM как строгий рекрутер с порогом оценки» применим далеко за пределами вакансий. Мы в dzen.guru планируем протестировать похожую схему для мониторинга новостей. Честная оговорка: бесплатный Groq API не подходит для больших потоков. Полная проверка RSS из 50 позиций растягивается на несколько часов. Для срочных задач понадобится платный тариф или альтернативный провайдер.
Практический шаг: откройте n8n, создайте Schedule Trigger раз в час, подключите RSS Habr Career и добавьте HTTP Request к Groq API с промптом, который требует JSON с полями score и reason. Поставьте порог 7 и включите дедупликацию через Data Table. Весь пайплайн собирается за вечер, а экономит часы ручного просмотра каждую неделю.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент на сервере и как не дать ему снести рабочую базу: 7 шагов
ИИ-агент на вашем сервере может удалить рабочую базу за секунды, и проблема не в злом умысле модели, а в правах, которые вы ей выдали, поэтому разбираем по…
Цензура в закрытых ИИ моделях и нейросети без цензуры
Почему это важно Открытая модель Carbon-X показала на практике: фильтры закрытых нейросетей блокируют учёных, но не злоумышленников, и единственный выход для…
Вайбкодинг вышел за рамки прототипов: цикл PDCA делает результат предсказуемым
Компания Google второго июня выпустила обновлённый набор ИИ-инструментов для программирования, а параллельно с этим в русскоязычном сообществе разработчиков…
Комментарии