
Память человека в отличие от памяти ИИ: конвейер превращает Telegram-чаты в базу знаний за $10
Память человека в отличие от памяти ИИ устроена хаотично: мы забываем детали, путаем даты и теряем договорённости в потоке чатов, тогда как нейросеть способна вытащить из переписки структурированное знание, если правильно выстроить конвейер.
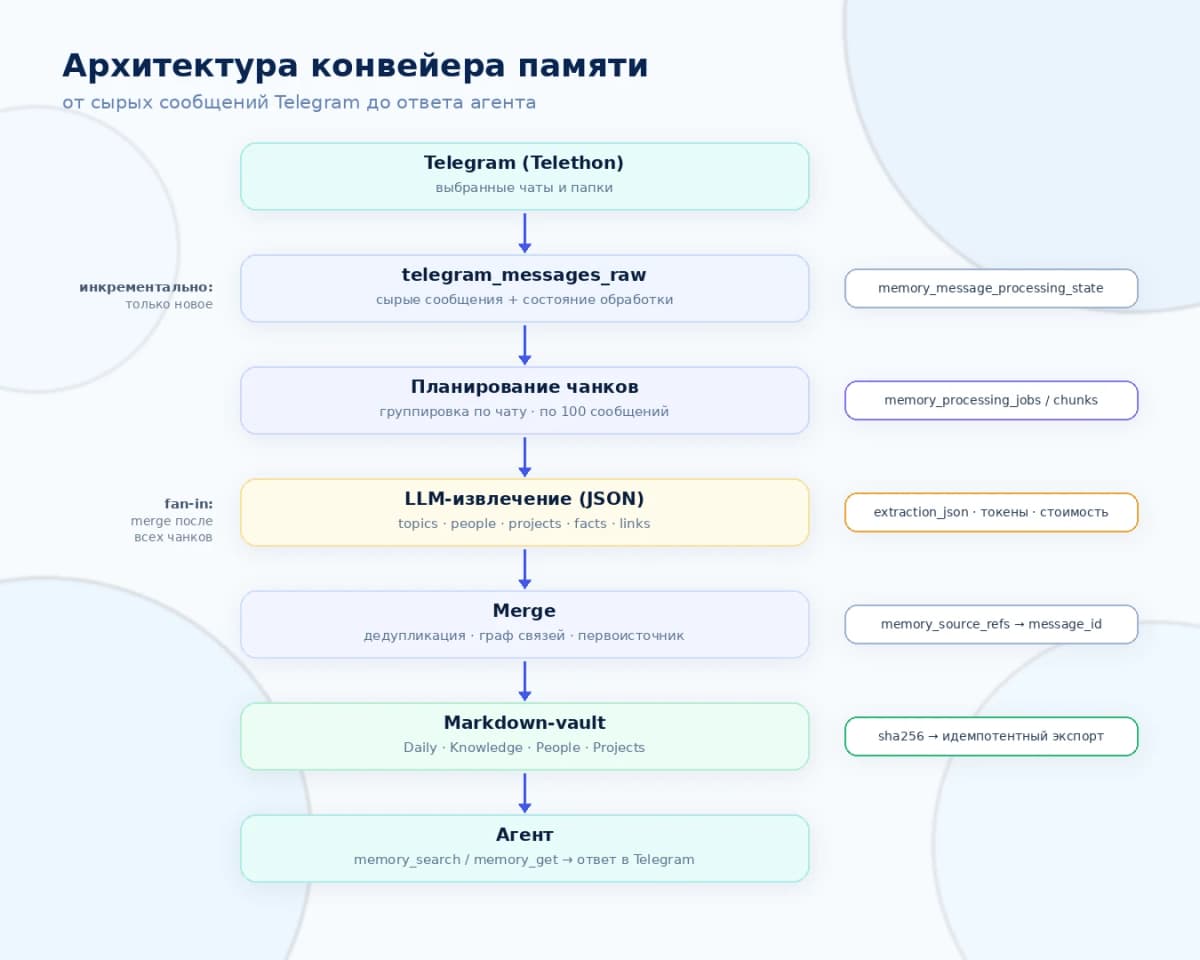
Впервые описан рабочий конвейер, который каждую ночь автоматически превращает Telegram-переписку в базу знаний с карточками людей, проектов и фактов, причём обработка десятков тысяч сообщений через DeepSeek обходится дешевле тысячи рублей.
Автор сервиса, который сам себя называет «второй памятью», отказался от стандартного подхода с векторной базой и RAG (retrieval-augmented generation, когда ИИ ищет ответ по заранее нарезанным кускам текста). Вместо этого он заставляет DeepSeek (открытая модель, доступная из России без VPN через API) разбирать диалоги и возвращать строгий JSON с темами, людьми, проектами, фактами и связями между ними. Результат выгружается в Markdown-файлы, которые открываются в Obsidian, бесплатном редакторе заметок.
Ниже разберём, что для этого нужно и как повторить.
Что понадобится
- Сервер или компьютер, который может работать ночью (подойдёт даже дешёвый VPS)
- Telegram-аккаунт и библиотека Telethon для доступа к сообщениям через API Telegram
- Ключ API DeepSeek (регистрация на сайте DeepSeek, оплата в долларах, по тарифам на момент теста обработка обходится дешевле десяти долларов за десятки тысяч сообщений)
- PostgreSQL или SQLite для таблицы состояния сообщений
- Obsidian (бесплатный) для просмотра итоговых заметок
- Около 2 часов на настройку конвейера и написание промпта
Пошаговая инструкция
-
Подключите Telethon к вашему Telegram-аккаунту. Укажите, какие чаты и папки забирать. Можно подключить папку целиком, можно отдельные чаты. Каждое сообщение получает запись в таблице состояния: «ожидает», «в процессе», «обработано», «ошибка». При следующем прогоне планировщик берёт только новые сообщения, так вы не платите дважды за одно и то же.
-
Сгруппируйте сообщения по ключу «источник:чат». Отсортируйте по дате и нарежьте на куски по 100 сообщений. Внутри куска должен быть только один чат, чтобы модель видела связный диалог. Из куска соберите транскрипт в формате:
[дата] Отправитель: текст
Обрезайте транскрипт по 30 тысячам символов, иначе контекстное окно переполнится.
- Отправьте каждый кусок в DeepSeek одним вызовом API. В промпте попросите модель вернуть строгий JSON с полями:
{
  "daily_note": { "title": "...", "summary": "..." },
  "topics": [{ "name": "...", "summary": "...", "facts": ["..."] }],
  "people": [{ "name": "...", "summary": "...", "action_items": ["..."] }],
  "projects": [{ "name": "...", "summary": "...", "action_items": ["..."] }],
  "links": [{ "from": "...", "to": "...", "type": "related_to" }]
}
-
Подложите в промпт список уже известных сущностей. Это критический шаг. Без него один и тот же проект каждый прогон получает новое имя, и база превращается в свалку дублей. Модель должна переиспользовать каноническое имя, а не придумывать новое.
-
Запустите слияние (merge). Сущности ищите по ключу «пользователь, тип, каноническое имя». Повторные упоминания не создают дублей, а обновляют описание. Факты и задачи привязываются к сущностям, связи уходят в отдельную таблицу, а каждая запись ссылается на ID исходных сообщений.
-
Выгрузите результат в Markdown-файлы. Четыре типа заметок: Daily (дневные), Knowledge (темы), People (люди), Projects (проекты). Ссылки между заметками оформляйте как
[[wiki-links]], тогда всё откроется в Obsidian. Перед записью блока считайте его sha256: если такой блок уже выгружался, пропускайте. Это делает экспорт идемпотентным, повторный запуск не портит файлы. -
Настройте cron или планировщик на запуск конвейера ночью. По данным автора, одно задание (все новые сообщения одного пользователя за прогон) идёт в среднем 205 секунд, самое долгое заняло почти 12 минут.
За два месяца теста на нескольких пользователях (в среднем по 7 источников на каждого: 3 папки и 4 отдельных чата) конвейер обработал десятки тысяч сообщений из 34 чатов. Итог: 281 сущность (147 тем, 108 человек, 26 проектов), 1815 фактов, 184 задачи и 133 дневные заметки.
Готовая карточка проекта выглядит так:
# Поездка в Анталью
## Update
Собирались в Анталью в сентябре, бюджет около 350 000 ₽ на двоих.
[[Аня]] предложила даты, [[Саша]] уточнил расклад по отелю и перелёту.

- Отель: около 180 000 ₽
- Перелёт: около 70 000 ₽
- [ ] Уточнить даты у Ани
Через полгода можно спросить «какой бюджет мы согласовали на поездку» и получить ответ со ссылкой на конкретное сообщение в конкретном чате. Память человека в отличие от памяти ИИ не способна удержать такие детали спустя месяцы, а здесь каждый факт привязан к первоисточнику.
Расход токенов (единица, которой измеряется объём текста для ИИ): 10,05 миллиона, из них 3,03 миллиона на входе и 7,03 миллиона на выходе. Выход дороже входа больше чем вдвое, потому что JSON со схемой занимает много места. По тарифам DeepSeek всё это обошлось дешевле десяти долларов, то есть меньше тысячи рублей по текущему курсу.
Не меняйте модель на лету. Автор менял модель в процессе обработки, и часть кусков посчиталась одной версией, часть другой. Данные не сломались, но результат стал непредсказуемым.
Прибейте версию образа. Обновление до «latest» может поменять и схему конфигов, и схему внутренней базы. Фиксируйте конкретную версию.
Не забывайте про переиндексацию. Если агент отвечает «ничего не найдено», хотя файлы на месте, проблема может быть в кэше. Автор столкнулся с тем, что инструмент поиска по памяти возвращал ложные нулевые результаты. Помогла принудительная переиндексация.
Telegram-сессии живут не вечно. Сессия Telethon может отвалиться, и тогда нужна повторная авторизация. Предусмотрите отдельный процесс для переподключения, иначе конвейер молча остановится. При повторной авторизации пересоберите список чатов, чтобы не остались мёртвые ссылки.
Telegram из России недоступен напрямую. Для работы API потребуется прокси или VPN на стороне сервера. Автор отмечает это как отдельную проблему.
Без списка известных сущностей модель плодит дубли. Человек в одном чате «Саша», в другом «Александр», в третьем у него непонятный ник. Если не передать модели канонические имена, в базе появятся три разных «человека» вместо одного.
Что делать с этим прямо сейчас?
Авторам Дзена: если вы ведёте тематические чаты с читателями или координируете редакцию через Telegram, этот конвейер автоматически соберёт все обсуждённые темы, договорённости и задачи в структурированную базу. Через месяц вы не будете искать «что мы решили по рубрике» вручную.
Маркетологам и контент-менеджерам: десятки рабочих чатов с подрядчиками, клиентами и командой превращаются в поисковую базу с фактами и суммами. Себестоимость обработки, меньше тысячи рублей за десятки тысяч сообщений.
Предпринимателям в РФ: DeepSeek доступен из России без VPN (API), что выгодно отличает его от GPT-4 и Claude. Однако для Telegram API вам потребуется прокси или VPN на стороне сервера. Из российских аналогов для подобных задач можно попробовать YandexGPT, но автор конвейера использовал именно DeepSeek и описывал затраты по его тарифам.
Я вижу главную ценность этого подхода не в технической хитрости, а в решении задачи, которую не закрывают обычные чат-боты. RAG по переписке, путь, который первым приходит в голову, но автор убедительно объяснил, почему он ведёт в тупик: нарезка по токенам (единица объёма текста для модели) рвёт контекст, а один человек под разными именами в разных чатах превращает поиск в хаос.
Структурированные карточки с каноническими именами, фактами и обратными ссылками на сообщения решают это элегантно. По моим наблюдениям, для авторов и маркетологов из РФ DeepSeek сейчас лучший вариант по соотношению цены и качества для задач на русском языке.
Честная оговорка: конвейер требует навыков программирования. Это не «кнопочное» решение, а проект для тех, кто готов писать код на Python и поддерживать серверную инфраструктуру. Для остальных имеет смысл ждать, пока подобные сервисы появятся в виде готовых продуктов.
Конвейер, который каждую ночь за тысячу рублей собирает из хаотичной переписки базу знаний с людьми, проектами и задачами, это не теория, а работающая система с конкретными цифрами. Если у вас есть Python и сервер, вы можете развернуть его за вечер и к утру получить первые карточки.
Попробуйте нейросети для работы с контентом
Протестируйте ИИ-инструменты для авторов Дзена и узнайте, какие задачи можно автоматизировать уже сегодня
Перейти к инструментам
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Нейрослоп на Хабре невидим: российские детекторы дают 0%, GPTZero показывает 100%
Слово «нейрослоп» появляется в источнике многократно и описывает контент, сгенерированный нейросетью и опубликованный без редактуры. Источник не даёт…
Голосовой бот обрабатывает 19% звонков в кол-центрах, но каждый пятый клиент уходит без ответа
Отношение к голосовым ИИ-системам в телефонии остаётся одним из самых спорных вопросов клиентского сервиса: компании сокращают расходы на кол-центры, а клиенты…
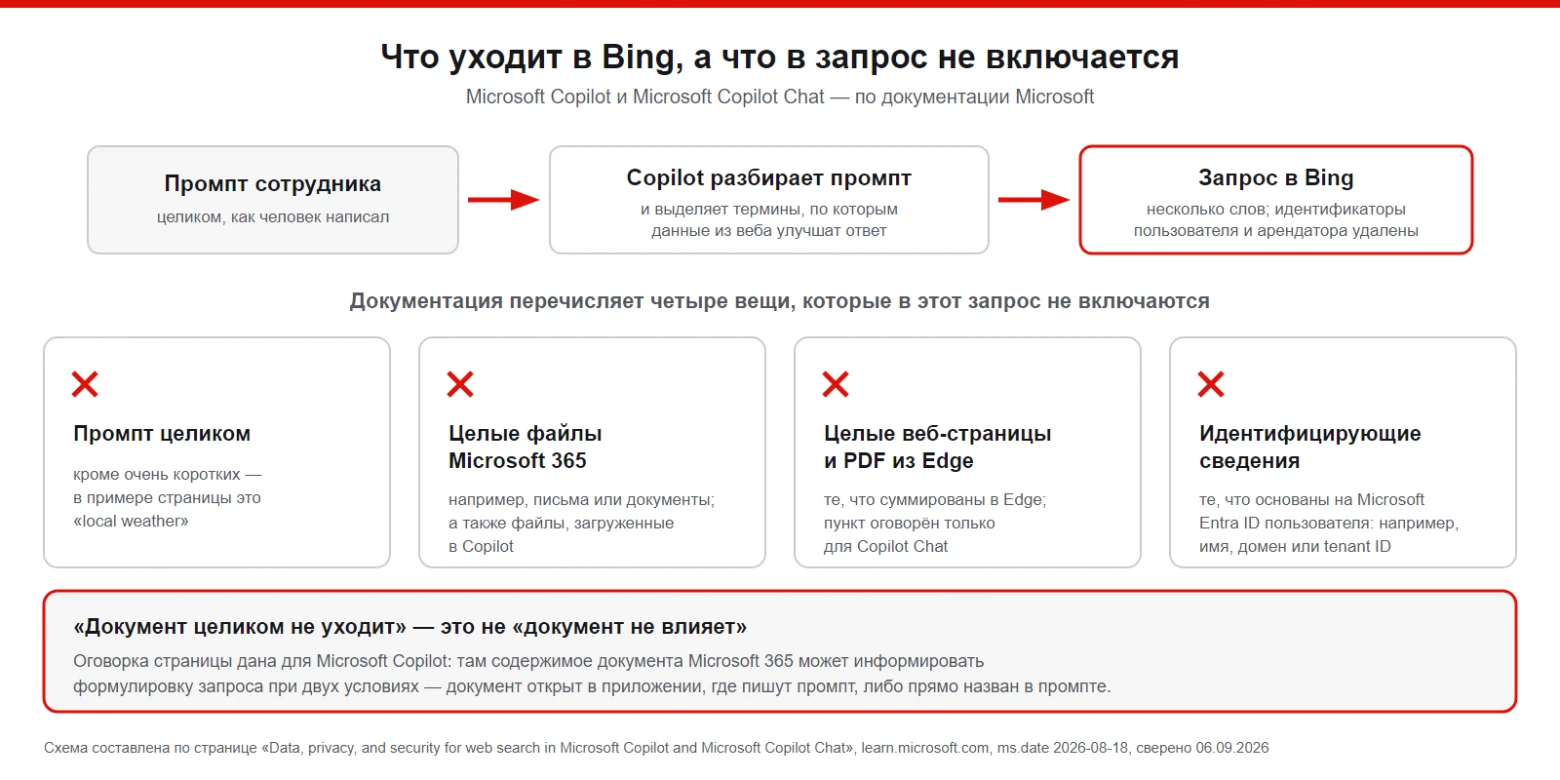
Copilot передаёт запросы в интернет без ведома сотрудника: что уходит в Bing и как это контролировать
Microsoft Copilot (ИИ-ассистент, встроенный в Microsoft 365) при ответе на вопрос сотрудника может сам обратиться к поисковику Bing, и документация Microsoft,…
Комментарии