
Открытые языковые модели тратят 90% токенов на рассуждения: Ember 1 срезает расход вдвое
Fireworks AI выпустила Ember 1, модель на базе Kimi K3, которая тратит на 40% меньше токенов (минимальных единиц текста, которые обрабатывает ИИ) при сохранении качества ответов, и это результат не снижения усилий при генерации, а отдельного дообучения (обучения модели на новых примерах под конкретную задачу).
Открытые языковые модели тратят до 90% генерируемых токенов на внутренние рассуждения, и каждый такой токен стоит денег. Ember 1 впервые показывает, что дообучение способно срезать эти расходы почти вдвое без потери точности, а значит, меняет экономику запуска рассуждающих моделей в продакшене.
Компания Fireworks AI, разрабатывающая инфраструктуру для запуска ИИ-моделей, опубликовала результаты своего исследовательского проекта Ember 1. Модель построена поверх открытых весов (параметров, которые автор модели выложил в открытый доступ) Kimi K3 от китайской Moonshot AI. По данным Fireworks, команда провела больше 50 экспериментов по дообучению и свыше 200 оценочных прогонов, прежде чем получила версию, которая рассуждает короче, но не хуже оригинала.
| Показатель | Значение | Источник |
|---|---|---|
| Сокращение токенов на задачу | 35-50% | Fireworks, релизный пост |
| Выходные токены в A/B-тесте (K3 / Ember 1) | 49 300 / 29 900 | Fireworks, A/B-тест с клиентами |
| Снижение reasoning-токенов в A/B-тесте | 71,3% | Fireworks, A/B-тест с клиентами |
| Оценка задачи (K3 / Ember 1) | 0,751 / 0,753 | Fireworks, A/B-тест с клиентами |
| Terminal Bench 2.1 (Ember 1) | 82,0% | Fireworks, собственные бенчмарки |
| DeepSWE 1.1 (Ember 1) | 75,2% | Fireworks, собственные бенчмарки |
| Цена за 1 млн выходных токенов | $15,00 | Fireworks, публичный прайс |
| Количество обучающих экспериментов | более 50 | Fireworks, релизный пост |
В чём суть: почему модели «думают» слишком долго?
Рассуждающие модели (reasoning models) работают так: прежде чем дать ответ, модель генерирует длинную цепочку внутренних рассуждений. Это помогает точности, но стоит денег, потому что каждый токен оплачивается отдельно.
По данным Fireworks, модели вроде Kimi K3 иногда тратят больше 90% сгенерированных токенов именно на внутренние рассуждения, а не на финальный ответ. В многошаговых агентных сценариях (когда ИИ-агент выполняет задачу в несколько ходов) проблема умножается: на каждом шаге модель перечитывает рассуждения предыдущих шагов. Контекст растёт почти квадратично, и счёт за API растёт вместе с ним.
Обычное решение, снизить параметр «усилия при рассуждении» (reasoning effort) прямо при запросе к модели. Но команда Fireworks сообщает, что на Kimi K3 этот подход не работал: снижение усилий слишком сильно роняло качество. Поэтому вместо грубой регулировки они решили дообучить саму модель рассуждать компактнее.
Что показали замеры?
Fireworks сравнивала Ember 1 с оригинальной Kimi K3 на трёх уровнях reasoning effort. Вот ключевые результаты:
- Меньше токенов при том же качестве. В живом A/B-тесте с двумя клиентами на реальных задачах кодирования выходные токены упали с 49 300 до 29 900 на задачу. Оценка качества практически не изменилась: 0,753 у Ember 1 против 0,751 у K3.
- Reasoning-токены сократились на 71,3%. Общее число токенов на задачу упало на 39%. Среднее количество шагов снизилось с 23,8 до 21,4.
- На двух бенчмарках Ember 1 обогнала K3 Max. Terminal Bench 2.1: 82,0%. DeepSWE 1.1: 75,2%. На SWE-bench Verified Ember 1 немного уступает: 92,2% против результата K3 Max.
- Медицинский бенчмарк. На Doximity Bedside Bench (500 клинических случаев, проверенных врачами) Ember 1 показала лучшее соотношение стоимости и точности по индексу Specialized Intelligence Index от Fireworks.
По расчётам Fireworks, стоимость выходных токенов на одну задачу падает примерно с $0,74 до $0,45 при том же прайсе за токен: $15 за 1 млн выходных токенов, $3 за 1 млн входных.
Один из двух клиентов, участвовавших в A/B-тесте, уже перевёл Ember 1 в продакшен.
Все бенчмарки и цифры A/B-тестов опубликованы самой Fireworks AI. Независимых замеров пока нет. Веса модели, код дообучения и описание алгоритмов не раскрыты: Fireworks прямо пишет, что разработала новые алгоритмы обучения, но не публикует их. Самостоятельно развернуть Ember 1 нельзя: доступ только через API Fireworks в режиме Research Preview. Компания также заявляет, что использовала только собственные данные, без данных клиентов, но проверить это извне невозможно.
Что это значит для вас?
Разработчику, который использует Kimi K3 через API. Если вы уже платите за Kimi K3 на Fireworks, переключение на Ember 1 может сократить расходы на выходные токены примерно на 40% без переписывания промптов (текстовых инструкций для модели). Цена за токен та же, экономия возникает за счёт того, что модель генерирует меньше. Для стартапов с ограниченным бюджетом на ИИ это может означать разницу между рентабельным и убыточным продуктом.
Автору на Дзене и контент-маркетологу. Напрямую Ember 1 вам пока не пригодится: это API-модель для разработчиков, не чат-бот. Но сам принцип важен. Открытые языковые модели становятся дешевле не за счёт упрощения, а за счёт умного дообучения. Это значит, что инструменты на базе таких моделей будут дешеветь и для конечных пользователей.
Предпринимателю в РФ. Ember 1 доступна только через API Fireworks, а доступ из России к этому сервису может быть ограничен. Из ближайших российских альтернатив для задач кодирования и рассуждений доступны YandexGPT и GigaChat, но прямого аналога дообученной рассуждающей модели с открытыми весами в российской экосистеме пока нет. Сам подход Fireworks, дообучение чужой открытой модели для снижения стоимости инференса (генерации ответа), может быть воспроизведён на любых открытых языковых моделях, если веса доступны.
Fireworks показала красивый инженерный результат, но есть нюанс, который я считаю принципиальным. Модель построена на открытых весах Kimi K3, однако сама Ember 1 закрыта: ни весов, ни кода, ни алгоритмов. Это значит, что вы можете использовать результат только на условиях Fireworks и только через их API. Для тех, кто выбирает открытые языковые модели ради независимости от поставщика, это замкнутый круг: экономия есть, свобода нет. По моим наблюдениям, это типичная модель монетизации: взять открытое, улучшить, закрыть улучшение. Подход рабочий, но называть его открытым исследованием я бы не стал.
Экономия в 40% токенов при нулевой потере качества, если цифры Fireworks подтвердятся независимо, это аргумент, который понятен любому, кто платит за API по счётчику. Ждём независимых бенчмарков и, главное, публикации алгоритмов: пока они закрыты, воспроизвести результат на своей инфраструктуре не получится.
По данным Marktechpost

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое галлюцинации нейросетей: три слоя проблемы, которую вы не замечаете
Галлюцинации нейросетей кажутся безобидными опечатками, пока модель не выдаёт несуществующую научную статью с правдоподобным названием, реальным журналом и…
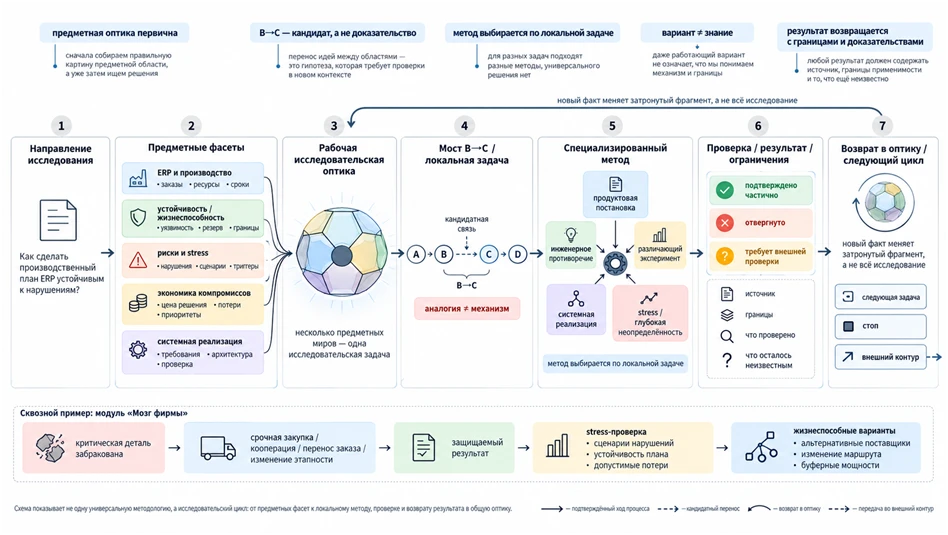
Исследования искусственного интеллекта на стыке наук
Текст новости строится строго по переданному оригиналу. Оригинал описывает авторскую методологию исследований на стыке наук с примером ERP-системы. Формат…
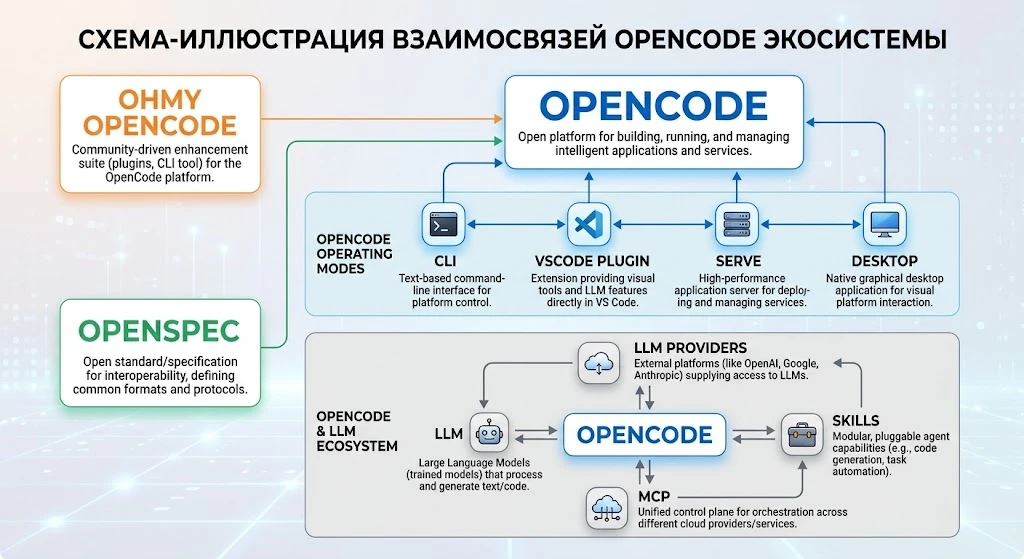
Свой сервер ИИ-разработки за 15 минут: OpenCode, OpenAI API и никакой привязки к вендору
Статья показывает практическую сборку рабочего стека для разработки с ИИ без привязки к одному провайдеру: конкретные шаги установки OpenCode на Linux и…
Комментарии