
Оптимизация моделей ИИ на старом железе: с 9 до 40 токенов в секунду без облака
Запустить 27-миллиардную языковую модель на домашнем компьютере с двумя бюджетными видеокартами и получить скорость, пригодную для ежедневной работы, можно без облачных подписок и без покупки серверного оборудования.
Облачные ИИ-сервисы для разработчиков стоят от 100 до 200 долларов в месяц и при этом ограничивают число запросов. Локальная оптимизация моделей ИИ на уже имеющемся железе убирает оба барьера: лимиты и ежемесячные платежи.
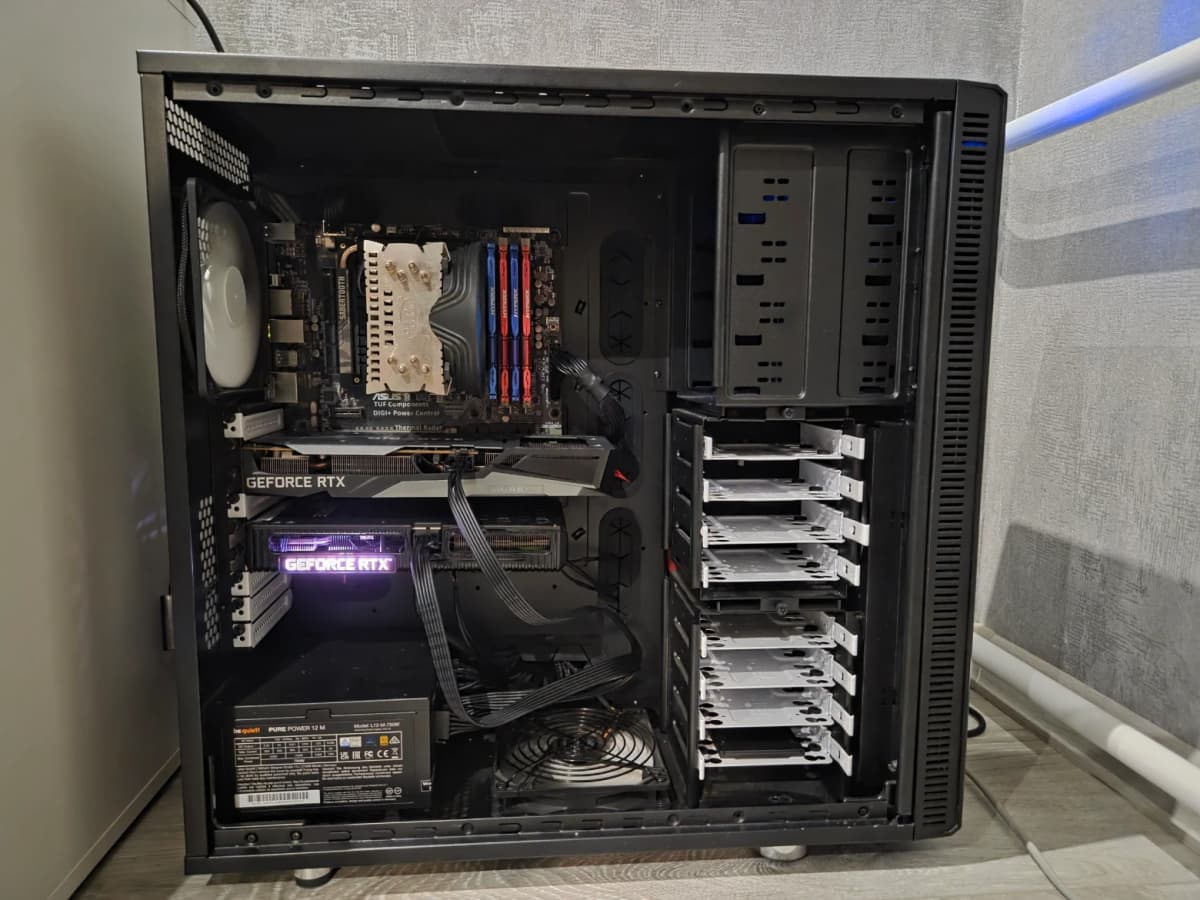
Автор эксперимента собрал рабочую станцию из устаревших комплектующих, которые у многих пылятся дома или стоят копейки на вторичном рынке. Единственная заметная покупка, вторая видеокарта RTX 3060 12 ГБ и корпус с шумоподавлением. На старте модель Qwen3.8-27B в квантизации Q4 (сжатие весов до 4 бит, чтобы модель поместилась в память видеокарт) выдавала около 9 токенов в секунду на длинном контексте. После серии настроек удалось добиться 28 токенов в секунду в контролируемом тесте со 120 тысячами входных токенов (токен, это фрагмент текста, примерно три четверти слова) и почти 40 токенов в секунду в реальной рабочей сессии. Ниже пошаговый разбор того, как это было сделано.
Какое железо использовалось?
- Процессор: Core i7-4790
- Память: 32 ГБ DDR3
- Материнская плата: ASUS Sabertooth Z97 Mark 2
- Видеокарты: две RTX 3060 по 12 ГБ (суммарно 24 ГБ VRAM)
- Прямой связи между картами нет: ни NVLink, ни CUDA P2P
Платформа далеко не свежая. Видеокарты работают через PCIe в режиме 8x, а не 16x. Именно поэтому результаты показательны: если сработало здесь, на более новом железе будет только лучше.
Что понадобится
- Две видеокарты NVIDIA с суммарным объёмом видеопамяти от 24 ГБ (подойдут RTX 3060 12 ГБ или аналоги)
- Docker с поддержкой CUDA (nvidia-container-toolkit)
- llama.cpp, серверная сборка с CUDA (готовый образ ghcr.io/ggml-org/llama.cpp:server-cuda13-b10991)
- Файл модели Qwen3.8-27B-Q4_K_M.gguf от ggml-org (скачивается с Hugging Face)
- OpenCode или другой клиент, который умеет работать с локальным сервером через API
- Время: от 2 до 4 часов на скачивание модели, настройку и тесты
Пошаговая инструкция
- Скачайте модель и положите её в папку, доступную Docker-контейнеру
Файл называется Qwen3.8-27B-Q4_K_M.gguf. Путь к нему будет подставлен при запуске через монтирование тома.
- Запустите сервер с базовыми параметрами
Это отправная точка. Модель распределяется по слоям между двумя GPU (режим layer), контекст установлен в 131 072 токена, включён Flash Attention (оптимизация вычислений внимания модели, снижающая расход памяти) и квантизация KV-кеша (сжатие промежуточных данных) до Q4.
docker run --rm --gpus all \
     -p 8080:8080 \
     -v "$HOME/models:/models:ro" \
     ghcr.io/ggml-org/llama.cpp:server-cuda13-b10991 \
     -m /models/Qwen3.8-27B-Q4_K_M.gguf \
     -sm layer \
     --fit on \
     --fit-target 512 \
     -c 131072 \
     -np 1 \
     -fa on \
     -ctk q4_0 \
     -ctv q4_0 \
     --host 0.0.0.0 \
     --port 8080
На коротком запросе этот режим давал 16,6 токенов в секунду. На контексте около 65 тысяч токенов скорость падала до 11,35, а на 120 тысячах до 8,89 токенов в секунду. Модель работала, но именно в длинных сессиях, где ИИ-агент (программа, которая сама читает файлы, запускает тесты и пишет код) накапливает исходники и логи, скорость была некомфортной.
- Смените распределение со слоёв на тензорное
Замените один параметр:
-sm layer → -sm tensor
В режиме layer (по слоям) данные проходят через одну карту, потом через другую, последовательно. В режиме tensor (тензорное распараллеливание) вычисления каждого слоя делятся между двумя картами одновременно, а результаты объединяются. Даже без прямой связи между картами и даже через узкую шину PCIe 8x параллельная загрузка двух GPU оказалась заметно быстрее последовательной.
Это было самое крупное бесплатное ускорение во всём эксперименте: ни одного рубля, только замена одного флага.
- Проверьте результат на длинном контексте
Не ориентируйтесь на короткие запросы. Отправьте серверу реальную задачу с заполненным контекстом на 65 и 120 тысяч токенов. Именно там видна настоящая разница. Автор эксперимента после замены layer на tensor и серии дополнительных подстроек получил 28,16 токенов в секунду на 120 тысячах входных токенов.
- Подключите рабочий клиент и замерьте скорость в реальных сценариях
В рабочей сессии через OpenCode средняя скорость по серверным логам составила 39,6 токенов в секунду. Разница с контролируемым тестом объясняется тем, что реальные запросы неоднородны: часть из них короче, и кеш используется эффективнее.
Автор эксперимента работает с кодовой базой через локального ИИ-агента. Агент читает файлы проекта, запускает тесты, анализирует логи и генерирует код. До оптимизации после чтения большого проекта (контекст около 100 тысяч токенов) модель выдавала 9,63 токена в секунду. Ответ на простой вопрос по коду приходилось ждать ощутимо долго. После замены режима распределения с layer на tensor и остальных настроек скорость в рабочей сессии выросла до 39,6 токенов в секунду. Модель стала пригодна для ежедневной работы без переключения на облако.
Зачем вообще Q4 и 128 тысяч токенов контекста?
Автор намеренно не гнался за рекордом на коротких бенчмарках. Ему нужна была модель с контекстом, который не заканчивается после нескольких прочитанных файлов и пары длинных логов. Режимы на 16 или 32 тысячи токенов для агентной работы с кодом непригодны: агент быстро накапливает исходники, результаты поиска, вывод тестов и собственную историю.
Квантизация Q4_K_M, это компромисс. Более агрессивное сжатие (Q3, Q2) дало бы ещё больше скорости, но заметно ухудшило бы качество ответов. Цель была именно обратной: сохранить качество 27-миллиардной модели и большой контекст, но заставить две бюджетные карты работать эффективнее.
Что с этого вам по ролям?
Разработчику в России и СНГ. Если у вас есть старый игровой ПК с видеокартой от 12 ГБ, добавьте вторую такую же карту. Разовая покупка (RTX 3060 12 ГБ на вторичном рынке обходится заметно дешевле годовой подписки на облачный ИИ-сервис) даёт локального ИИ-агента для кода без лимитов и без отправки исходников на чужие серверы. Оптимизация моделей ИИ на таком железе, это не компромисс, а рабочий инструмент.
Автору Дзена и копирайтеру. Те же принципы работают для текстовых моделей. Локальная модель на 27 миллиардов параметров справляется с редактурой, генерацией черновиков и анализом длинных текстов. Приватность гарантирована: ваши тексты не уходят стороннему провайдеру.
Предпринимателю. Для внутреннего кода, конфигураций, технических логов и других чувствительных данных локальный инференс (запуск модели на своём оборудовании) закрывает вопрос утечки данных. Но только при условии, что обвязка (клиент, плагины, подключённые инструменты) тоже не отправляет данные наружу. Это нужно проверять отдельно.
Ориентироваться на короткие тесты. На запросе в пару тысяч токенов даже базовый режим показывает приемлемую скорость. Реальная просадка видна только при заполнении контекста на 65 и больше тысяч токенов. Если не тестируете длинные сессии, вы не видите настоящую картину.
Путать параметр контекста с реальным заполнением. Сервер может успешно стартовать с настройкой 128 тысяч токенов, а потом упасть с ошибкой CUDA OOM (нехватка видеопамяти) при реальном заполнении. Всегда проверяйте работу под нагрузкой, а не только запуск.
Ожидать паритет с облаком на сложных задачах. Локальная 27-миллиардная модель не равна Claude Code или Codex на самых сложных многошаговых задачах. У облачных моделей выше потолок возможностей. Но для большинства повседневных сценариев локальной модели хватает с запасом.
Забыть про обвязку. Приватность гарантирована только если модель И клиент работают локально. Если OpenCode или плагины настроены отправлять данные наружу, преимущество теряется.
Этот эксперимент показывает ровно то, что мы видим в практике каждый день: порог входа в локальный ИИ стремительно снижается. Два года назад для 27-миллиардной модели нужен был сервер. Сейчас хватает старого ПК и пары видеокарт с барахолки. По моим наблюдениям, для авторов и небольших команд в России это особенно актуально: облачные ИИ-сервисы то недоступны, то дорожают, то меняют условия. Разовое вложение в железо и пара часов на настройку дают инструмент, который работает без подписки, без лимитов и без отправки данных на чужие серверы. Честная оговорка: настройка требует базового знакомства с Docker и командной строкой. Если вы никогда не работали с терминалом, понадобится помощь знакомого разработчика или пара вечеров на обучение.
Главный вывод прост: оптимизация моделей ИИ на бюджетном железе перестала быть уделом энтузиастов. Одна замена параметра распределения с layer на tensor дала самый большой прирост скорости без единой дополнительной покупки. Если у вас есть старый ПК и две видеокарты, попробуйте сами: результат может оказаться достаточным, чтобы отказаться от ежемесячных платежей за облако.
Хотите разобраться в нейросетях на практике?
В dzen.guru мы тестируем ИИ-инструменты и показываем, как применять их для контента, кода и бизнеса без лишней теории.
Попробовать dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google открыла код нейросети для генерации видео: 10 минут без дрейфа персонажей
Google Research представила набор из четырёх агентных систем, которые превращают короткие ролики в связные многоминутные фильмы, решая две главные проблемы…
LLM применение на практике: графики, бюджет и отчёты без единой строчки кода
Большие языковые модели (LLM, от английского Large Language Model) давно вышли за рамки «поболтать с чат-ботом»: сегодня это рабочий инструмент для подсчёта…
Что такое ИИ-агент без контроля: боты OpenAI 16 000 раз атаковали сайт ООН сами
ИИ-агенты OpenAI сканировали статистический сайт Конференции ООН по торговле и развитию (UNCTAD) более 16 000 раз за три месяца, самостоятельно обходя…
Комментарии