
Один ИИ-агент с самопроверкой дешевле команды до 64 агентов: замер на 14 правках кода
Исследователь на фоне новых командных режимов у вендоров сравнил команды от одного до 64 ИИ-агентов на одних и тех же правках кода и выяснил, что дешевле всего зачёт даёт один агент с самопроверкой.
Командный режим не гарантирует больше успешных результатов за те же деньги. На 14 правках кода дешевле всего в расчёте на зачёт обошёлся один агент, и это довод сначала считать, а потом масштабировать.
Вендоры добавляют в агентные харнессы (программную обвязку, через которую модель читает файлы, запускает проверки и общается с другими агентами) всё больше режимов. Одну правку можно поручить одному агенту или собрать команду с ведущим и сабагентами (помощниками, которые делают часть работы и отчитываются ведущему). Советы расходятся: OpenAI предлагает сначала выжать максимум из одного агента, а команда Veai описывает задачи, где ей помогло разделение работы.
Если коротко, что такое ИИ-агент: это нейросеть, которой дали инструменты и право действовать по шагам. Например, самой написать код, запустить проверку и исправить ошибку. Автор замера записал выбор числа агентов как задачу оптимизации: для каждого состава оценил шанс получить рабочий патч (правку в коде) и стоимость всех попыток.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Сравнение команд от 1 до 64 ИИ-агентов на одних задачах | Запросы выполнены 18 ноября 2026 года | Автор замера, имя в материале не указано | Итоговые суммы в материале не приведены, в расчёт вошли все вызовы |
Что нового?
- Восемь размеров команды: 1, 2, 4, 6, 8, 16, 32 и 64 агента на одних и тех же задачах.
- Две модели: DeepSeek V4.1 Flash и Qwen3.8 Flash. Запросы шли через провайдера Alibaba, режим рассуждений выключен.
- Задачи: 14 правок в двух библиотеках (готовых наборах кода) на языке Python, восемь в Click и шесть в Packaging. Для широкого сравнения добавили 30 задач с сайта соревнований по программированию AtCoder из набора LiveCodeBench, по три уровня сложности.
- Качество: доля итоговых ответов, прошедших целевые тесты. Это проверки, которые ловят именно исходную ошибку.
- Цена: все вызовы, даже если решение так и не получилось. Расходы считали в токенах (кусочках текста, за которые провайдер берёт плату) и без скидки за кэш, то есть за повторно отправленную часть запроса.
- Вывод: на правках Click и Packaging самым дешёвым в расчёте на зачёт оказался один агент с самопроверкой.
Как работает команда из 64 агентов?
Одиночный агент сначала писал решение, потом проверял его и мог исправить. В команде каждый писал свой вариант, а сабагент ещё и проверял черновик соседа. Ведущий получал все рецензии и до трёх полных черновиков, после чего выпускал один итоговый ответ.
В команде из восьми было семь сабагентов и один ведущий. При 64 агентах ведущему приходит 63 рецензии, и каждая оплачена токенами. Автор отдельно проверял, что тесты честные: прогонял их на старом коде и на эталонном исправлении.
Полный цикл работы над задачей в замер не входил: без уточнения требований, ревью человеком и выпуска. Область, где нужно менять код, агентам указали заранее. Влияние отдельных рецензий на итог не оценивали, а проверены только две модели.
Как попробовать?
- Возьмите локальную задачу с понятной приёмкой, где заранее ясно, как проверить результат.
- Поручите её одному агенту и попросите проверить собственный черновик.
- Проверьте первый черновик своими тестами. Для текста подойдёт чек-лист требований.
- Добавляйте агентов, только если один не справляется, и считайте все вызовы, включая неудачные.
Подходит ли этот подход для российских нейросетей?
Из доступных в РФ моделей, YandexGPT и GigaChat, в замере не участвовали. Поэтому переносить цифры на них нельзя. Логику расчёта перенести можно: сравнить шанс на годный результат и полную стоимость попыток для одного запроса и для цепочки из нескольких.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Прежде чем строить цепочку «писатель, редактор, корректор» из нескольких нейросетей, попробуйте одну с просьбой перепроверить текст по вашему чек-листу. Сравните, сколько правок осталось вручную.
Маркетологу. Если платите за API (доступ к нейросети для программ), считайте цену успешного результата, а не одного запроса. Командный режим умножает число вызовов: 64 агента дают 63 рецензии плюс итог ведущего.
Предпринимателю. Перед покупкой агентной системы спросите подрядчика, как он измерял качество и входят ли в цену неудачные попытки. В этом замере они входили, и поэтому сравнение получилось честным.
На мой взгляд, главное в этом замере не вывод про одного агента, а сам способ считать: цена зачёта вместо цены запроса. Оговорка серьёзная: проверены узкие правки кода с заранее известной областью изменений, а длинные проекты могут вести себя иначе. Что сделать сегодня: возьмите одну типовую задачу, прогоните её одним агентом и посчитайте, сколько попыток ушло на годный результат.
Что чаще всего спрашивают про команды агентов?
Значит, команды ИИ-агентов бесполезны?
Нет. Команда Veai описывает задачи, где разделение работы помогло. Но когда задача помещалась в контекст одного агента (объём текста, который модель держит в памяти за раз), он тратил меньше токенов на сопоставимый результат.
Нужно ли уметь программировать, чтобы применить вывод?
Нет. Замер шёл на коде, а правило годится для любой задачи с понятной проверкой: один исполнитель, самопроверка, приёмка по чек-листу.
Можно ли переносить цифры на другие модели?
Напрямую нельзя: проверяли только DeepSeek V4.1 Flash и Qwen3.8 Flash с фиксированными настройками. Переносить стоит привычку: сначала один агент и честный подсчёт, а команда только тогда, когда он упёрся в потолок.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Нейросеть для 1С: разработчик с 2006 года советует начинать с чтения кода, а не с правок
Разработчик 1С со стажем с 2006 года после месяца ежедневной работы с ИИ советует начинать не с выбора модели, а с безопасного процесса, пока названия и…
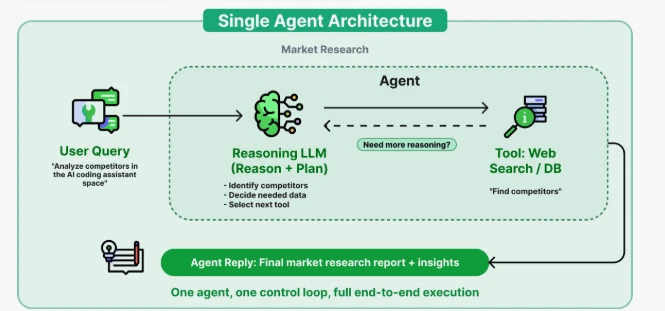
Эксперт объяснил, что такое ИИ-агент: без четырёх опор демо разваливается через три месяца
Андрей Бирюков, независимый эксперт по ИТ и информационной безопасности, опубликовал на Хабре разбор архитектуры ИИ-агентов, объясняющий, почему типовое…
Рекордное IPO Anthropic на $81,3 млрд: акционеры не смогут сместить основателей
Anthropic вышла на биржу с крупнейшим в истории первичным размещением акций, обойдя SpaceX, и именно сейчас её репутация «хорошего парня» в ИИ попадает под…
Комментарии