
Обработка резюме нейросетью: как разобрать 400 откликов за вечер на российском API
Когда в день на одну вакансию приходит 400 резюме, обработка резюме нейросети превращается из эксперимента в рабочий инструмент, и вот конкретный способ собрать такой конвейер на российском API за один вечер.
Впервые на русскоязычном рынке появился облачный каталог моделей (FMC от Selectel) с эндпоинтом, который позволяет встроить обработку резюме нейросети прямо в Python-скрипт, без аренды GPU и без ручной настройки инференса.
Роман Шубин, CTO и автор Telegram-канала «Bash Days», опубликовал пошаговый кейс: он взял модель T-pro-it-2.1 из каталога FMC (Foundation Model Catalog, облачный каталог языковых моделей от Selectel), загрузил пачку PDF-резюме и получил на выходе таблицу с баллами и доказательствами по каждому критерию вакансии. Финальное решение о найме остаётся за человеком. Модель не отправляет отказы, не оценивает фото или возраст. Она только сопоставляет профессиональный опыт из документа с требованиями конкретной позиции.
Что понадобится?
- Python 3.10+ и библиотека для извлечения текста из PDF (например, PyMuPDF или pdfplumber)
- Доступ к FMC от Selectel (на момент публикации источника сервис находится на стадии public preview, инференс (обработка запросов моделью) работает синхронно)
- Модель T-pro-it-2.1 из каталога FMC (русскоязычная модель, хорошо работает с техническими терминами на английском)
- YAML-файл с описанием вакансии, критериями и шкалой оценки (пример ниже)
- Резюме в PDF (столько, сколько нужно разобрать)
- Время: базовый конвейер собирается за один вечер, 2-4 часа
Как устроен конвейер?
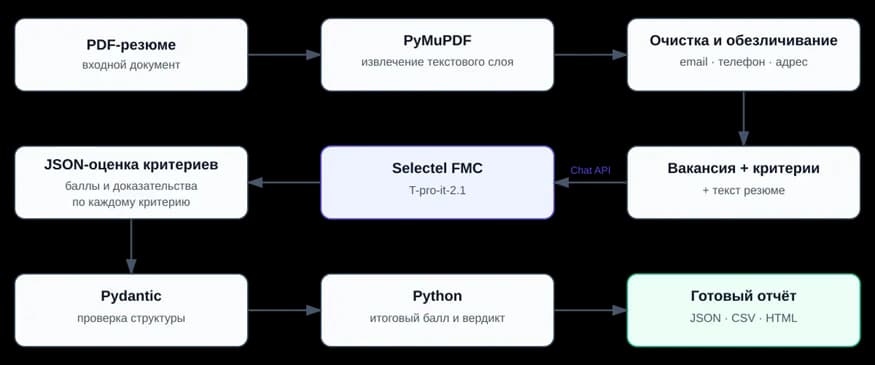
Архитектура простая: модель стоит в середине цепочки и решает ровно одну задачу. Всё остальное делает обычный код.
- Python извлекает текст из PDF
- Скрипт отправляет в модель три вещи: описание вакансии, список критериев и текст резюме
- Модель возвращает структурированный JSON с оценкой по каждому критерию
- Python считает итоговый балл (модель этого не делает, иначе одни и те же оценки критериев могут дать то 78, то 83 балла)
- Результаты собираются в таблицу для HR
Ключевой принцип: модель не открывает файл, не выполняет команды, не меняет статус кандидата в кадровой системе. Она только анализирует текст.
Как описать вакансию для модели?
Вакансию и критерии автор оформляет как YAML-файл. Вот сокращённый пример для позиции Middle DevOps:
id: middle-devops
title: Middle DevOps инженер
scoring_scale:
  0: Подтверждений в резюме нет
  1: Технология только упомянута
  2: Есть базовый практический опыт
  3: Есть самостоятельный production-опыт
  4: Есть сложный опыт или измеримый результат
criteria:
  - id: linux_production
    title: Администрирование Linux в production
    required: true
    weight: 20
  - id: automation
    title: Автоматизация конфигурации
    required: true
    weight: 15
  - id: containers
    title: Работа с контейнерами
    required: true
    weight: 15
Каждый критерий имеет вес, флаг обязательности и список ожидаемых подтверждений (Ansible, Docker, CI/CD-пайплайны и так далее). Модель оценивает уровень от 0 до 4, а Python умножает оценку на вес.
Почему именно T-pro-it-2.1?
Автор выбрал эту модель по трём причинам.
Входные данные русскоязычные, но в резюме постоянно встречаются английские названия технологий, команды и аббревиатуры. Модель справляется с этим миксом.
От неё требуется не творческий текст, а строгое следование инструкции: обработать список критериев, не придумывать отсутствующий опыт, привести доказательства из текста и вернуть валидный JSON.
В каталоге FMC на момент тестирования также доступны T-lite, Qwen, Gemma и другие модели формата текст-в-текст.
Что модель выдаёт на практике?
На вход подали текст резюме кандидата и YAML с критериями вакансии DevOps-инженера. Вот фрагмент ответа модели:
Критерий: CI/CD
Уровень: 4 из 4
Доказательства:
— Разработал GitLab CI pipeline для сборки,
  тестирования и развертывания 18 сервисов.
— Сократил время деплоя с 35 до 12 минут.
Если подтверждения в тексте нет, модель пишет: «В тексте резюме подтверждение не найдено». Она не додумывает опыт кандидата. Вместо папки с 400 PDF на выходе получается таблица, где по каждому кандидату видны баллы, а по каждому баллу приведены конкретные цитаты из резюме.
- Доверять модели итоговый балл. Если модель сама складывает оценки, одинаковые входные данные могут давать разные суммы. Считайте в Python.
- Давать модели доступ к файлам или кадровой системе. Модель должна работать только с текстом. Все «опасные» операции остаются в коде.
- Загружать PDF «как есть» в чат-интерфейс. Это не автоматизация. Без API и скрипта вы не обработаете 400 резюме за вечер.
- Ожидать, что модель оценит soft skills или «потенциал». Она сопоставляет текст с критериями. Если в резюме нет конкретного опыта, балл будет 0, и это правильно.
- Забывать про галлюцинации (когда модель уверенно выдумывает то, чего не было). Проверяйте выборочно: открывайте исходное резюме и сверяйте доказательства.
Что делать с этим прямо сейчас?
HR-специалисту и рекрутеру. Если вы получаете больше 30 откликов в день, попросите разработчика или техлида собрать такой конвейер. Вы получите не «рекомендацию нейросети», а структурированную выжимку с цитатами, которую проверяете сами.
Автору Дзена, пишущему про карьеру и HR. Это готовый кейс для контента: обработка резюме нейросети на российской инфраструктуре, без зарубежных API, с конкретными шагами. Разберите пример для своей аудитории.
Предпринимателю и руководителю в РФ. FMC работает в московском дата-центре Selectel, данные не уходят за рубеж. Это аргумент для компаний, где важна локализация. Сервис пока в стадии public preview: загрузка собственных моделей в каталог ещё не поддерживается.
Подход Шубина ценен не моделью, а архитектурой. Модель делает только одно: извлекает факты из текста и раскладывает по полочкам. Весь контроль, математика, финальное решение, в руках человека и в коде. Это именно тот уровень доверия к ИИ, который я считаю рабочим на сегодня. Честная оговорка: на стадии public preview стоит закладывать время на возможные ограничения API. И выборочная проверка ответов модели обязательна, особенно на первых ста резюме, пока вы не убедитесь, что промпт (инструкция для модели) настроен точно.
Четыреста резюме за вечер вместо двух недель. Не потому что модель «умнее» рекрутера, а потому что рутину чтения и разметки она берёт на себя, а решение остаётся за тем, кто понимает контекст.
Научитесь работать с нейросетями на практике
В dzen.guru мы разбираем реальные кейсы автоматизации и помогаем авторам встроить ИИ в рабочие процессы.
Узнать больше
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
System One модель Jev не генерирует текст: один бит решения за миллисекунды вместо секунды
Jev выпустила 15 сентября 2026 года модель, которая не генерирует текст, а возвращает вероятностное распределение по заданным вариантам, и это ставит вопрос:…
Премьер Греции признал: политика страны не поспевает за искусственным интеллектом
Греция пытается стать новым домом для ИИ-индустрии, но её премьер-министр Кириакос Мицотакис, выступая перед 250 основателями и инвесторами в Сан-Франциско,…
Text to speech нейросеть Gemini создаёт голоса по описанию: 2000 тембров и 100 языков
Google представила две модели text to speech на базе Gemini 3.8 Flash, которые превращают голосовой синтез из набора готовых голосов в полноценную творческую…
Комментарии