
NYT обвинила OpenAI в осознанном нарушении авторских прав: иск идёт на миллиарды
NYT подала расширенные обвинения против OpenAI 2 июня 2025 года, заявив, что сотрудники компании осознанно копировали миллионы защищённых статей ради коммерческой выгоды и использовали обманные методы доступа к платному контенту.
Впервые в судебном процессе всплыли внутренние свидетельства: юристы NYT ссылаются на слова сооснователя OpenAI Грега Брокмана о «несметных богатствах» от коммерциализации ИИ и на реакцию «А, здорово» на способ бесплатно извлекать платные статьи, а это подрывает главный аргумент OpenAI о «добросовестном использовании».
Дело началось в 2023 году: The New York Times подала иск против OpenAI, создателя ChatGPT, за нарушение авторских прав. Газета утверждает, что компания использовала её статьи для обучения языковых моделей (больших нейросетей, которые генерируют текст), а бот затем мог «воссоздавать» эти тексты в ответах пользователям. Сейчас к иску присоединились другие издатели: New York Daily News, The Center for Investigative Reporting, Raw Story и The Intercept. Дела объединены в одно производство, общая сумма требований, по данным Financial Times, исчисляется «миллиардами» долларов.
| Что | Когда | Кто подал иск | Ответчик |
|---|---|---|---|
| Расширенные обвинения в осознанном нарушении авторских прав | Исходный иск подан в 2023 году, новые аргументы представлены в ходе текущего разбирательства | The New York Times и присоединившиеся издатели | OpenAI |
Какие новые аргументы появились в деле?
-
Осознанность нарушения. Юристы NYT утверждают, что сотрудники OpenAI понимали «экзистенциальную угрозу», которую их технологии несут издателям, но всё равно скопировали миллионы статей, защищённых авторским правом.
-
Мотивация деньгами. По данным FT, юристы газеты ссылаются на записи Грега Брокмана 2017 года, в которых он «писал», что его мотивируют «несметные богатства» от коммерциализации ИИ-моделей. Источник этой цитаты в материалах FT при этом не указан.
-
Обманные методы сбора данных. NYT заявляет, что OpenAI применяла «нарушающие правила и обманные» способы для получения доступа к платному контенту. Когда один из сотрудников рассказал Брокману о способе бесплатно извлекать статьи NYT, тот ответил: «А, здорово».
-
Свидетельство изнутри Microsoft. Юристы привели слова Брента Хехта, директора Microsoft по прикладным наукам, который назвал обучение моделей на защищённом контенте «поразительной кражей беспрецедентных масштабов». Microsoft заявила, что эти цитаты «отражают личную точку зрения одного сотрудника, а не юридическую оценку» компании.
-
Позиция Сатьи Наделлы. Гендиректор Microsoft в показаниях заявил: если бы он знал о незаконном использовании платного контента со стороны OpenAI, то потребовал бы «переобучить модели». Такое право, по его словам, было у Microsoft по условиям соглашения между компаниями.
Как OpenAI защищается?
Компания настаивает, что обучение ИИ на журналистских материалах представляет собой «добросовестное использование» (fair use, правовая доктрина в США, которая разрешает ограниченное использование защищённых произведений без согласия автора) общедоступных текстов и не нарушает закон.
Эта позиция теперь выглядит уязвимее. Если суд примет аргументы о том, что сотрудники OpenAI осознавали нарушение и применяли обманные методы, довод о «добросовестности» потеряет юридическую силу: добросовестное использование предполагает, что использующий действует открыто и без умысла причинить вред правообладателю.
Какое отношение это имеет к авторам в России?
Тема OpenAI и авторских прав касается не только американских издателей. Обучающие данные (training data, массивы текстов, на которых тренируют нейросети) для языковых моделей собирают по всему интернету, включая русскоязычные площадки.
-
Автору Дзена стоит следить за итогом дела: если суд установит, что копирование контента для обучения нейросетей незаконно без лицензии, это создаст прецедент, на который смогут ссылаться авторы в других юрисдикциях, включая Россию.
-
Маркетологу и контент-менеджеру полезно понимать, какие аргументы работают: NYT доказывает не просто факт копирования, а осознанный коммерческий умысел. Это принципиально: «мы не знали» перестаёт быть защитой, когда есть внутренняя переписка.
-
Предпринимателю в РФ и СНГ, который использует ChatGPT или российские аналоги (YandexGPT, GigaChat) для генерации текстов, важно помнить: если модель «воссоздаёт» чужую статью в ответе, ответственность за публикацию этого текста несёт тот, кто его размещает.
Российское законодательство пока не имеет прямого аналога доктрины fair use. Гражданский кодекс РФ защищает авторские права жёстче: любое воспроизведение без согласия правообладателя, как правило, незаконно. Как именно YandexGPT и GigaChat решают вопрос лицензирования обучающих данных, компании публично не раскрывали.
На мой взгляд, дело NYT против OpenAI перешло из категории «принципиальный спор» в категорию «конкретные доказательства». Цитаты про «несметные богатства» и ответ «А, здорово» на способ обхода платного доступа выглядят плохо для любого суда присяжных.
Оговорка: суд ещё не вынес решения, а цитата Брокмана приведена юристами NYT без указания первоисточника. Пока это аргументы одной стороны.
Что сделать автору сегодня: проверьте, может ли ChatGPT или другая нейросеть воспроизвести фрагменты ваших опубликованных текстов. Задайте промпт (запрос к нейросети) с темой вашей статьи и сравните ответ с оригиналом. Если совпадение заметно, сохраните скриншот. Когда прецедент будет установлен, у вас будет доказательная база.
Частые вопросы
Может ли NYT выиграть дело?
Исход зависит от того, признает ли суд, что обучение моделей OpenAI на статьях не подпадает под доктрину fair use. Новые аргументы NYT об осознанности нарушения и обманных методах сбора данных существенно усиливают позицию газеты, но решения пока нет.
Касается ли это российских авторов напрямую?
Напрямую американский суд не создаёт обязательств для российских компаний. Но прецедент повлияет на мировую практику: если OpenAI проиграет, другие разработчики, включая российских, окажутся под давлением лицензировать контент для обучения моделей.
Можно ли запретить нейросети использовать мой текст?
Технически можно добавить в файл robots.txt запрет на сканирование для ботов OpenAI (GPTBot) и других. Практически это не гарантирует защиту: многие тексты уже попали в обучающие данные до появления таких запретов.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Робот Figure 02 в новостях сегодня: успешность уборки в незнакомых домах выросла с 9% до 56%
Робот Figure 02 попал в новости сегодня благодаря обновлению, которое позволяет гуманоиду убираться в незнакомых квартирах: стартап Figure протестировал модель…
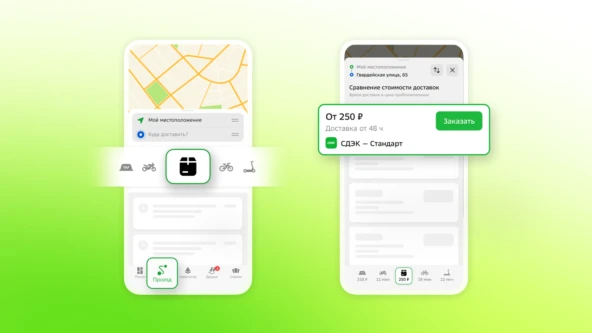
2ГИС добавил доставку на экран маршрута: СДЭК, «Яндекс» и versta на одном экране
2ГИС встроил в экран маршрута раздел «Доставка», где можно сравнить цены и сроки СДЭК, «Яндекс Доставки» и versta.io, и сразу перейти к оформлению заказа в…
Утечка данных Revolut: мошенники использовали реальный домен госведомства
Финтех-сервис Revolut подтвердил утечку персональных данных клиентов после того, как мошенники отправили поддельные запросы с настоящего почтового домена…
Комментарии