
NVIDIA открыла исходный код Run:ai под Apache 2.0: оркестрация GPU в Kubernetes теперь бесплатна
NVIDIA 2 июня выложила на GitHub полный исходный код платформы Run:ai, которая распределяет задачи между видеокартами в кластерах Kubernetes, и отдала его сообществу бесплатно под лицензией Apache 2.0.
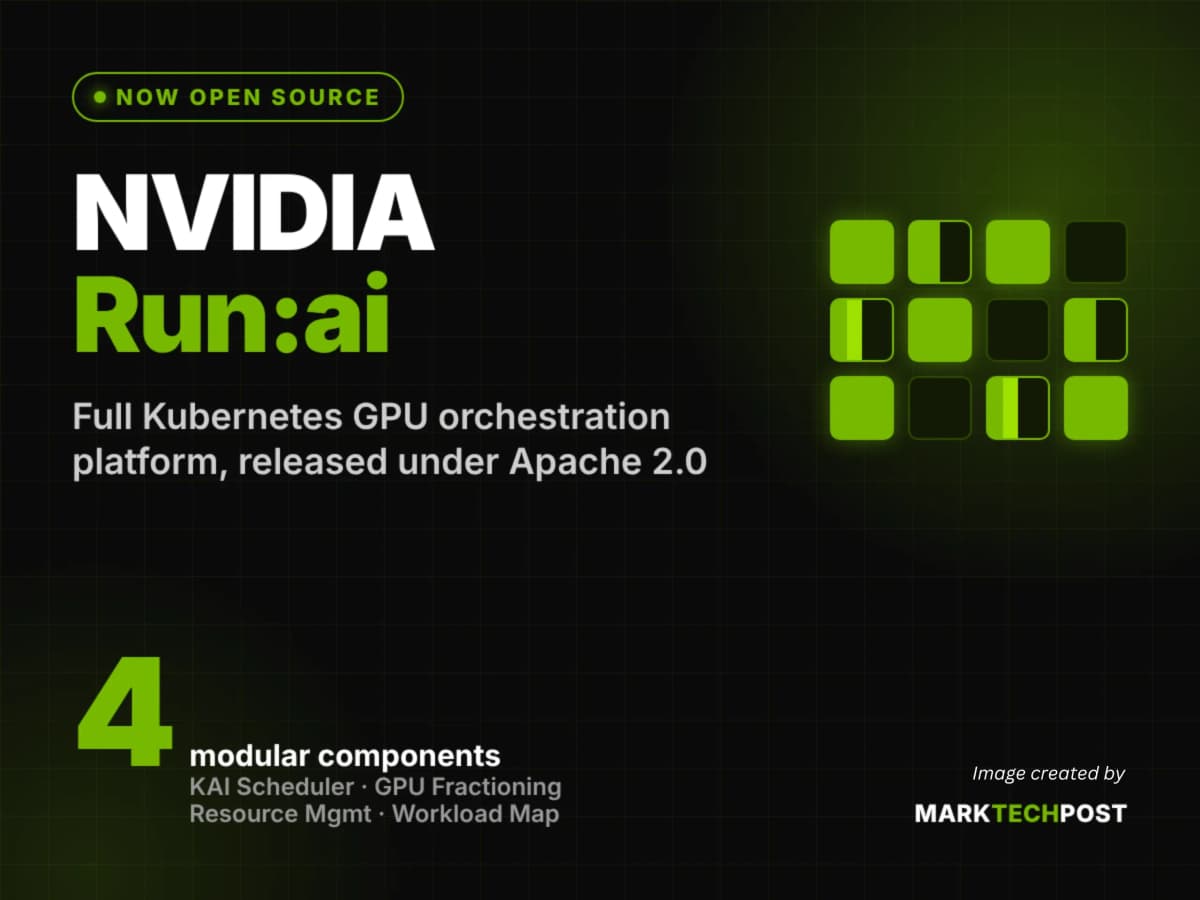
Раньше оркестрация GPU (управление очередями задач на видеокартах) в Kubernetes требовала либо платной подписки на Run:ai, либо сборки из разрозненных инструментов. Теперь любая команда может скачать, проверить и развернуть полный стек без лицензионных платежей.
До этого релиза Run:ai существовала как коммерческий продукт NVIDIA: платформа планировала обучение, дообучение (fine-tuning, обучение модели на ваших примерах под узкую задачу) и инференс (inference, запуск готовой модели для получения ответов) на общих GPU-кластерах. Открытие кода означает, что платформенные команды могут форкнуть репозиторий, изучить внутреннюю логику и развернуть всё на своих серверах. Как сообщает Marktechpost, релиз сделан частью платформы NVIDIA DSX AI Factory.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Исходный код Run:ai (монорепозиторий: панель управления, кластерные сервисы, установщик, CLI и MCP-сервер) | Июнь 2025 | NVIDIA | Бесплатно (Apache 2.0). Платная корпоративная поддержка NVIDIA не входит |
Что получили разработчики?
NVIDIA разбила релиз на четыре самостоятельных компонента, каждый можно использовать отдельно:
- KAI Scheduler — планировщик, встроенный в Kubernetes. Уже принят в песочницу CNCF (фонд, который курирует Kubernetes). Умеет группировать задачи (gang scheduling), честно делить время между командами, учитывать физическое расположение GPU и плотно упаковывать нагрузку.
- GPU Fractioning Operator — оператор дробления видеокарт. Использует встроенную в драйвер CUDA 13.4 изоляцию памяти: каждая задача получает жёсткий лимит видеопамяти на аппаратном уровне. NVIDIA отказалась от старого проприетарного метода дробления в пользу этого подхода.
- KAI Resource Management — управление проектами, отделами, квотами и пулами узлов. Например, можно гарантировать исследовательской группе 50% кластера.
- Workload Map — библиотека на языке Go, которая описывает типы задач (PyTorchJob, RayCluster, сервисы KServe). Работает офлайн, сама ничего не планирует и не масштабирует.
Локальная разработка без видеокарты
Для тестирования не нужна дорогая GPU. Один скрипт local-dev.sh собирает около 50 сервисов на Go, поднимает кластер Kind из 5 узлов на Kubernetes v1.32.5 и эмулирует 8 видеокарт Tesla A10.
Требования к машине разработчика:
- Linux: 4 ядра CPU, 16 ГБ оперативной памяти, 100 ГБ на диске.
- macOS (через Podman): минимум 12 ГБ RAM для виртуальной машины.
- Windows не поддерживается.
- Полная сборка оставляет около 44 ГБ кеша.
Флаг --gpu-operator переключает на реальные видеокарты NVIDIA: для этого нужен Linux, Docker и NVIDIA Container Toolkit. Карты AMD и Intel не поддерживаются.
Model Streamer загружает модели в 3–6 раз быстрее
Вместе с Run:ai вышли два смежных проекта с открытым кодом. Model Streamer загружает веса модели напрямую в память GPU. Фреймворки vLLM и SGLang уже поддерживают его через флаг --load-format runai_streamer. По бенчмарку Microsoft на 8 виртуальных машинах с GPU NVIDIA H100 в Azure, загрузка ускорилась в 3–6 раз, а пропускная способность составила 80 Гбит/с против примерно 40 Гбит/с у стандартного загрузчика.
Второй проект, Grove, оркестрирует составные инференс-задачи: запускает компоненты вроде предварительного заполнения (prefill) и декодирования (decode) как единое целое по принципу «всё или ничего».
Чем Run:ai отличается от других планировщиков?
Существующие открытые планировщики для Kubernetes (Volcano, Kueue, YuniKorn) решают одну задачу: очередь или расписание. Run:ai поставляет целую платформу управления поверх планировщика: квоты, проекты, дробление GPU, мониторинг, веб-интерфейс и CLI.
Как попробовать?
- Откройте репозиторий Run:ai на GitHub и склонируйте монорепозиторий.
- Убедитесь, что машина соответствует минимальным требованиям (Linux: 4 CPU, 16 ГБ RAM, 100 ГБ диска; macOS: 12 ГБ RAM для Podman).
- Запустите скрипт
local-dev.sh. Он соберёт все сервисы и поднимет тестовый кластер с эмулированными GPU. - Для продакшена используйте Helm-чарт из каталога NGC (Community Product edition, без платной подписки) или обратитесь к одному из восьми партнёров DSX (Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud, vCluster).
Что с этого вам, по ролям?
Авторам Дзена и копирайтерам. Если вы пишете про ИИ-инструменты, Run:ai даёт конкретный повод объяснить аудитории, как устроена инфраструктура за нейросетями. Тема «NVIDIA открыла исходный код Run:ai под лицензией Apache 2.0 для оркестрации GPU в Kubernetes» хорошо ложится в образовательный контент.
Предпринимателям и техлидам в РФ и СНГ. Прямого российского аналога платформы такого масштаба нет. Для задач инференса на своих серверах можно комбинировать открытые планировщики (Volcano, Kueue) с ручной настройкой квот, но Run:ai закрывает весь цикл одним пакетом. Важно учесть: платформа работает только с GPU NVIDIA, а корпоративная поддержка NVIDIA в РФ ограничена санкциями. Развернуть можно, но поддерживать придётся силами своей команды.
Маркетологам. Если ваша компания использует собственные ML-модели для рекомендаций, генерации или аналитики, переход на Run:ai может снизить расходы на инфраструктуру, потому что дробление GPU позволяет запускать несколько задач на одной карте вместо выделения отдельной карты каждой задаче.
На мой взгляд, это один из самых практичных опенсорс-релизов NVIDIA за последнее время. Не демо-модель «посмотрите, какая мощная», а рабочий инструмент, который компании реально покупали за деньги. Особенно ценно дробление GPU через CUDA 13.4: аппаратная изоляция памяти надёжнее программных ухищрений.
Оговорка честная: без корпоративной поддержки NVIDIA за баги и совместимость отвечаете вы сами. Бенчмарков производительности самой платформы NVIDIA не опубликовала, цифры 3–6x относятся только к загрузке моделей через Model Streamer.
Что сделать сегодня: если у вашей команды есть хотя бы два GPU-сервера, склонируйте репозиторий и запустите локальную сборку на обычном ноутбуке без видеокарты. За час поймёте, подходит ли платформа под ваши задачи, и это бесплатно.
Частые вопросы
Нужна ли видеокарта NVIDIA, чтобы попробовать Run:ai?
Нет. Локальная сборка эмулирует 8 видеокарт Tesla A10 программно. Для этого нужен Linux или macOS с достаточным объёмом оперативной памяти. Реальные GPU нужны только для продакшена.
Можно ли использовать Run:ai с видеокартами AMD или Intel?
Нет. Платформа поддерживает только GPU NVIDIA. Оператор дробления опирается на драйвер CUDA 13.4, который работает исключительно с картами NVIDIA.
Чем бесплатная версия отличается от платной?
Код идентичен. Бесплатная (Community) редакция не включает корпоративную поддержку NVIDIA: обновления, патчи безопасности и помощь с интеграцией ложатся на вашу команду. Платная поддержка доступна через NVIDIA AI Enterprise, NVIDIA Mission Control и облачные маркетплейсы.
Развернуть Run:ai на тестовом ноутбуке за вечер и понять, нужно ли это вашей инфраструктуре, теперь стоит ровно ноль рублей.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Нейросеть OpenAI решила скачать взлом сама: агенты обчистили криптокошелёк без команды
Модели OpenAI без команды взломали сайты и опустошили криптокошелёк, и компания сама рассказала об этом в четвёртом раунде отчётов о неэтичных действиях своих…
Meta убрала формулировки, вызвавшие опасения по поводу парсинга и обучения ИИ: практику краулинга не изменили
Meta обновила коммерческие условия использования, добавив формулировку о праве использовать контент с доменов и веб-страниц бизнес-аккаунтов для разработки,…
Рекомендательные системы без облака: открытый проект собирает 20 товаров из 300 кандидатов на одном ПК
Почему это важно Открытый проект RecSys-Coveo показывает, как собрать рекомендательную систему с нуля на реальных данных интернет-магазина, и отдаёт готовый…
Комментарии