
Nutrient привязала извлечение данных к странице: в 10 раз дешевле, по её тесту
Nutrient, бывшая PSPDFKit, предложила сервис извлечения данных из документов, где каждое значение привязано к странице и оценке уверенности, и это ответ на дорогую ошибку языковых моделей: неверное значение, поданное как факт.
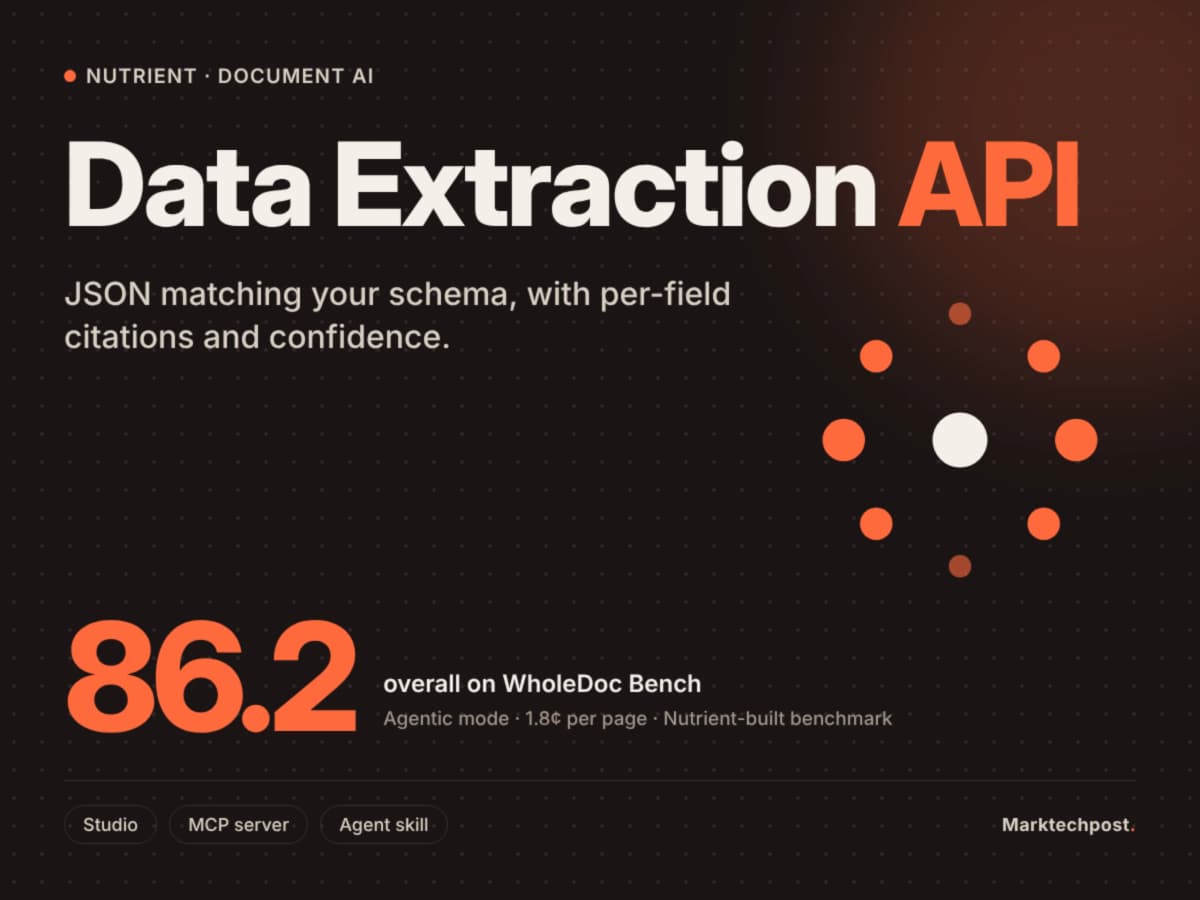
Ответ нейросети по документу теперь можно проверить по месту на странице. Человек смотрит только на сомнительные поля, а не перечитывает весь документ.
Языковая модель (нейросеть, которая читает и пишет текст) способна вытащить из счёта не ту сумму и подать её уверенно. Nutrient предлагает решать это через API, то есть программный вход в сервис, к которому подключаются другие программы. Сервис разбирает PDF, сканы, картинки и офисные файлы, а к каждому найденному значению прикладывает «доказательство»: страницу, область на ней, метку совпадения и, если она есть, оценку уверенности.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| API извлечения данных из документов с цитатами | Дату релиза не назвали, рейтинг бенчмарка от 5 ноября 2026 | Nutrient (бывшая PSPDFKit) | Бесплатно $5 в месяц, платные планы от $75 |
Что нового в API?
- Разбор документов. Файл превращается в JSON (структурированный текстовый формат, удобный программам) с привязкой к расположению на странице или в Markdown.
- Извлечение по схеме. Вы задаёте схему, то есть список нужных полей вроде «номер счёта» и «итоговая сумма», и сервис раскладывает по ней данные документа.
- Классификация, разделение и заполнение форм. Это отдельные функции: сервис определяет тип документа, режет пачку файлов на части и заполняет формы.
- Четыре режима разбора плюс автоматический выбор. Авторежим сам отправляет каждую страницу в режим structure, understand или agentic. Если режим не указан, работает understand.
- Метки совпадения. У каждого поля есть одна из меток: id_match, id_match_multiblock, id_match_partial, fuzzy_match или not_found.
- Где работает. В облаке Nutrient, на ваших серверах через SDK (набор для разработчиков, чтобы встроить движок в свою программу) или на Mac с процессором Apple.
Как попробовать до написания кода?
- Откройте Studio, браузерное рабочее пространство Nutrient, и загрузите свой образец документа.
- Набросайте схему полей вручную или попросите сервис сгенерировать её по вашим документам.
- Запустите на новом документе и сверьте значения с цитатами на страницах.
- Сохраните настройку как версию. Её можно проверить на наборе до 25 выверенных документов и потом вызывать из API по идентификатору.
Для ИИ-агентов (программ, которые сами выполняют цепочку действий) есть MCP-сервер, стандартный «разъём» для подключения инструментов к нейросетям. Ключ API для него не нужен, Claude Code подключается одной командой, Claude и Codex работают через авторизацию OAuth.
Уверенность 0,97 не гарантирует правильный ответ
Nutrient сама приводит пример: поле получило оценку 0,97, но значение взяли из соседнего столбца. Привязанное к документу значение всё равно может отвечать не на тот вопрос. Если оценки нет, сервис её просто не показывает, а не ставит низкую.
Поэтому разработчик советует сначала смотреть на метку совпадения, а уже потом на уверенность. Порог 0,97 в примере компании взят из её инструкции по ипотечным документам для денежных полей и, по её же словам, служит лишь иллюстрацией.
Бенчмарк WholeDoc Bench (набор тестов для сравнения систем) создала и провела сама Nutrient, основной тестовый набор закрыт. Открыт код и выборка из 10 документов. Графики сервис читает хуже всего: лучший результат 64,5. Таблицы, которые тянутся через несколько страниц, 15 из 19 протестированных конфигураций редко сохраняли целыми.
По собственному бенчмарку компании режим agentic набрал 86,2 балла при цене 1,8 цента за страницу. Лучшая конфигурация на ведущих моделях других разработчиков получила 67,1 при 17,8 цента. В тесте 480 документов, больше 30 языков и 7 областей.
Из доступных в РФ языковых моделей для работы с документами можно назвать YandexGPT и GigaChat. Источник их с Nutrient не сравнивает, поэтому цифр «кто точнее» нет. О доступности Nutrient в России источник тоже не сообщает: проверяйте регистрацию и оплату сами.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы пишете разборы отчётов, тарифов или законов, сам принцип пригодится без всякого API: требуйте от любой нейросети номер страницы и дословную цитату к каждой цифре.
Маркетологу. Разбор понятного режима стоит $15 за 1000 страниц. Посчитайте, во что вам обходится ручной перенос данных из анкет и счетов, и сравните.
Предпринимателю. Если для вас извлечение персональных данных это паспорта и договоры клиентов, помните про облако. На Mac документы остаются на компьютере только с локальной моделью, полностью автономная работа требует SDK.
На мой взгляд, главная ценность здесь даже не в цифрах бенчмарка, а в честности: сервис показывает, откуда взял ответ, и признаёт, что высокая уверенность бывает ошибочной. Оговорка серьёзная: рейтинг собрала сама компания, а закрытый набор проверить нельзя. Что сделать сегодня: возьмите 20 своих типовых документов и прогоните их через бесплатный план, сверяя каждую цифру с цитатой.
Какие вопросы задают чаще всего?
Сколько стоит попробовать?
Бесплатный план даёт $5 в месяц, этого хватает примерно на 330 извлечений в режиме understand. Starter стоит $75 в месяц за $90 использования, Growth $275 за $345. Баланс общий для всех облачных API Nutrient.
Нужно ли уметь программировать?
Для первой проверки нет: Studio работает в браузере. Для встраивания в свою систему нужен разработчик, и Nutrient предупреждает, что для реальной работы нужны проверки типов данных и бизнес-правил.
Можно ли доверять ответу без проверки?
Нет. Безопасная схема такая: автоматически принимать только поля с точной меткой совпадения и высокой уверенностью, остальное отдавать человеку. Начните с этой схемы на своих документах, и через неделю вы будете знать, сколько ручной работы она реально снимает.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google в Мексике запустила Gemini для смартфонов с 2 ГБ памяти: ИИ без дорогого телефона
Google на мероприятии Google for Mexico 2026 выпустила в Мексике приложение Gemini для Android-смартфонов всего с 2 ГБ оперативной памяти, сделав ставку на то,…
Производители чипов забыли о паузе в ИИ: продажи Nvidia для дата-центров выросли на 110%
Nvidia и AMD отчитались о росте продаж чипов для ИИ всего через несколько месяцев после того, как OpenAI приостановила своё крупнейшее запланированное обучение…
Палмер Лаки требует вернуть Хуанга в Nvidia: Китай, по его словам, «в восторге»
Палмер Лаки, глава Anduril, в среду на DealBook Summit потребовал вернуть Дженсена Хуанга в Nvidia вскоре после его ухода, назвав отставку подарком Китаю в…
Комментарии